الملخص:
أعلنت Google اليوم رسميًا عن أحدث إنجازاتها في مجال التفاعل الصوتي الأصلي الشامل، حيث أطلقت جيلًا جديدًا من النماذج الكبيرة للصوت في الوقت الفعلي Gemini 3.8 Live وGemini 3.8 Live Extended Thinking المخصصة للمهام الصعبة.
يمثل هذان النموذجان قفزة كبيرة للأمام في نظام تكنولوجيا الصوت إلى الصوت الأصلي من Google. إنهم لا يدفعون تأخير المحادثة في الوقت الفعلي والطبيعية إلى آفاق جديدة فحسب، بل يحققون أيضًا قدرات تفكير عميقة متعددة الخطوات في التدفقات الصوتية ذات زمن الوصول المنخفض لأول مرة، مما يغير نموذج تطبيق الذكاء الاصطناعي الصوتي تمامًا في السيناريوهات المهنية المعقدة.
في بنية التفاعل الصوتي السائدة السابقة، كانت أنظمة الذكاء الاصطناعي تحتاج عادةً إلى التوصل إلى حل وسط بين "الحوار الضحل سريع الاستجابة" و"التفكير العميق طويل المدى". غالبًا ما تتطلب مواجهة المشكلات الصعبة من المستخدمين تحمل فترات طويلة من الانتظار الصامت. يركز Gemini 3.8 Live الذي أطلقته Google على تحسين المحادثة فائقة السرعة وتجربة تفاعل البث اليومي. يمكن أن يوفر للمستخدمين اتصالًا صوتيًا سلسًا للغاية وفي الوقت الفعلي على المستوى البشري مع تقلبات أكثر حساسية في النغمات والانقطاعات الطبيعية وقدرات فهم السياق. تم إطلاق Gemini 3.8 Live Extended Thinking، الذي تم إطلاقه على أساسه، وتمت ترقيته بشكل أساسي لتدفقات الأعمال المعقدة للغاية. يمنح هذا النموذج الذكاء الاصطناعي القدرة على "التفكير أثناء التحدث" (التفكير أثناء التحدث) في الخلفية، مما يسمح للنظام بإجراء تفكيك منطقي متعدد الخطوات معقد بشكل متزامن، أو تصحيح أخطاء التعليمات البرمجية أو التشخيص الفني في الخلفية مع الحفاظ على حوار متماسك في الوقت الفعلي، دون الحاجة إلى مقاطعة إيقاع المحادثة فجأة عند مواجهة مشكلات صعبة.
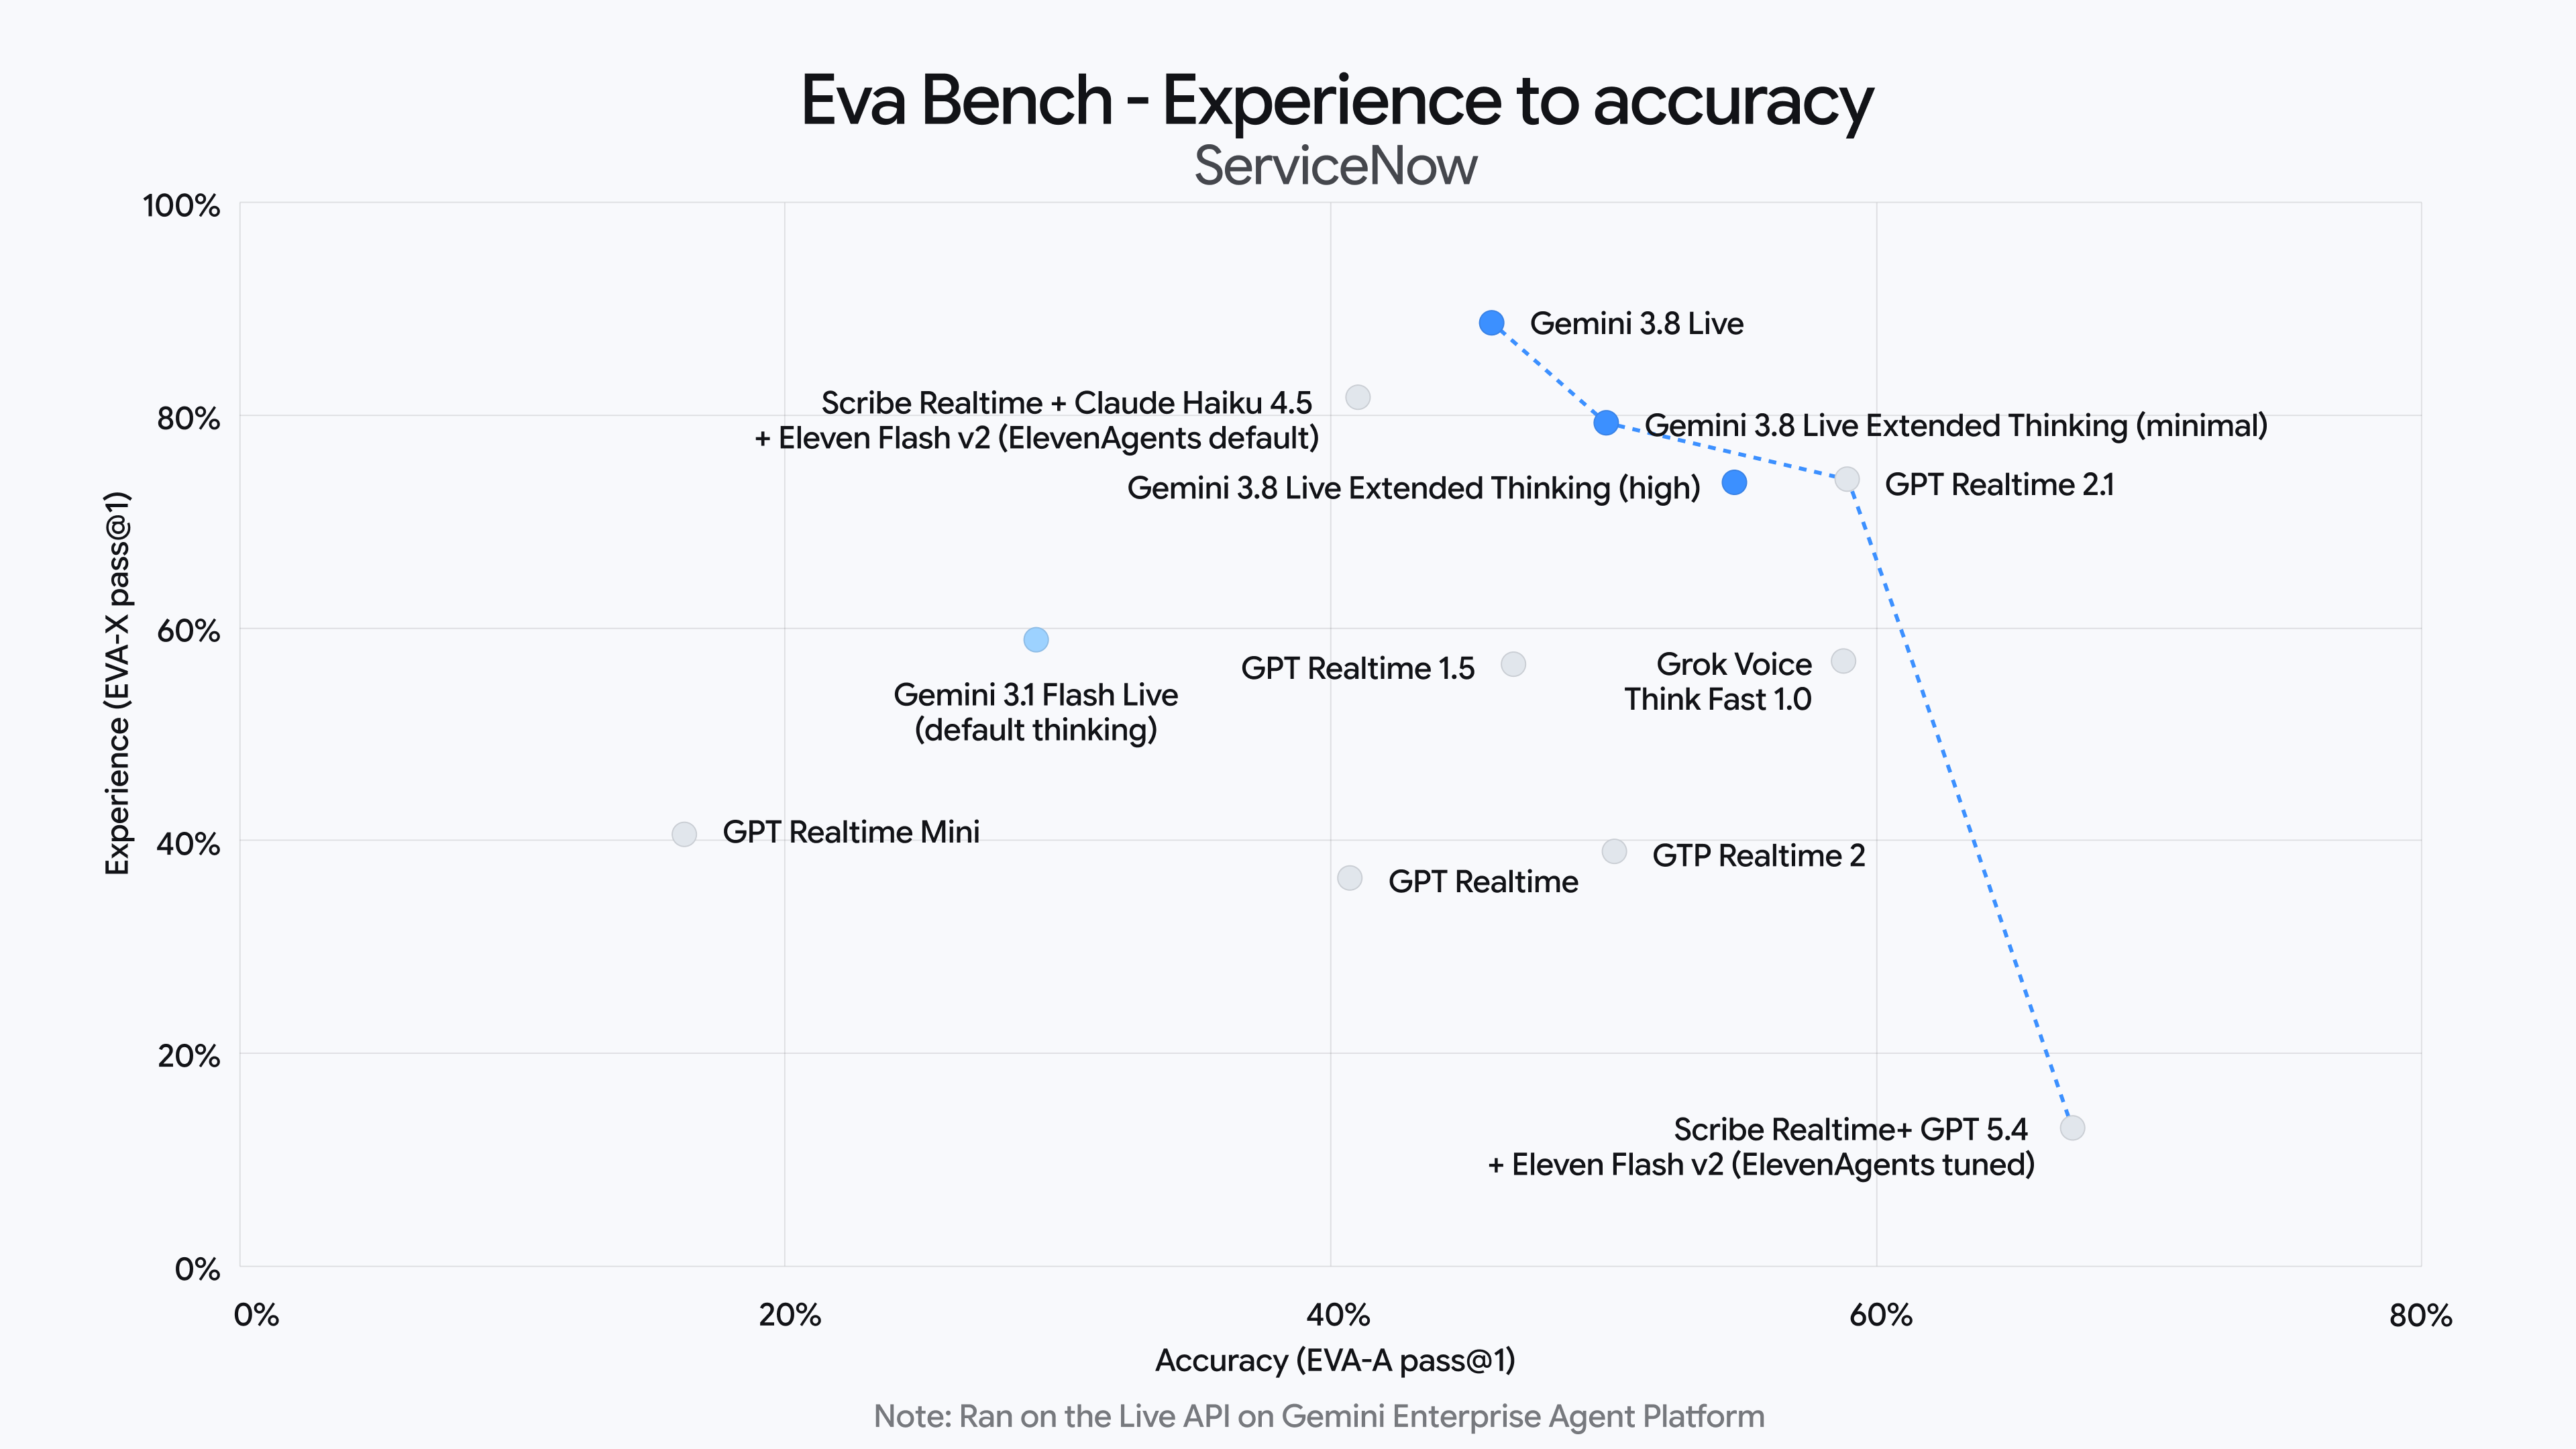
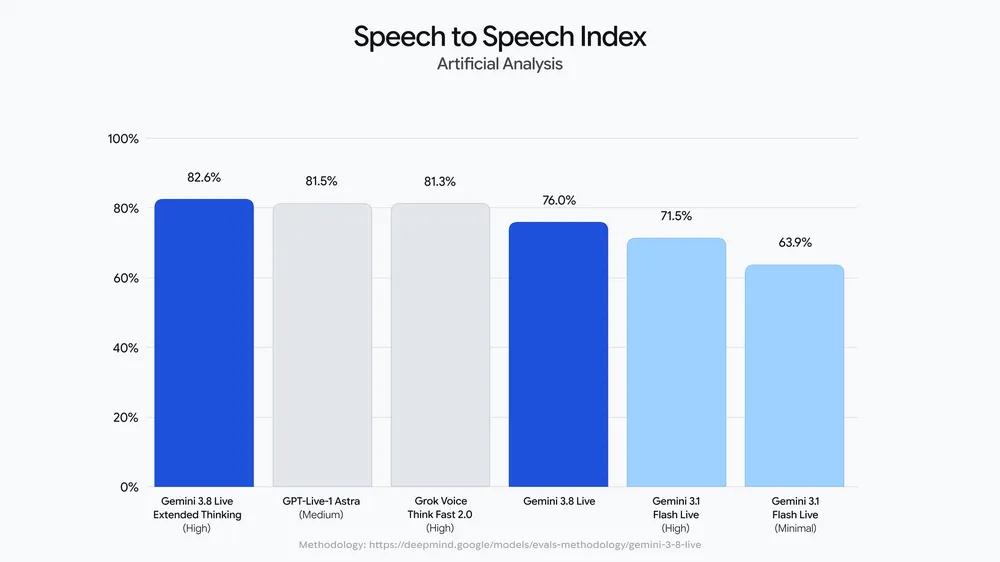
من حيث التطبيق العملي، سيعمل الجيل الجديد من نماذج سلسلة Live على توسيع حدود خدمة المساعدين الصوتيين بشكل كبير. بالإضافة إلى المحادثات الطبيعية اليومية، أظهرت إصدارات Gemini 3.8 Live والاستدلال الموسع أداءً أفضل بكثير من الإصدارات السابقة في السيناريوهات ذات المتطلبات الفكرية العالية مثل استكشاف الأخطاء وإصلاحها في الوقت الفعلي، والاشتقاق الرياضي المعقد، والدروس الخصوصية المتزامنة للغة الأجنبية في الوقت الفعلي، وتنفيذ التعليمات المتدفقة متعددة المهام، لتحتل المرتبة الأولى في معايير صناعة الاستدلال متعدد الوسائط والكلام.
بالنسبة للمطورين ومستخدمي المؤسسات، أعلنت Google أن إمكانات النماذج ذات الصلة ستكون مفتوحة رسميًا للوصول إليها من خلال Gemini API وGoogle AI Studio من الآن فصاعدًا. يمكن للمطورين الاتصال مباشرة بواجهة API الصوتية الأصلية ذات زمن الاستجابة المنخفض للغاية لبناء خدمات وكيل الصوت مزدوج الاتجاه من الجيل التالي بسرعة مع إمكانات تفكير عالية الترتيب في أشكال المنتجات مثل الأجهزة الذكية وخدمة العملاء ومساعدة البرمجة في الوقت الفعلي والمكاتب التعاونية.
التعليقات