الملخص:
إنه جنون. وفي يومين فقط ظهرت 4 موديلات جديدة! في المقدمة، انتهت شركة Lao Ma's xAI للتو من إصدار Grok 4.7. بعد ذلك مباشرة، تخلت OpenAI فجأة عن GPT-6 Sol وLuna، وانخفض السعر إلى النصف. وفي نفس اليوم، طرحت Anthropic أيضًا جهاز Claude Opus 5.5 على الطاولة، وهو أرخص بنسبة 40% من الجيل السابق. في 22 سبتمبر، انتشرت صورة متحركة على موقع X، وحصدت ما يقرب من مليون مشاهدة.
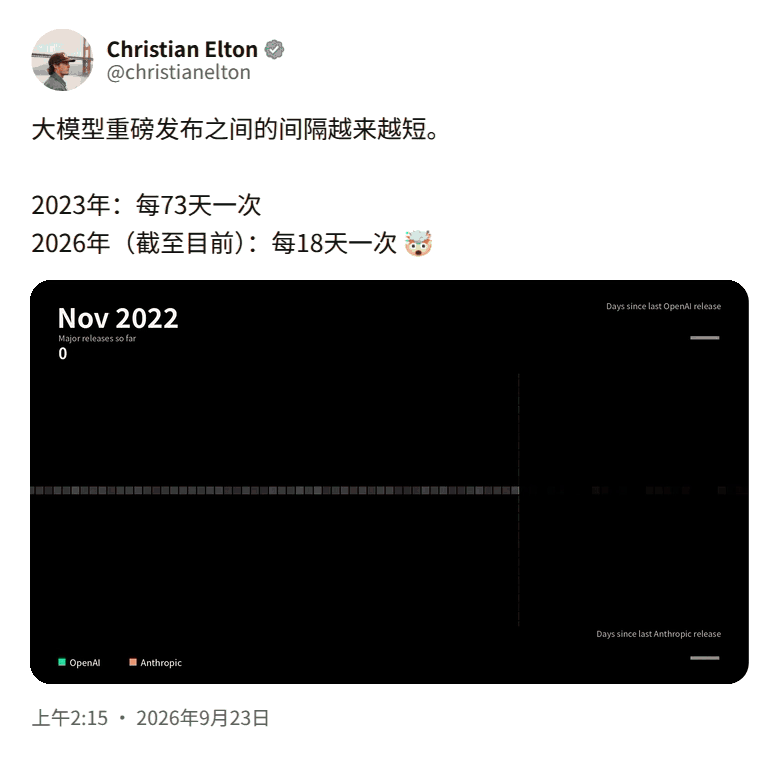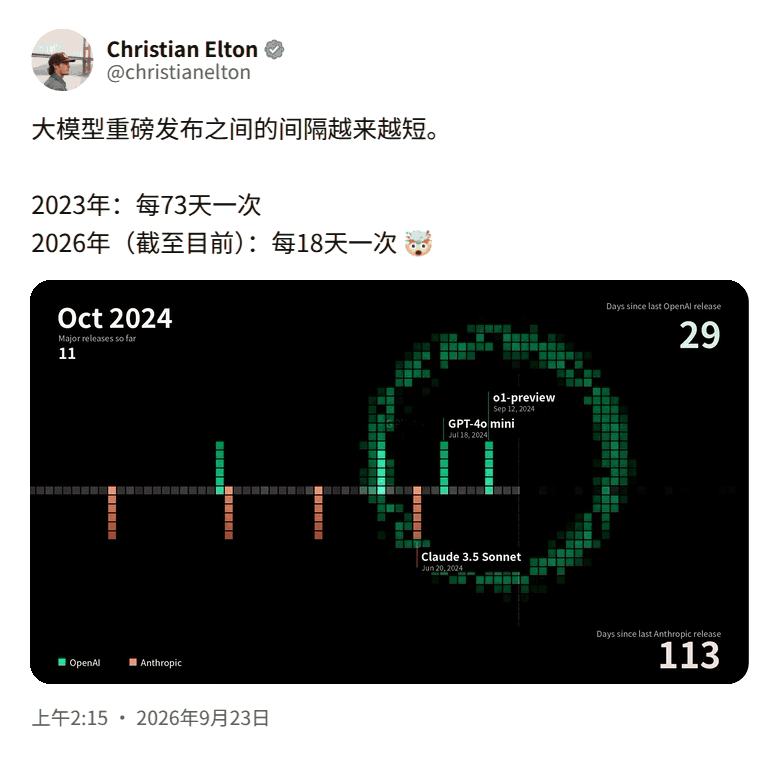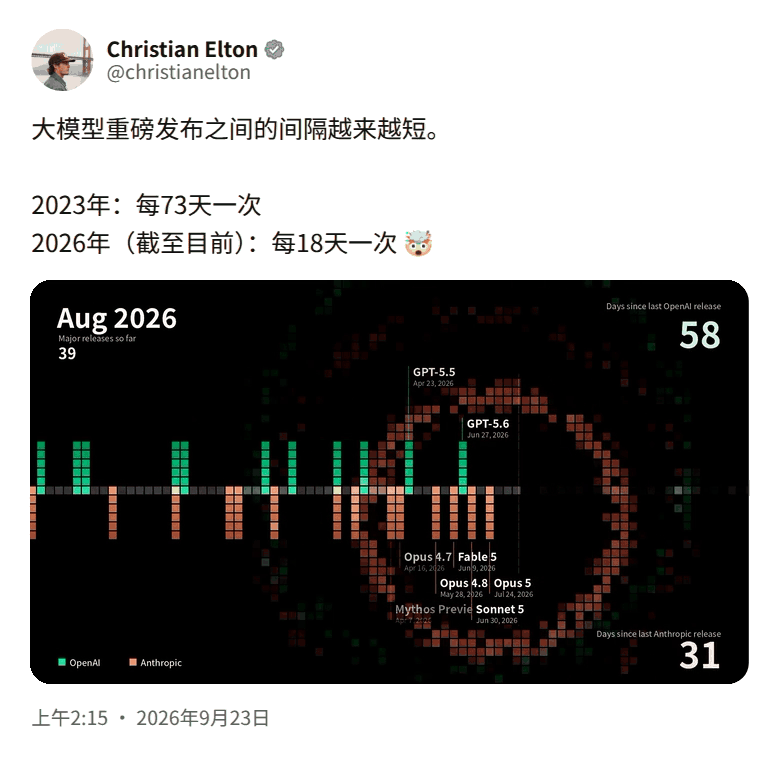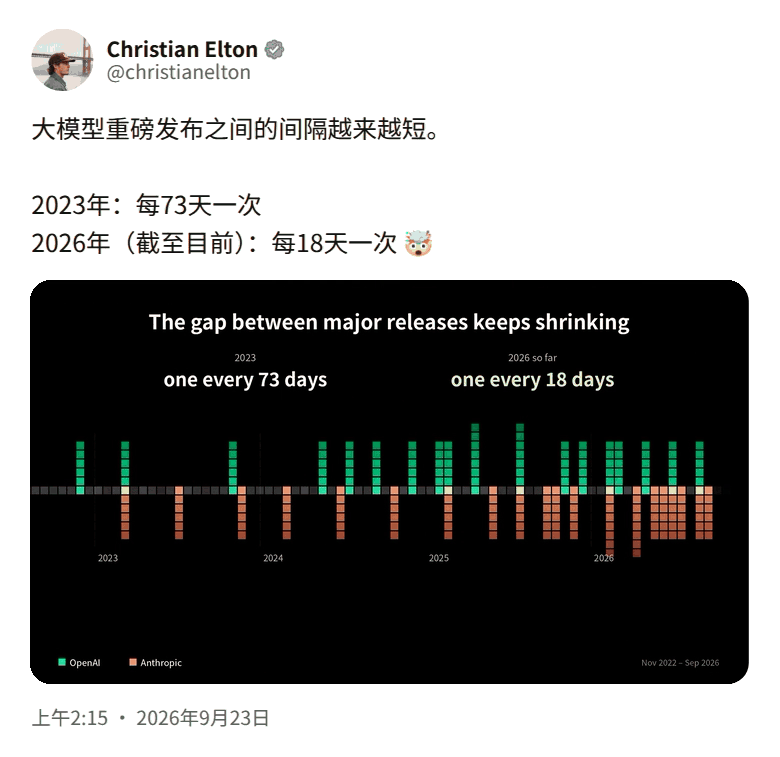
في عام 2023 سيتم تحديث النماذج الكبيرة كل 73 يومًا، وفي عام 2026 سيتم تحديثها كل 18 يومًا.
منذ إطلاق ChatGPT، قامت OpenAI وAnthropic بقصف 42 نموذجًا رائجًا (44 منها بما في ذلك GPT-6 Sol وLuna التي تم إصدارها في ذلك اليوم).
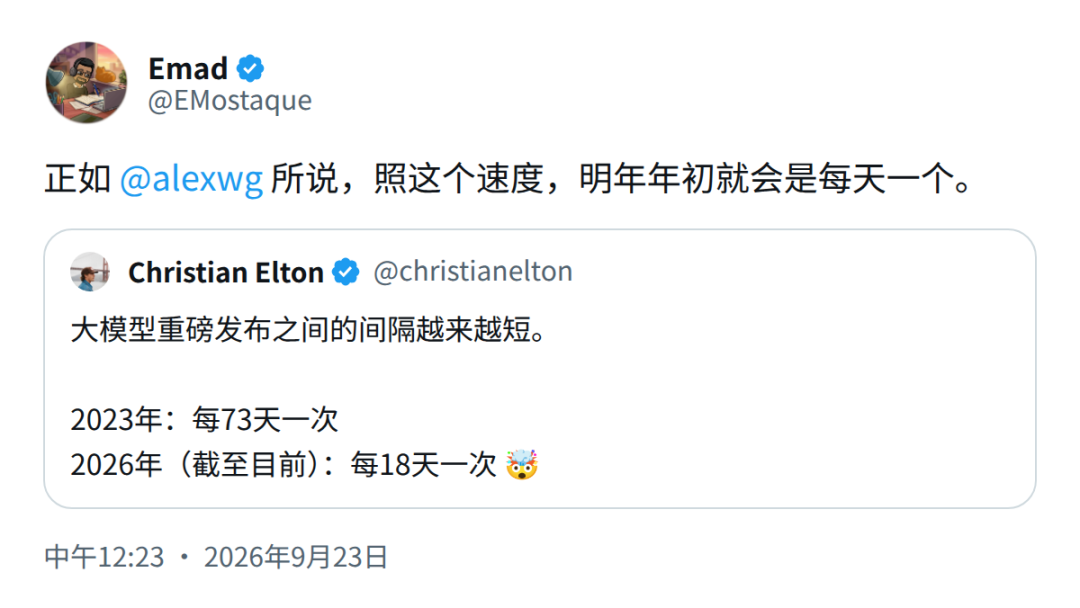
بعد ساعات قليلة، قام مؤسس Stability AI، عماد مشتاق، بإعادة تغريد الصورة وأضاف نبوءة.
"كما قال أليكس، بهذا المعدل، سيكون هناك يوم واحد في بداية العام المقبل."
يقوم عملاقان بإطلاق "تحديث نصف شهري"
في الواقع، يعد عدد "التحديث كل 18 يومًا" متحفظًا للغاية، لأنه لا يشمل سوى OpenAI وAnthropic.
منذ بداية هذا العام وحتى 22 سبتمبر، أصدرت Anthropic 8 نماذج رئيسية، وأصدرت OpenAI 6 نماذج. وقد تم توزيع النماذج الـ 14 على 265 يومًا، بمتوسط 19 يومًا لكل نموذج.
خلال نفس الفترة الزمنية، أصدرت الشركات العشر الكبرى المصنعة للنماذج الكبيرة المحلية ما لا يقل عن 28 طرازًا رئيسيًا آخر، أي بمعدل أكثر من نموذج واحد كل 9 أيام.
كانت هناك أوقات تم فيها إطلاقهما معًا. في الأسبوع الذي سبق عيد الربيع، أطلقت أربع شركات هواتف رائدة جديدة واحدة تلو الأخرى؛ ومن 20 إلى 24 أبريل، تناوبت أربع شركات أخرى في الأيام الخمسة.
بأخذ الجانبين معًا، تظهر سفينة رائدة جديدة في المتوسط أكثر من 6 أيام، وهو ليس بعيدًا عن "واحدة في اليوم" التي ذكرها عماد.
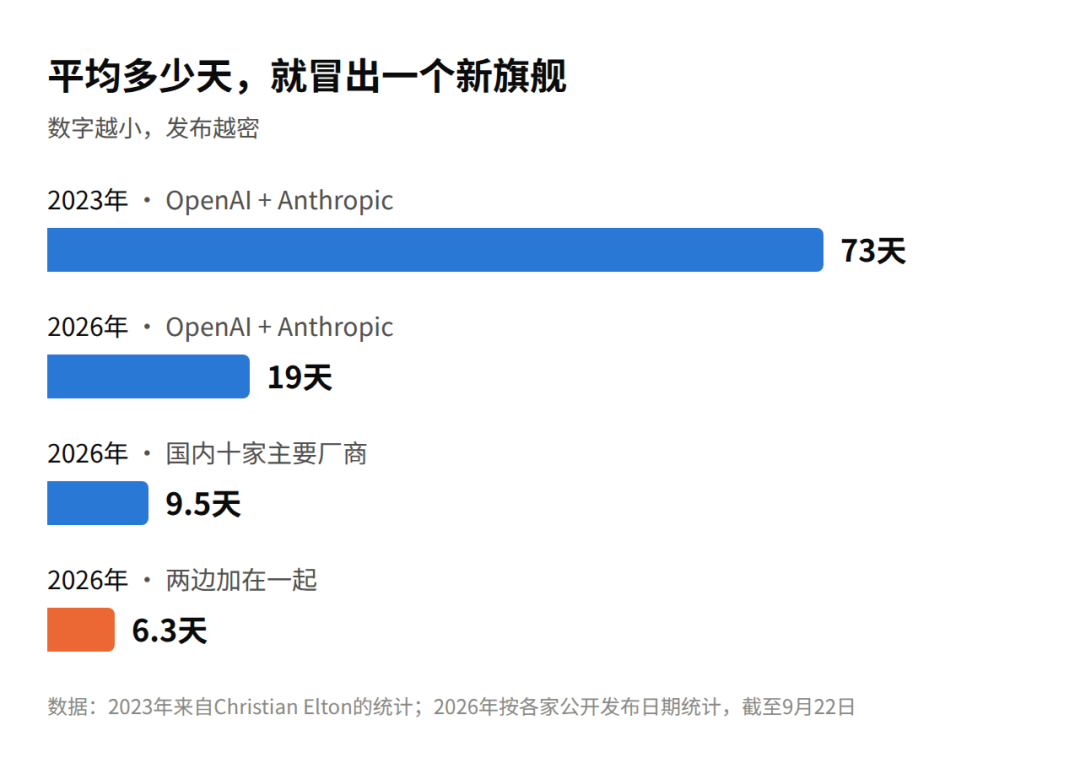
زيادة سرعة الإنسان يمكن رؤيتها بالعين المجردة.
في النصف الأول من العام، استغرق إصدار النموذج 46 يومًا في المتوسط، وفي النصف الثاني من العام، استغرق إطلاق النموذج 26 يومًا. Opus 4.8 هو 28 مايو، Opus 5 هو 24 يوليو، و Opus 5.5 هو 22 سبتمبر.
يتخذ OpenAI طريق "كبح الحركة النهائية ثم سحبها".
قام GPT-6 Astra بتفجير الشبكة بالكامل في 3 سبتمبر، وبعد 19 يومًا فقط، حذت سول ولونا حذوها.
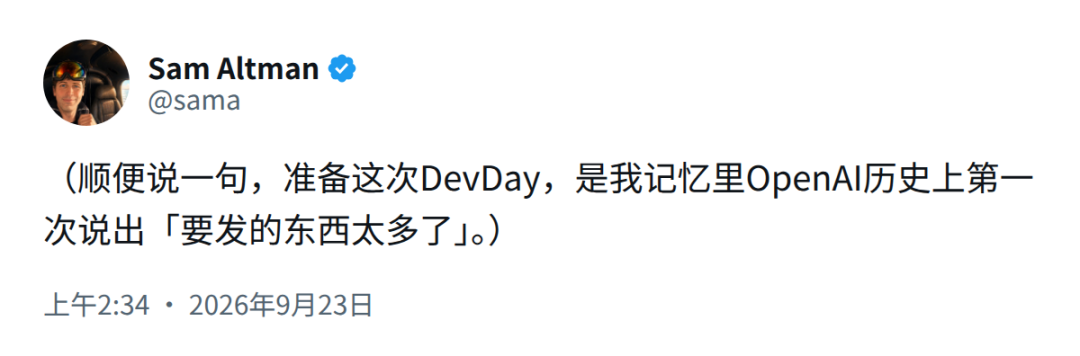
سيعقد مؤتمر DevDay الأسبوع المقبل. أعرب ألتمان عن أسفه لأن هذه هي المرة الأولى في ذاكرته التي صرخ فيها OpenAI "هناك الكثير من الأشياء التي يجب نشرها" عند التحضير لمؤتمر صحفي.
لماذا أصبح النشر أكثر كثافة؟ أعطى الأنثروبي الجواب في تقرير. يساعد الذكاء الاصطناعي بالفعل في إنشاء الجيل القادم من الذكاء الاصطناعي.
في فبراير من هذا العام، تمكن كلود بشكل مستقل من قيادة أقل من 1% من أعمال البحث والتطوير في مجال الذكاء الاصطناعي. وبعد ذلك، كان يتحسن كل شهر تقريبًا، ليصل إلى 12% في مايو، و22% في يوليو، و26% في أغسطس.
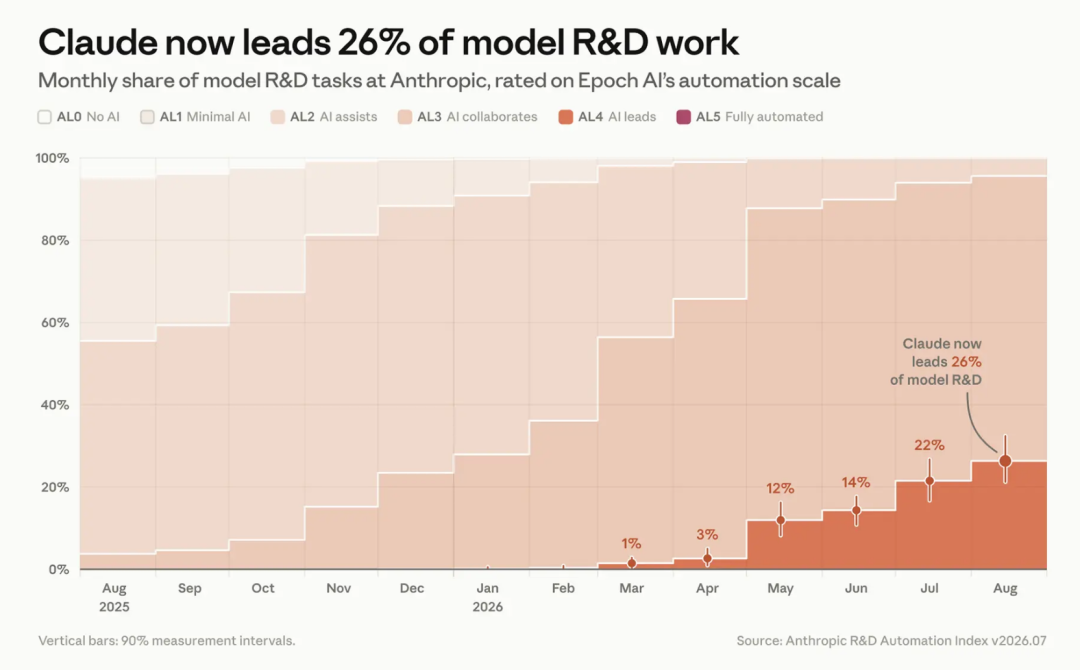
في OpenAI، اعتبارًا من منتصف أغسطس، كان عدد أيام العمل التي استثمرها وكلاء الذكاء الاصطناعي 3.1 أضعاف عدد أيام العمل التي استثمرها الباحثون البشريون (على أساس 8 ساعات يوميًا).
في شركة Anthropic، تم تسليم ربع أعمال صنع النماذج إلى كلود نفسه. النماذج القادمة سوف تأتي واحدة تلو الأخرى.
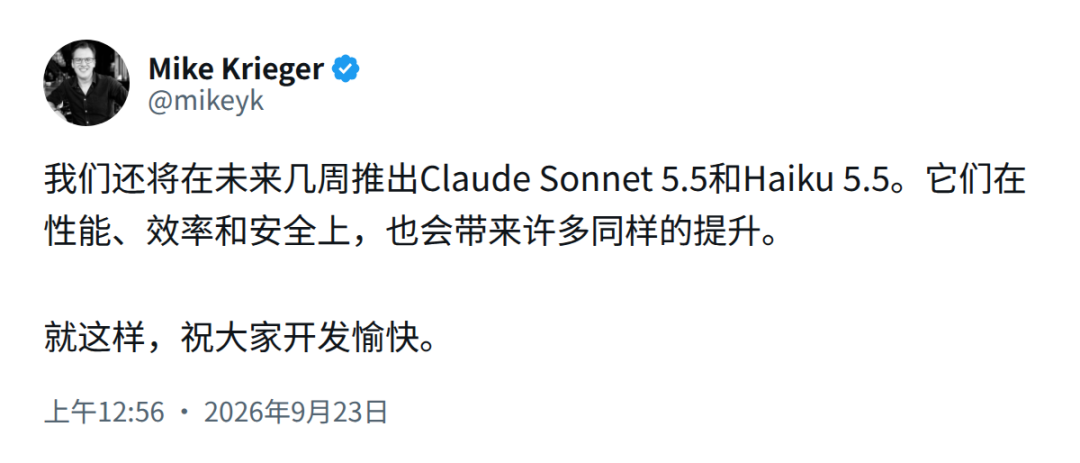
لقد وصلت قائمة الانتظار إلى الباب بالفعل. كشف مايك كريجر من Anthropic أن Sonnet 5.5 و Haiku 5.5 سيصلان في الأسابيع القليلة المقبلة.
بدأ برنامج Gemini 4 من Google "التدريب المسبق الأكثر طموحًا حتى الآن" في وقت مبكر من شهر يوليو، ويراهن العالم الخارجي بشكل عام على أنه سيتم الكشف عنه في نهاية العام تقريبًا. أعلنت شركتان محليتان على الأقل رسميًا عن الجيل التالي من هواتفهما الرائدة، مع عدم وجود تاريخ إصدار واحد فقط.
"الميتافيزيقا" التي تم الحصول عليها بشق الأنفس
سيتم إلغاؤه مباشرة بعد شهرين
كلما زادت سرعة تشغيل النموذج الكبير، أصبح الأمر أكثر إحراجًا للأشخاص الذين يكتبون التعليمات البرمجية في المراحل النهائية.
لقد سهرت بعض الوقت طوال الليل في نهاية شهر يوليو، وقمت للتو بنقل التطبيق إلى Opus 5. وقد تم تعديل كل معلمة بسلاسة كالحرير. بعد شهرين، خرج Opus 5.5، وقمت بتغيير الواجهة بسعادة - انقر، وبعض الطلبات أبلغت عن أخطاء مباشرة.
بالنظر إلى أدلة الكلمات السريعة الرسمية الأخيرة لهاتين الشركتين، ستجد أنهما ينقلان نفس الحقيقة. أصبحت العديد من مطالبات الأسلاف التي كتبتها لنموذج الجيل السابق بمثابة نفايات.
أول شيء هو القيام بالطرح.
يشير OpenAI بوضوح في دليل Astra إلى أن تعليمات العملية التي كانت مفصلة جدًا في الماضي ستصبح الآن عائقًا. يمكن حذف كلمات مثل "اقرأ المستند جيدًا قبل تغيير الكود" و"تذكر إجراء الاختبارات".
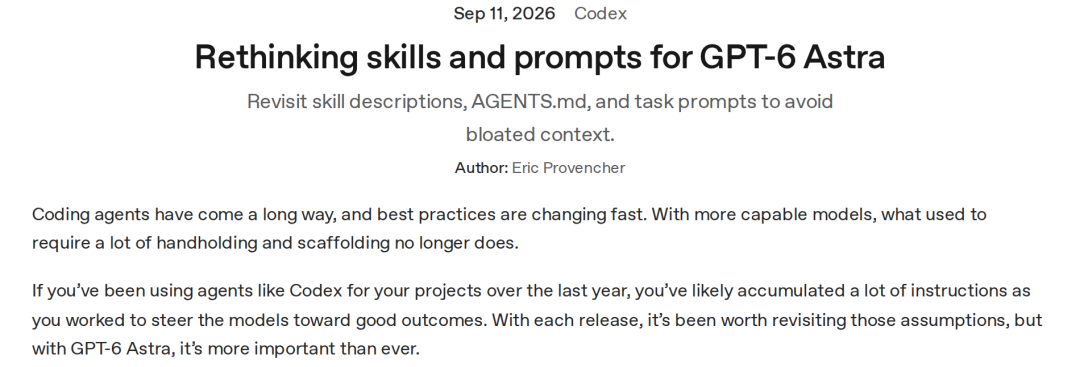
يعني دليل الأنثروبي هذا أيضًا.
في الماضي، كانت الكلمات السريعة تتطلب في كثير من الأحيان إضافة جملة "التحقق من ذلك بعد الانتهاء"، ولكن Opus 5 يمكنه بالفعل التحقق من ذلك بنفسه. إذا لم يتم حذف هذه الجملة، فإنه سيتم الإفراط في التحقق.
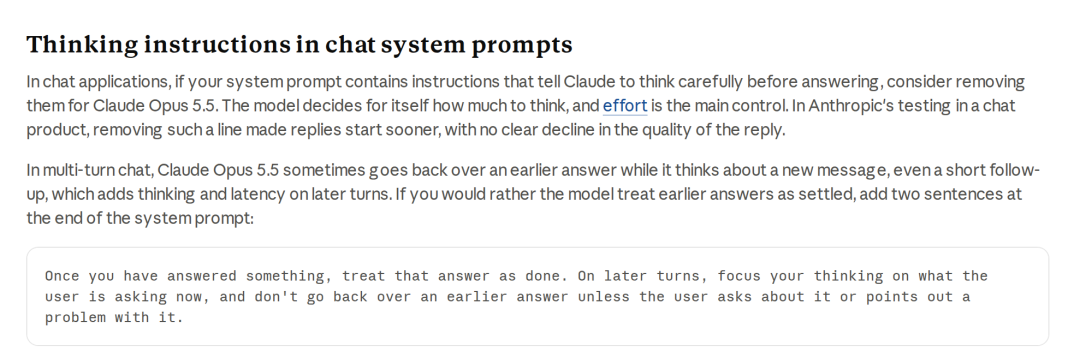
في Opus 5.5، يوصى بحذف عبارة PUA "فكر جيدًا قبل الإجابة" في مشهد الدردشة. وبعد حذفه يكون الرد أسرع ولم تنخفض الجودة بشكل ملحوظ.
بعد حذف القديم، عليك إضافة جديد، لأن كل جيل له مزاج جديد.
يحب Opus 5.5 دائمًا العودة إلى الوراء والتفكير في الأسئلة التي تمت الإجابة عليها بالفعل خلال جولات متعددة من الحوار، وهو ما يعد إهدارًا للقوة الحاسوبية. تم إعطاء التصحيح الرسمي، "ما تمت الإجابة عليه قد مضى."
تتغير المعلمات والقيم الافتراضية أيضًا بهدوء.
في Opus 5.5، يؤدي إيقاف تشغيل وضع التفكير مباشرةً إلى ظهور خطأ 400؛ بدون كتابة معلمة الجهد، يتم تقليل الترس الافتراضي من مرتفع إلى متوسط، ويتم تعديل التكلفة والتأثير وفقًا لذلك.
وفي هذا الصدد فإن الاقتراح الرسمي هو إعادة تشغيل اختبار الجهد وعدم نقل الإعدادات القديمة مباشرة من Opus 5.
مجموعة من الكلمات السريعة بالإضافة إلى مجموعة من المعلمات، على كل جيل أن يقشر طبقات من الجلد. إذا لم يتم إجراء التعديل، قد تختلف الفاتورة بشكل كبير.
أوضح لانس مارتن من Anthropic في الفيديو أن المطالبة القديمة المكتوبة لـ Opus 4.8 تكلف 2.45 سنتًا لكل أمر عمل، وتكلف 2.02 سنتًا لاستبدالها مباشرة بـ Opus 5.5. وبعد غسلها مرة أخرى بالأدوات الرسمية، ارتفعت نسبة الدقة إلى 92.0%، وانخفضت التكلفة إلى 1.83 سنتًا.
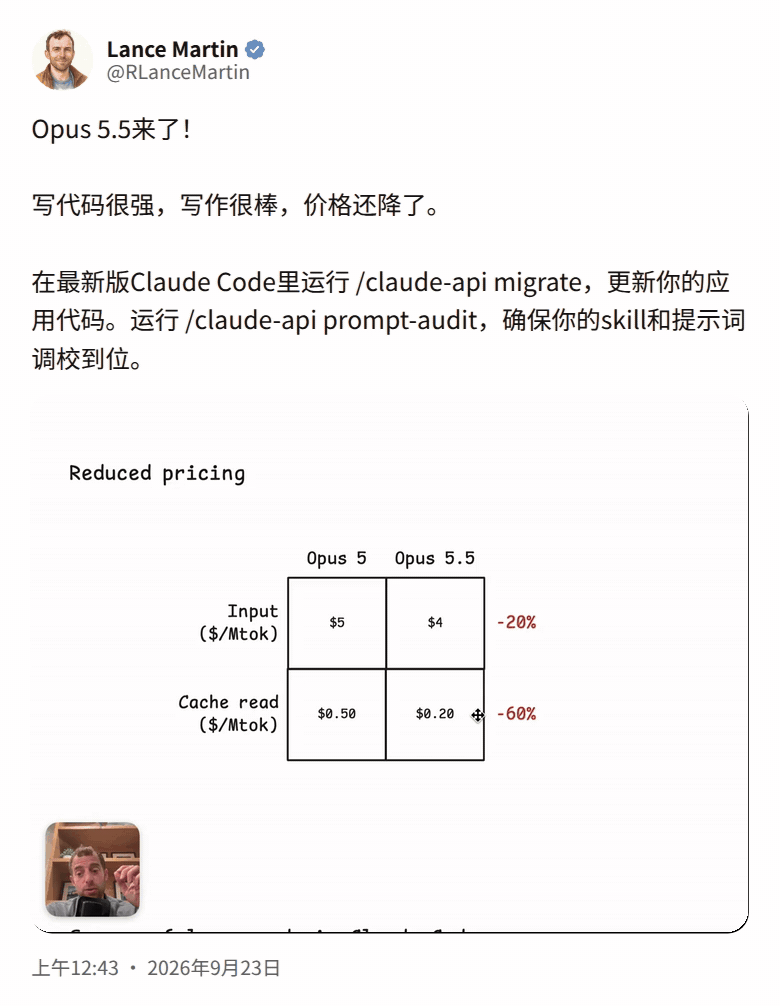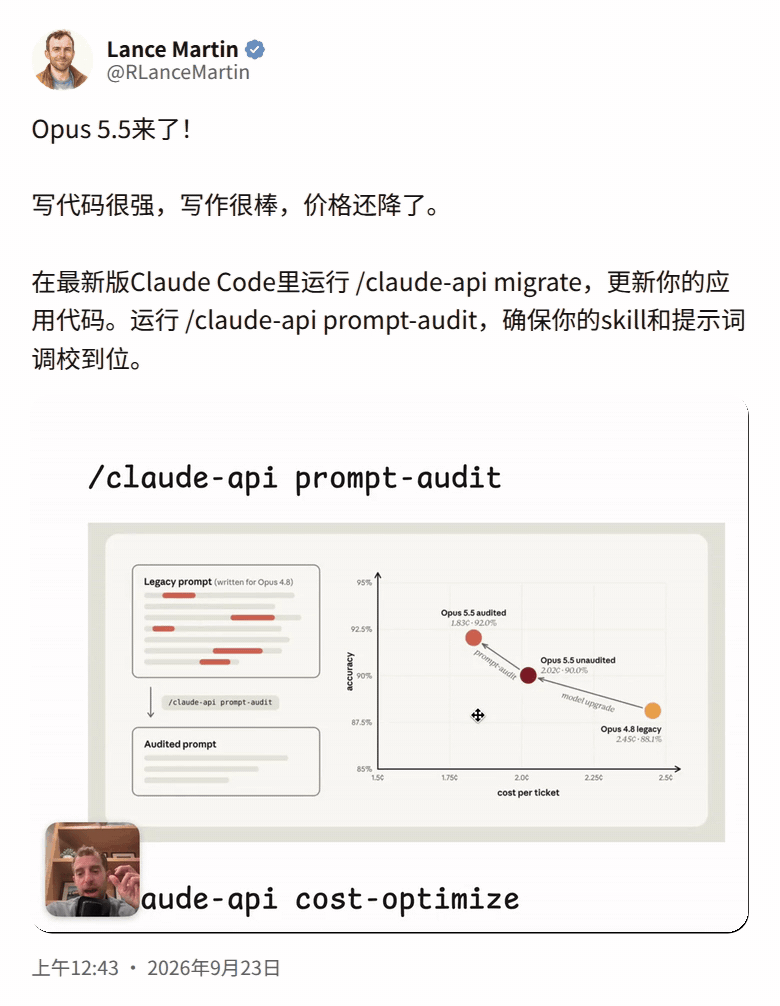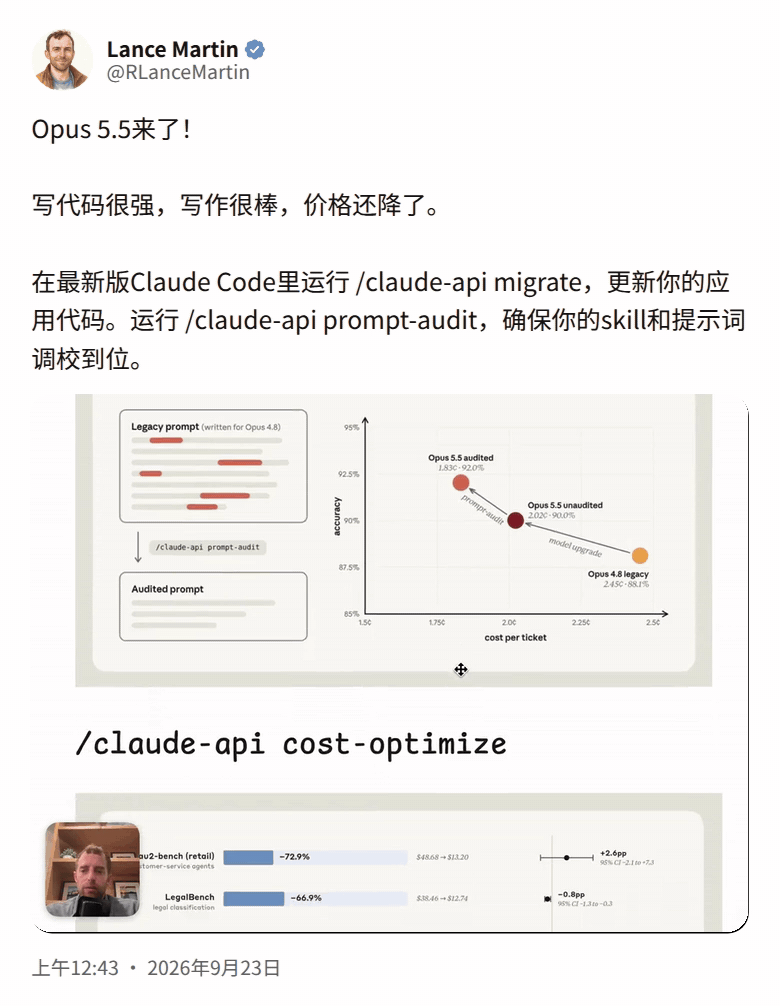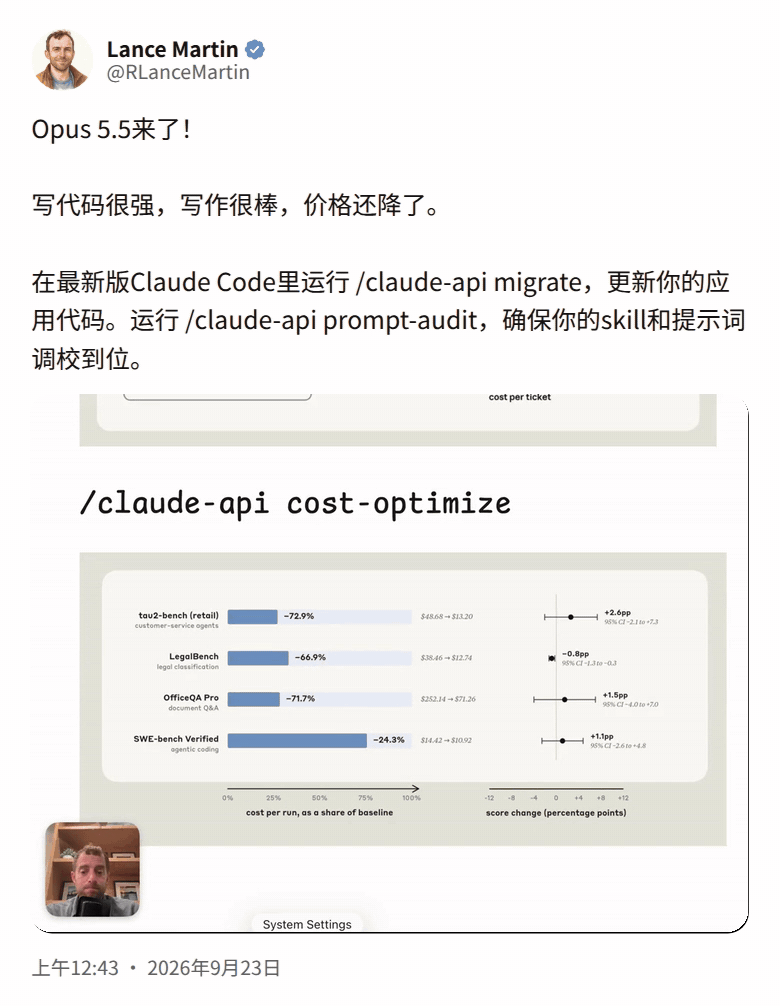
بالإضافة إلى ذلك، تم أيضًا تقصير العمر الافتراضي للنموذج نفسه.
أصدرت OpenAI 9 إعلانات إيقاف هذا العام، تتضمن أكثر من 40 نموذجًا ووظيفة.
من بينها، GPT-5.5، الذي تم إصداره للتو في 23 أبريل، ستتم إزالته من ChatGPT وCodex في 14 أكتوبر، وقد ظل موجودًا لمدة أقل من نصف عام.
حتى منصة التقييم Evals الخاصة بشركة OpenAI ستغلق أبوابها في نهاية شهر نوفمبر.
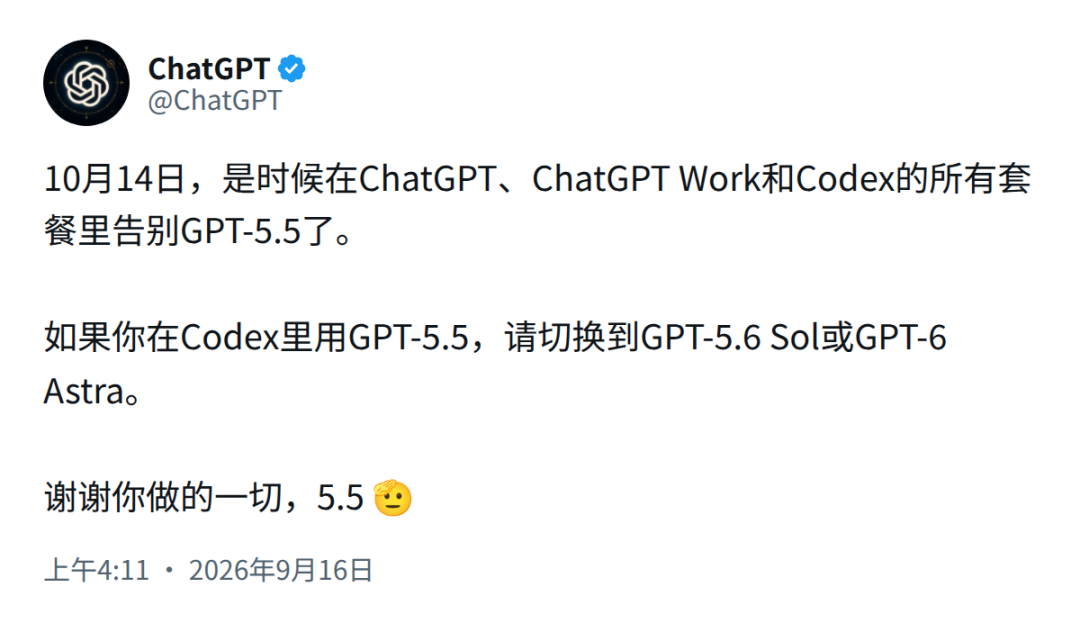
هل تريد حذف القائمة؟ تم التوصل إلى مجموعة جديدة من أسئلة الاختبار خلال نصف عام
لا يهم إذا لم يتمكن الناس من مواكبة ذلك، فحتى "أوراق الامتحان" لم تعد كافية.
في مارس من هذا العام، تم إطلاق ARC-AGI-3، الذي يدعي أنه متخصص في الذكاء الاصطناعي واختبار الذكاء دون حفظ الأسئلة. Gemini 3.1 Pro الذي احتل المركز الأول حينها حصل على 0.37% فقط بينما حصل الإنسان على 100%.
في 3 سبتمبر، دخل GPT-6 Astra إلى غرفة الاختبار، وسجل 62.7% في الاختبار القياسي، ووصل مباشرة إلى 99.9% عند استخدام إطار عمل محدد. في 96% من المستويات، كان عدد الخطوات التي يتخذها الإنسان أقل.
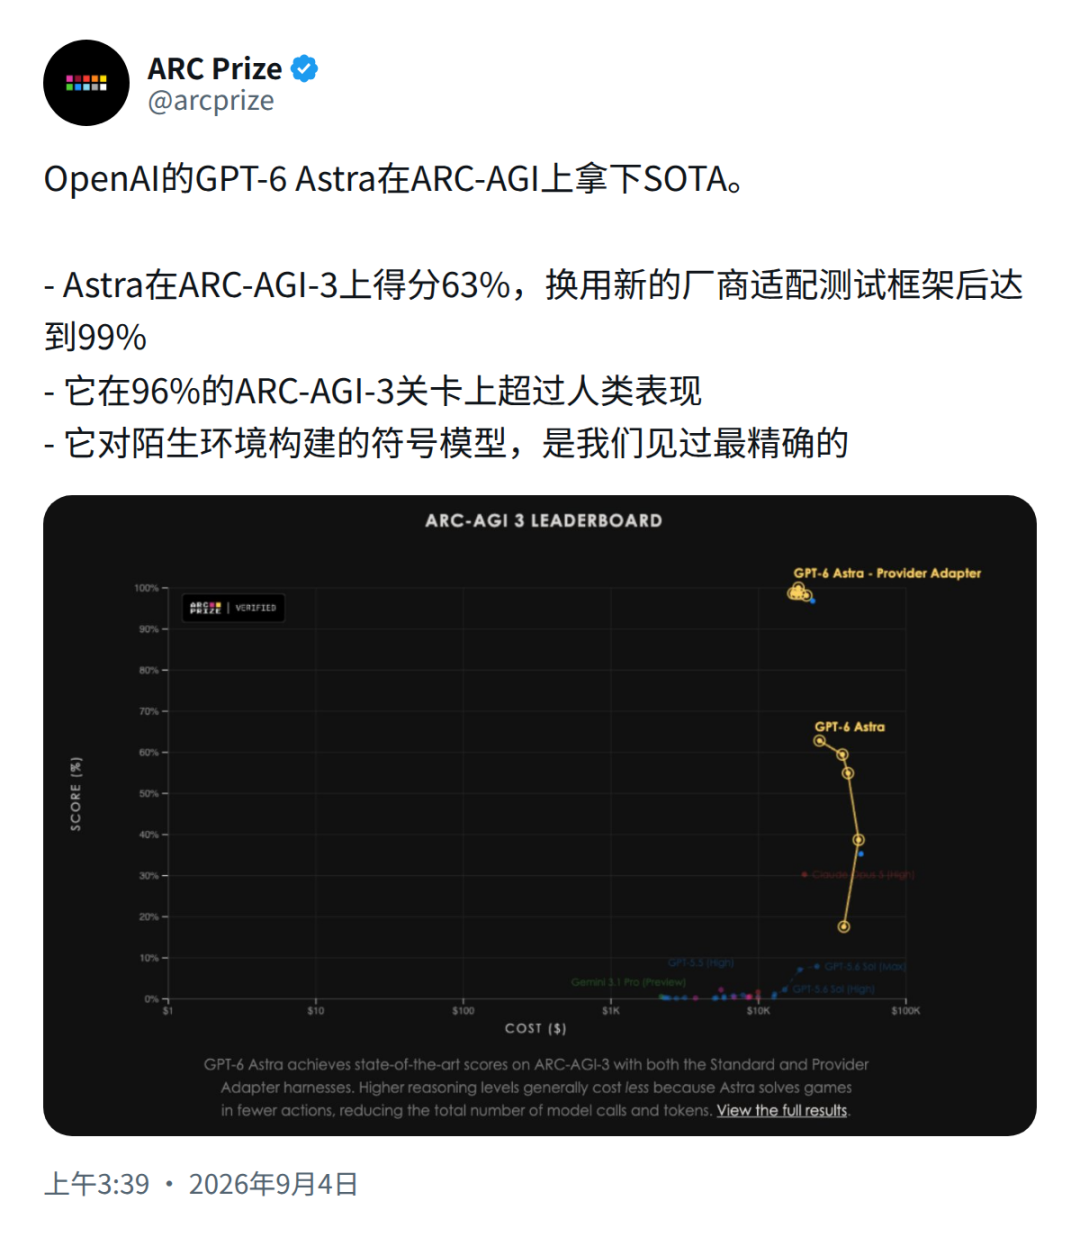
تم تقسيم مجموعة جديدة من أسئلة الاختبار خلال نصف عام، وبدأ مسؤولو ARC في التفكير في كيفية إنتاج الجيل التالي من التقييمات.
في قائمة البرمجة (Next.js)، حصل كل من Sol وOpus 5.5 وFable 5.1 على 97%، متعادلين في المركز الأول؛ وفي قائمة الكتابة، يتقدم Opus 5.5 Fault على المركز الثاني بفارق 307 نقاط.
هذه النتيجة هي أكبر قفزة منفردة في تاريخ القائمة. قال المدون إنه كان أمرًا شائنًا بعد قراءته، وكاد يعتقد أن هناك خطأً في معياره الخاص!
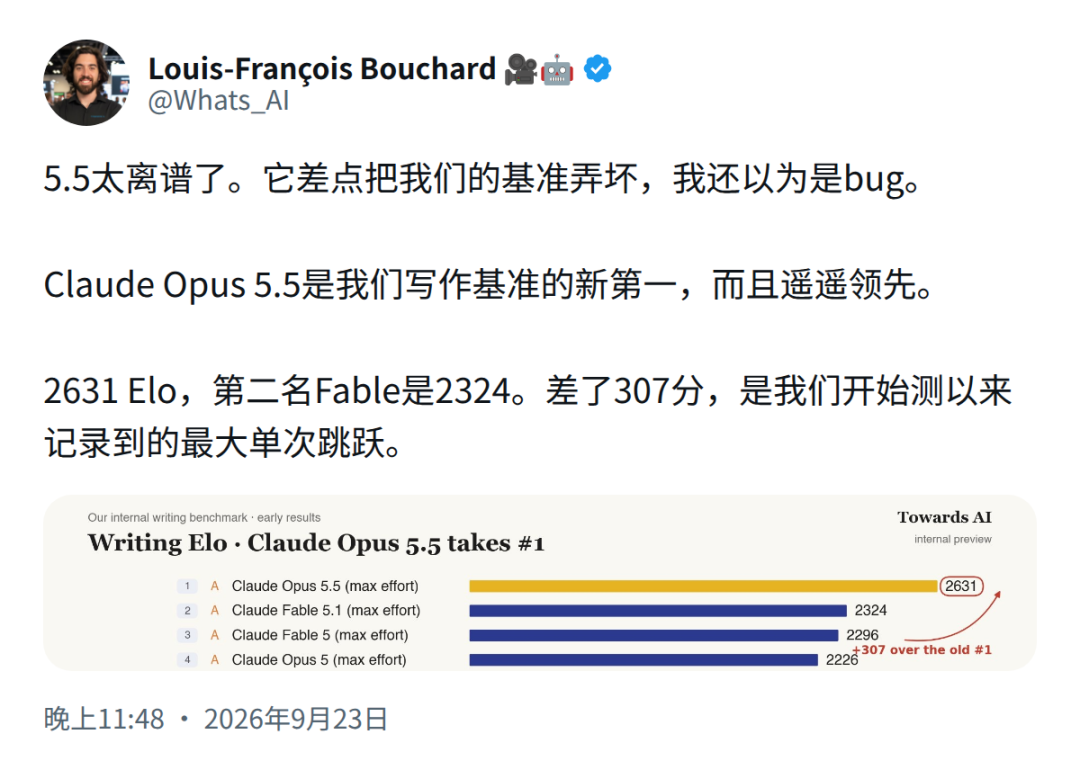
في كل مرة يأتي نموذج جديد، يتعين على المطورين بدء عملية الاختبار من جديد مثل Sisyphus.
وفقًا للوتيرة الحالية، إذا وصل الأمر حقًا في العام المقبل إلى نقطة "تحديث واحد يوميًا"، فقد لا تستمر الكلمات السريعة وروابط الوكيل التي قمت بتعديلها اليوم لأكثر من أسبوع.
لأول مرة، تجاوزت سرعة استبدال النموذج تمامًا سرعة تكيف البشر معه.
أبطأ العدائين اليوم هم في الواقع أولئك الذين يستخدمون الذكاء الاصطناعي.
التعليقات