الملخص:
لفترة طويلة، سواء كان جهاز تلفزيون أو شاشة عرض أو هاتفًا ذكيًا، غالبًا ما تأتي الصور والأصوات من مواقع مختلفة. يرى المشاهدون شخصيات تتحدث على الشاشة، ولكن الصوت يأتي عادةً من مكبرات الصوت الموجودة أسفل الشاشة أو من أجهزة صوت خارجية. والآن، قام فريق بحث كوري بتطوير تقنية عرض جديدة في محاولة لحل هذه المشكلة بشكل كامل، مما يسمح بإصدار الصوت مباشرة من موضع الصوت في الصورة، وبالتالي تقديم تجربة سمعية وبصرية أكثر غامرة.
أعلن الباحثون في المعهد الكوري للميكانيكية والمواد (KIMM) مؤخرًا عن "تقنية عرض الاندماج الصوتي والمرئي" استنادًا إلى هيكل شبكي معياري. تقوم هذه التقنية بتثبيت مشغلات اهتزاز متعددة في الجزء الخلفي من لوحة العرض، مما يسمح للشاشة نفسها بأن تصبح مكبر صوت كبيرًا وقادرة على التحكم الدقيق في الصوت الذي ينبعث من مناطق معينة من الشاشة.
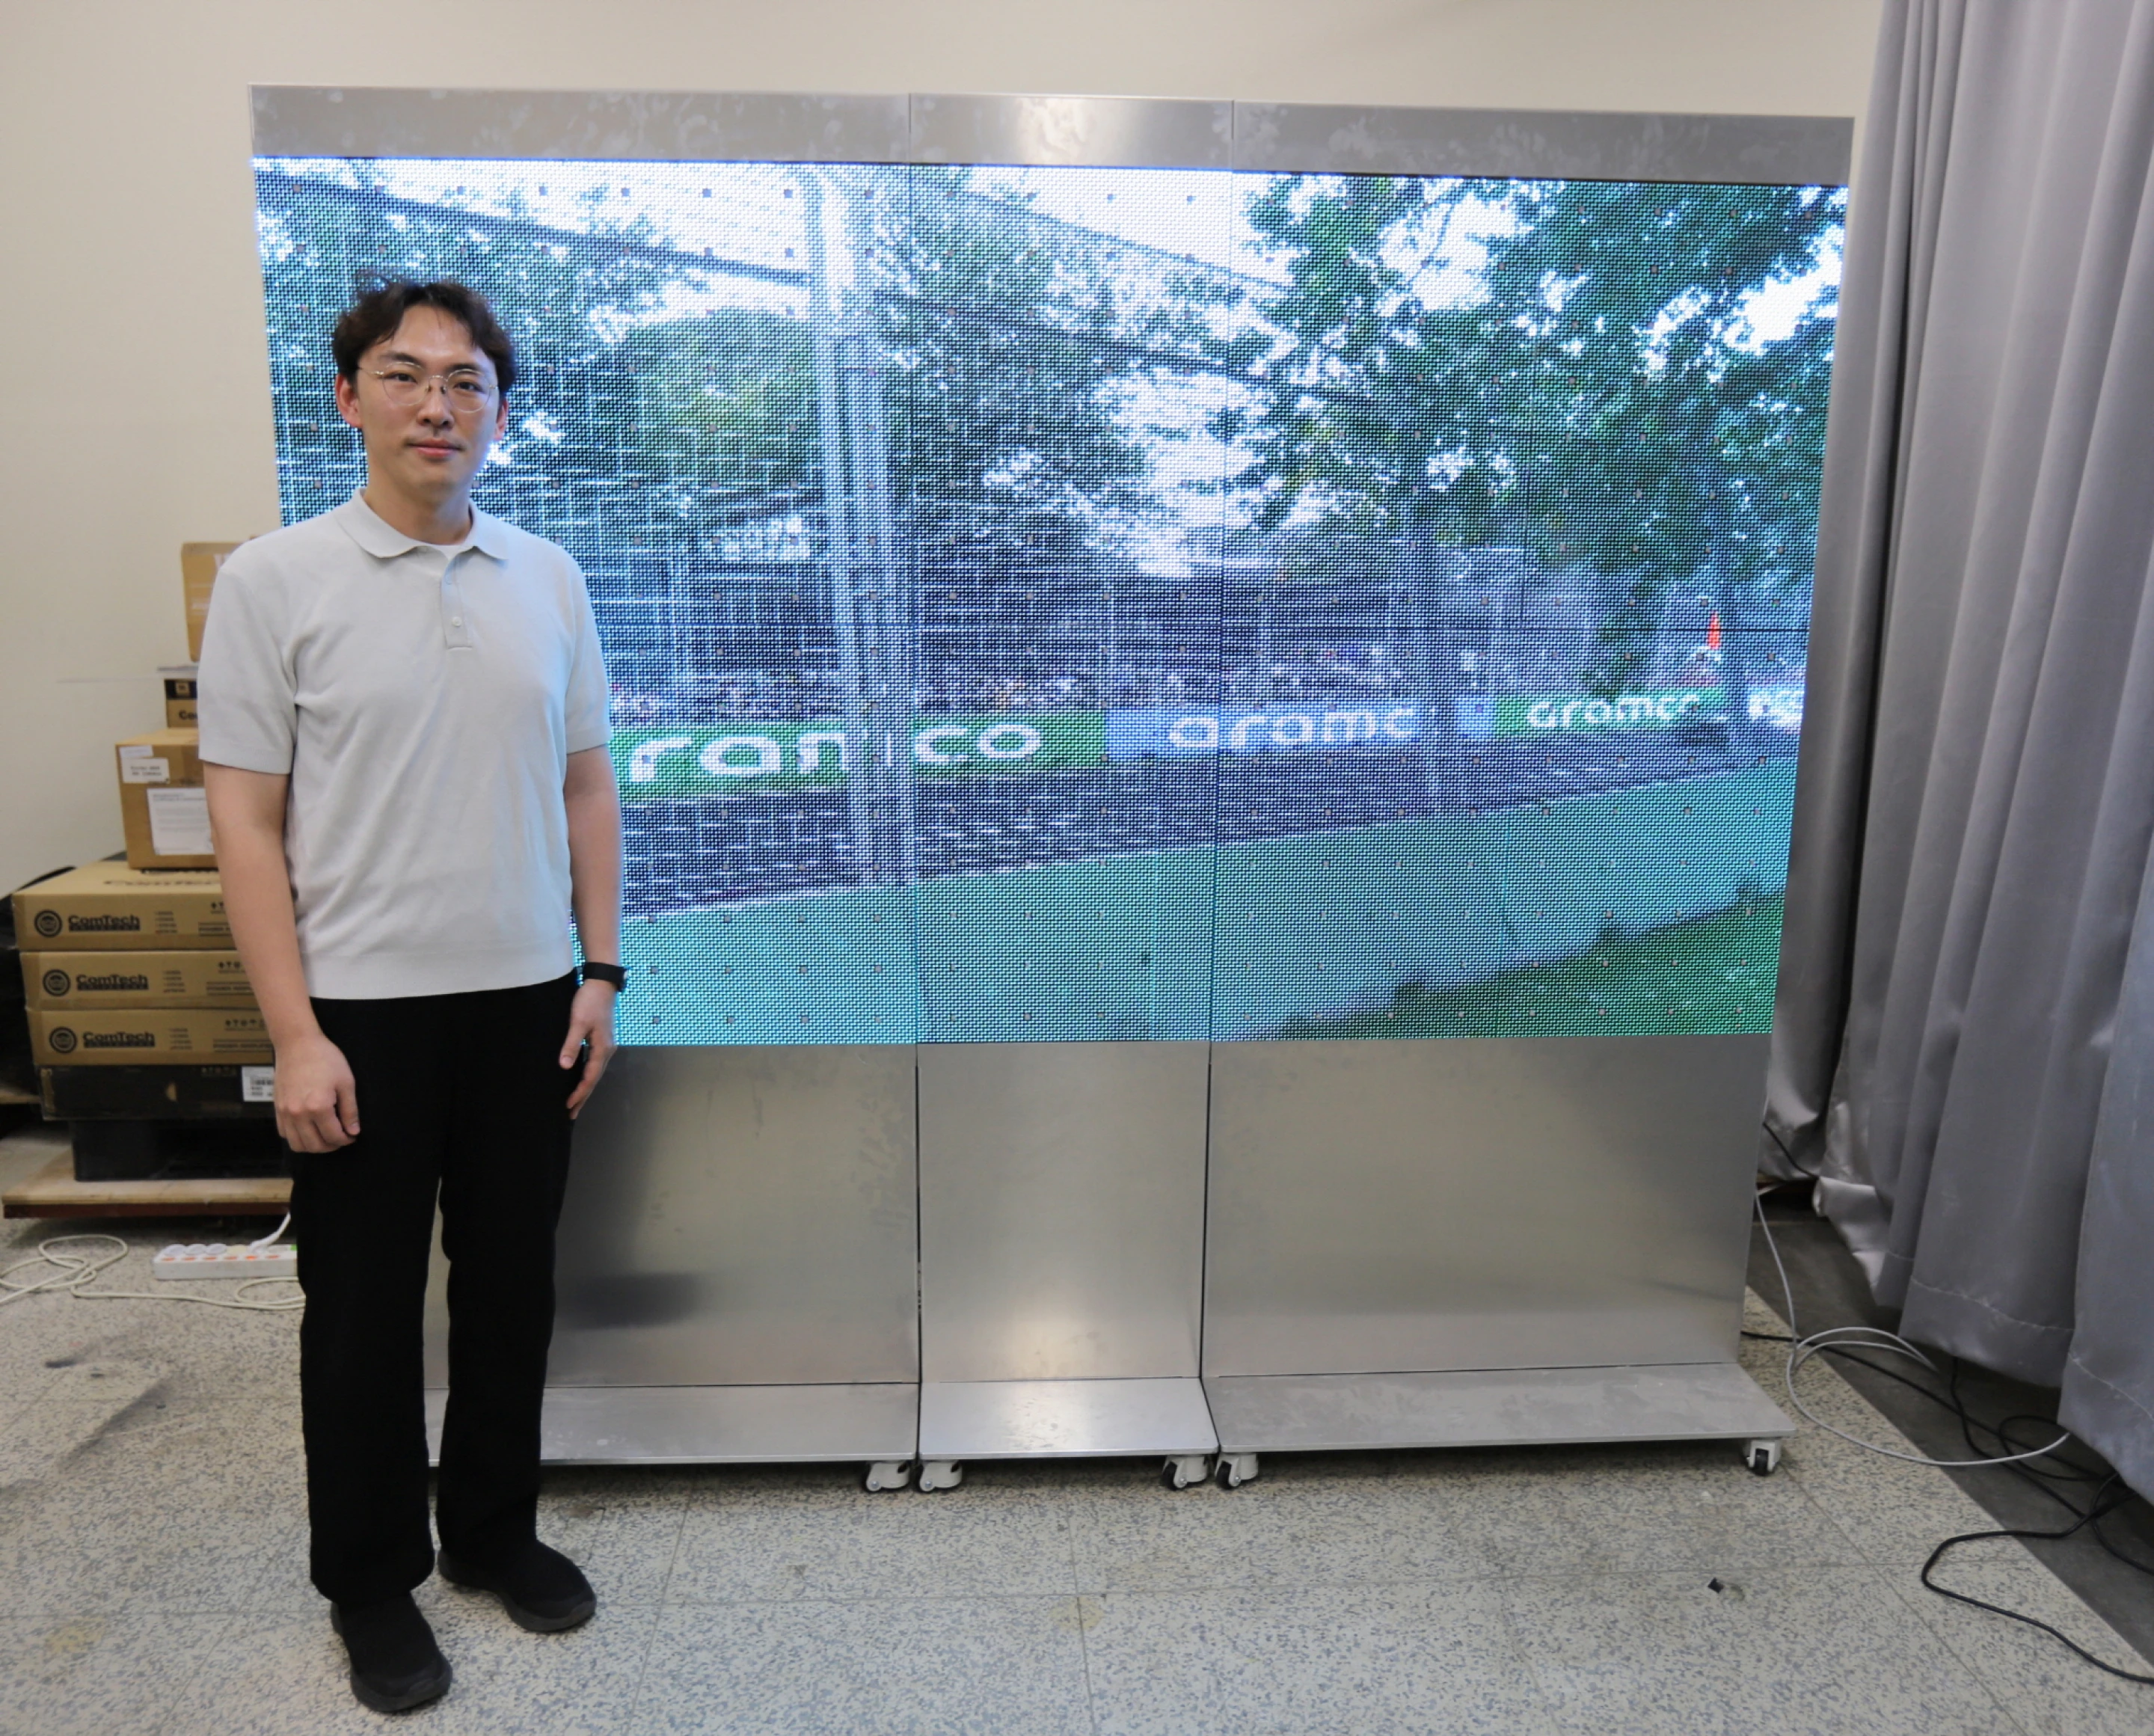
وهذا يعني أنه عندما يتحدث شخص ما في الزاوية اليسرى العليا من الشاشة، سيتم أيضًا نقل صوته بشكل متزامن من المنطقة المقابلة، كما لو كان يأتي مباشرة من موضع فم الشخصية. مع تغير محتوى الصورة، يمكن أيضًا أن تتحرك منطقة انبعاث الصوت في الوقت الفعلي. على سبيل المثال، عندما تطير كرة بسرعة من أحد جوانب الشاشة إلى الجانب الآخر، فإن الصوت سيتحرك أيضًا على نفس المسار، وبالتالي تعزيز الإحساس بالمساحة والواقعية.
يشير الباحثون إلى أن البشر يربطون بشكل طبيعي بين مصادر الصوت والأهداف المرئية في العالم الحقيقي. يمكن للأشخاص تحديد موقع الأشياء المسقطة ويمكنهم معرفة من يتحدث وأعينهم مغلقة لأن الصوت نفسه اتجاهي. ومع ذلك، عادةً ما يتم فصل المعلومات المرئية ومصادر الصوت لأجهزة العرض الموجودة عن بعضها البعض، ويؤثر هذا عدم التناسق دائمًا على التجربة الغامرة.
على الرغم من أن أنظمة الصوت الاستريو والمحيطي تمكنت من خلق إحساس بالاتجاه من خلال مكبرات صوت متعددة، إلا أن الصوت لا يزال يأتي بشكل أساسي من الأجهزة المرتبة حول الشاشة، ومن الصعب أن يتوافق تمامًا مع الموضع المحدد في الصورة على الشاشات الكبيرة. كانت هناك بعض الحلول السابقة للسماح للوحة العرض بإصدار الصوت مباشرة، ولكن عادة ما تكون نقطة إخراج الصوت ثابتة ويمكن تحديدها بسهولة حسب حجم الشاشة ونطاق التردد.
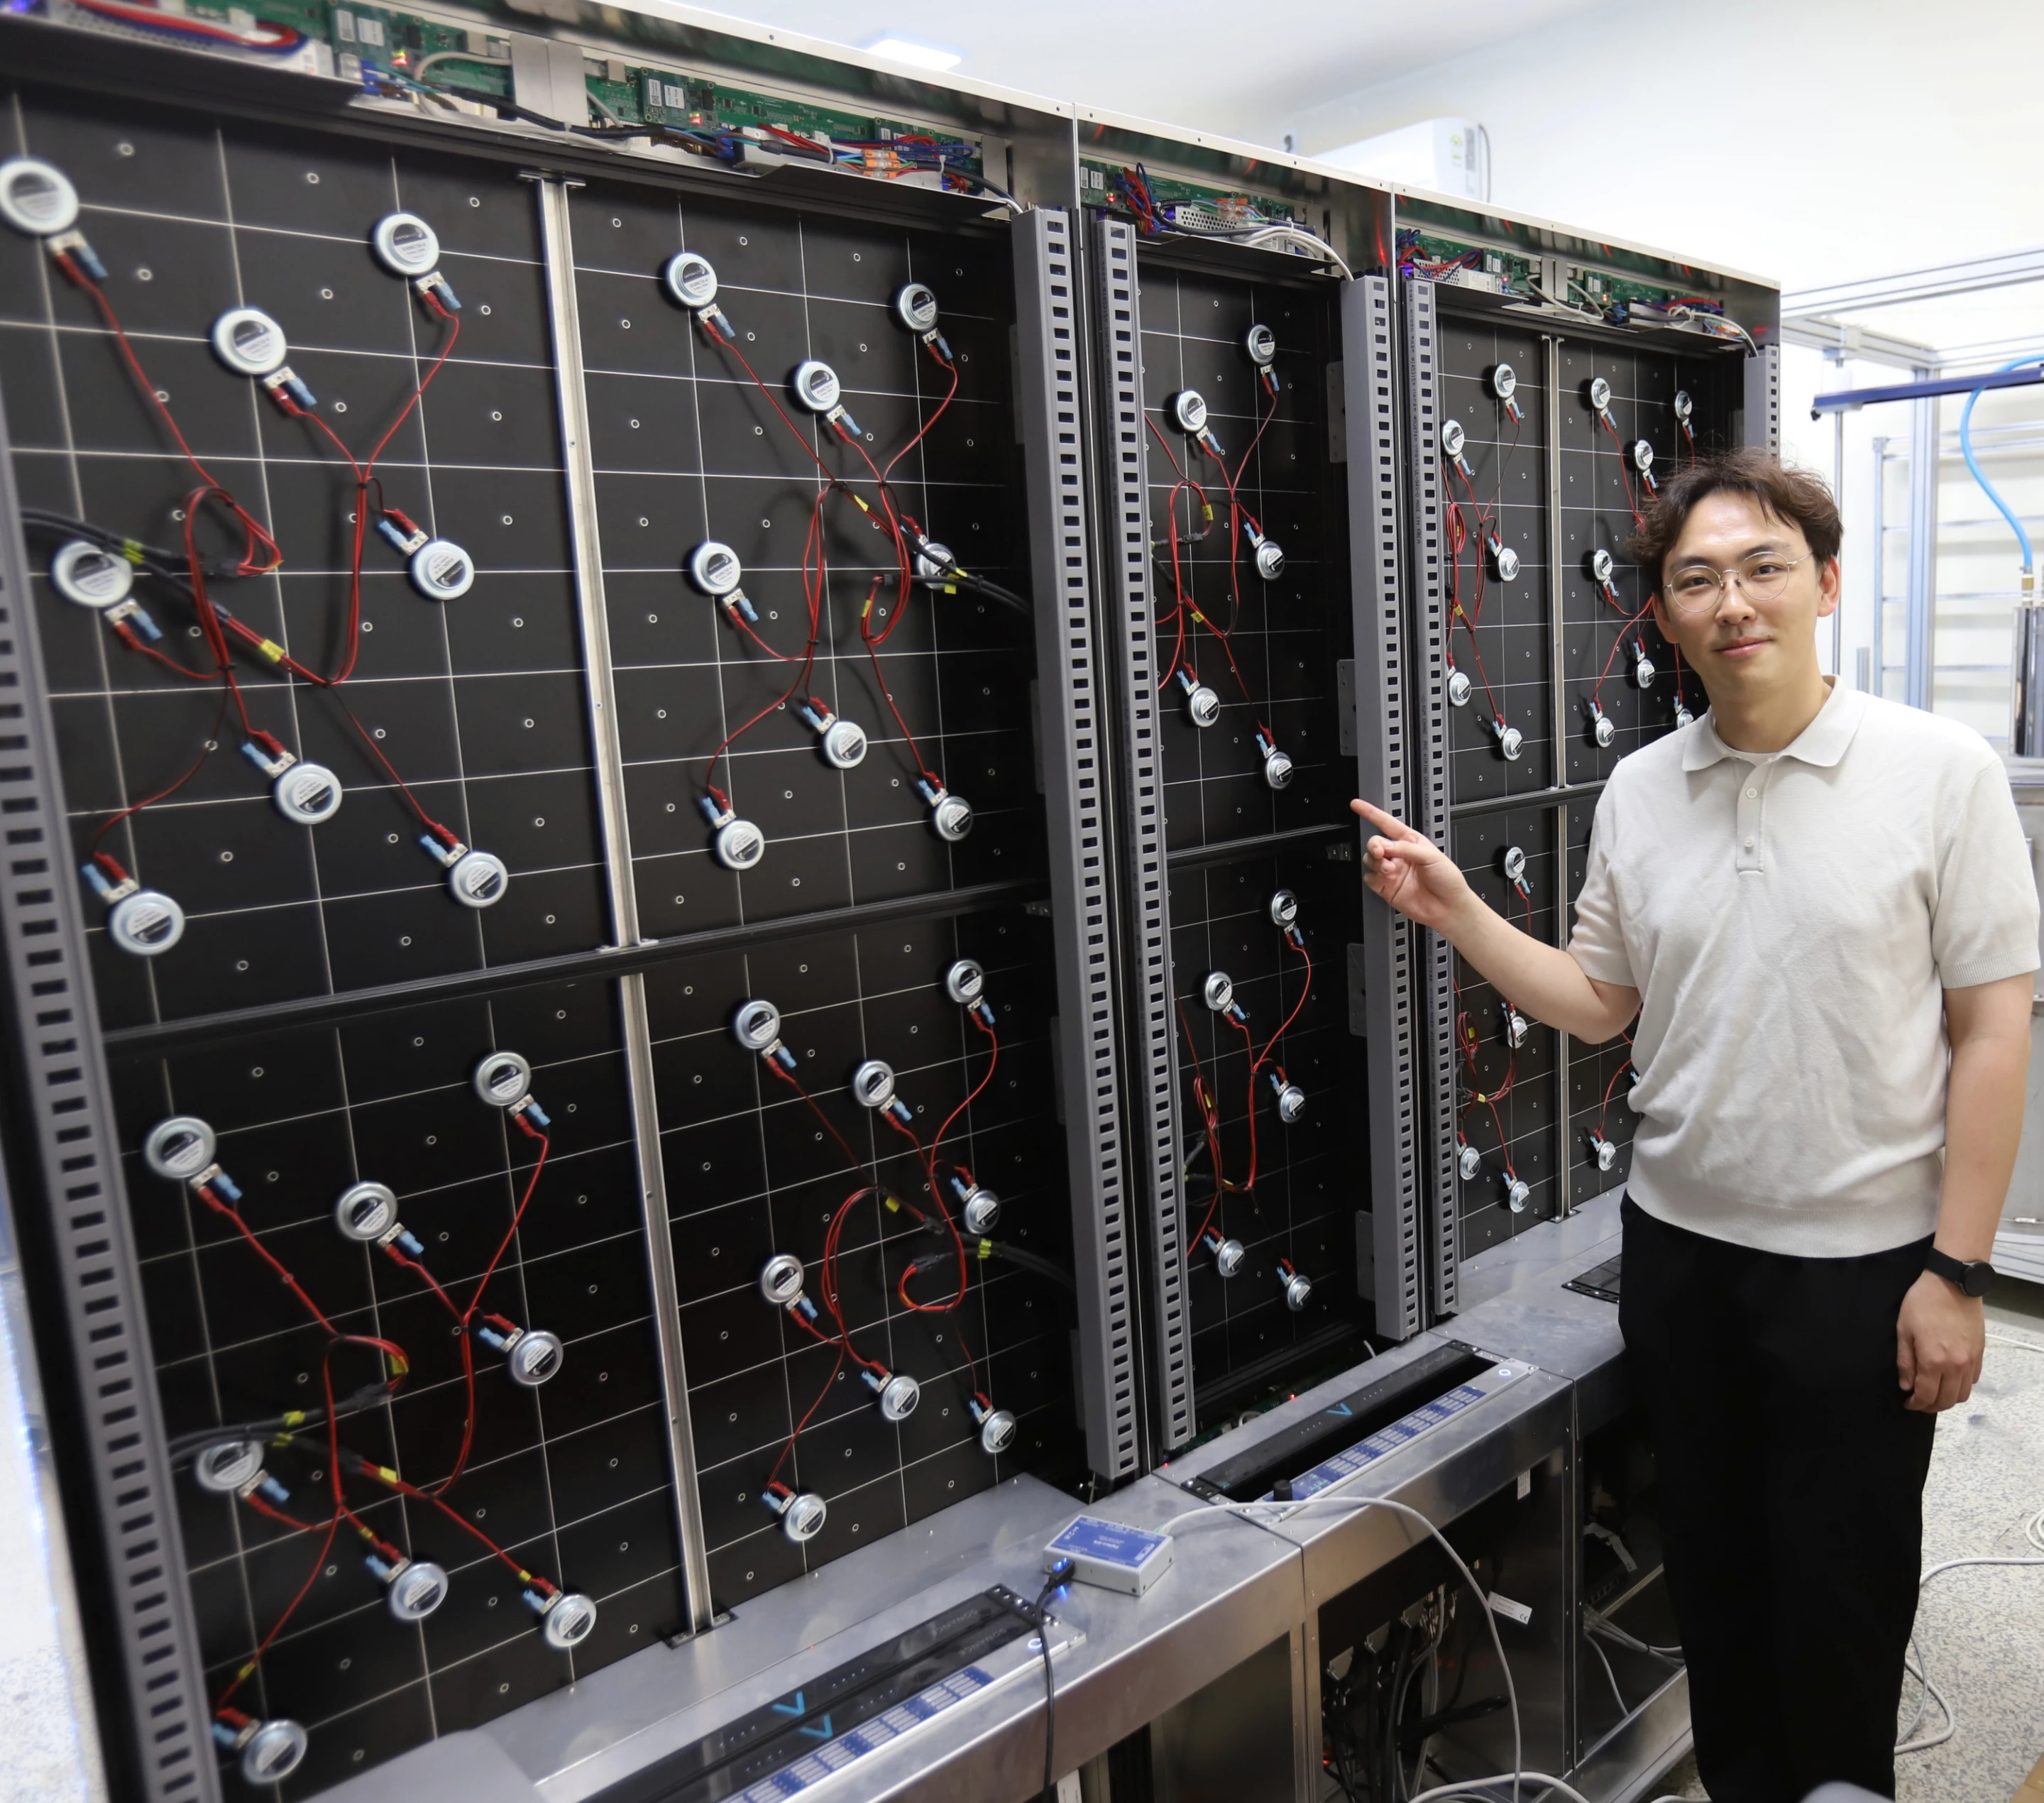
يحقق الحل الجديد لفريق KIMM تحكمًا ديناميكيًا في موضع انبعاث الصوت وتصميمًا قابلاً للتطوير. يبلغ حجم النموذج الأولي للجهاز الذي ابتكره الباحثون حوالي 100 بوصة، ويتكون من فيلم LED شفاف ولوحة من الألومنيوم، مع 80 محرك ملف صوتي (VCMs) مثبتين خلفه. ستتحرك هذه المحركات ذهابًا وإيابًا بعد تلقي الإشارات الكهربائية، مما يتسبب في اهتزاز اللوحة ودفع الهواء لتكوين موجات صوتية. المبدأ مشابه لمبدأ الحجاب الحاجز التقليدي لمكبر الصوت.
ومع ذلك، فإن الحصول على صوت في منطقة معينة من الشاشة ليس بالأمر السهل. نظرًا لأن الاهتزازات تنتشر في جميع أنحاء اللوحة، مما يضيف إلى الاهتزازات الأخرى أو يلغيها، فمن الصعب التحكم في مصدر الصوت بالضبط. ولحل هذه المشكلة، قام فريق البحث أولاً بتحليل خصائص استجابة كل منطقة من اللوحة للاهتزاز، ثم استخدم خوارزمية رياضية تسمى "طريقة مور-بنروز الزائفة" لحساب جهد القيادة المطلوب لكل محرك، وبالتالي تركيز طاقة الاهتزاز بدقة على المنطقة المستهدفة.
لا تقوم هذه الطريقة بتشغيل أقرب محرك فحسب، بل تستخدم محركات متعددة للعمل معًا لتكوين مجال اهتزاز محلي على الشاشة. عندما يتحرك مصدر الصوت في الفيديو، سيتحرك مجال الاهتزاز أيضًا بشكل متزامن لتحقيق تأثير التتبع الديناميكي.
تواجه الترجمة الصوتية في الوقت الفعلي تحديًا آخر أيضًا. سوف تؤثر موجات الاهتزاز في اللوحة على بعضها البعض، كما تختلف أيضًا كفاءة نقل المحركات المختلفة إلى مناطق مختلفة. عندما يقوم النظام بإعادة حساب موقع الهدف المتحرك باستمرار، قد تصبح عملية التحكم غير مستقرة.
وفي هذا الصدد، قام فريق البحث بتطوير مجموعة من خوارزميات الإثارة الانتقائية لاستبعاد المحركات ذات كفاءة نقل الاهتزاز المنخفضة من الحساب، كما صمم أيضًا تقنية يمكنها توصيل الإشارات الصوتية المستمرة بسلاسة لتقليل الضوضاء والانقطاعات أثناء حركة الصوت.
من أجل زيادة تحسين مستوى الأتمتة، قدم الباحثون أيضًا تقنية فصل مصدر الصوت وتحديد موقعه استنادًا إلى الذكاء الاصطناعي. يمكن للذكاء الاصطناعي التعرف تلقائيًا على هدف الصوت في شاشة الفيديو، واستخراج الصوت المقابل من الإشارة الصوتية المعقدة، ثم عرضه بدقة على الموضع المقابل على الشاشة دون تدخل يدوي.
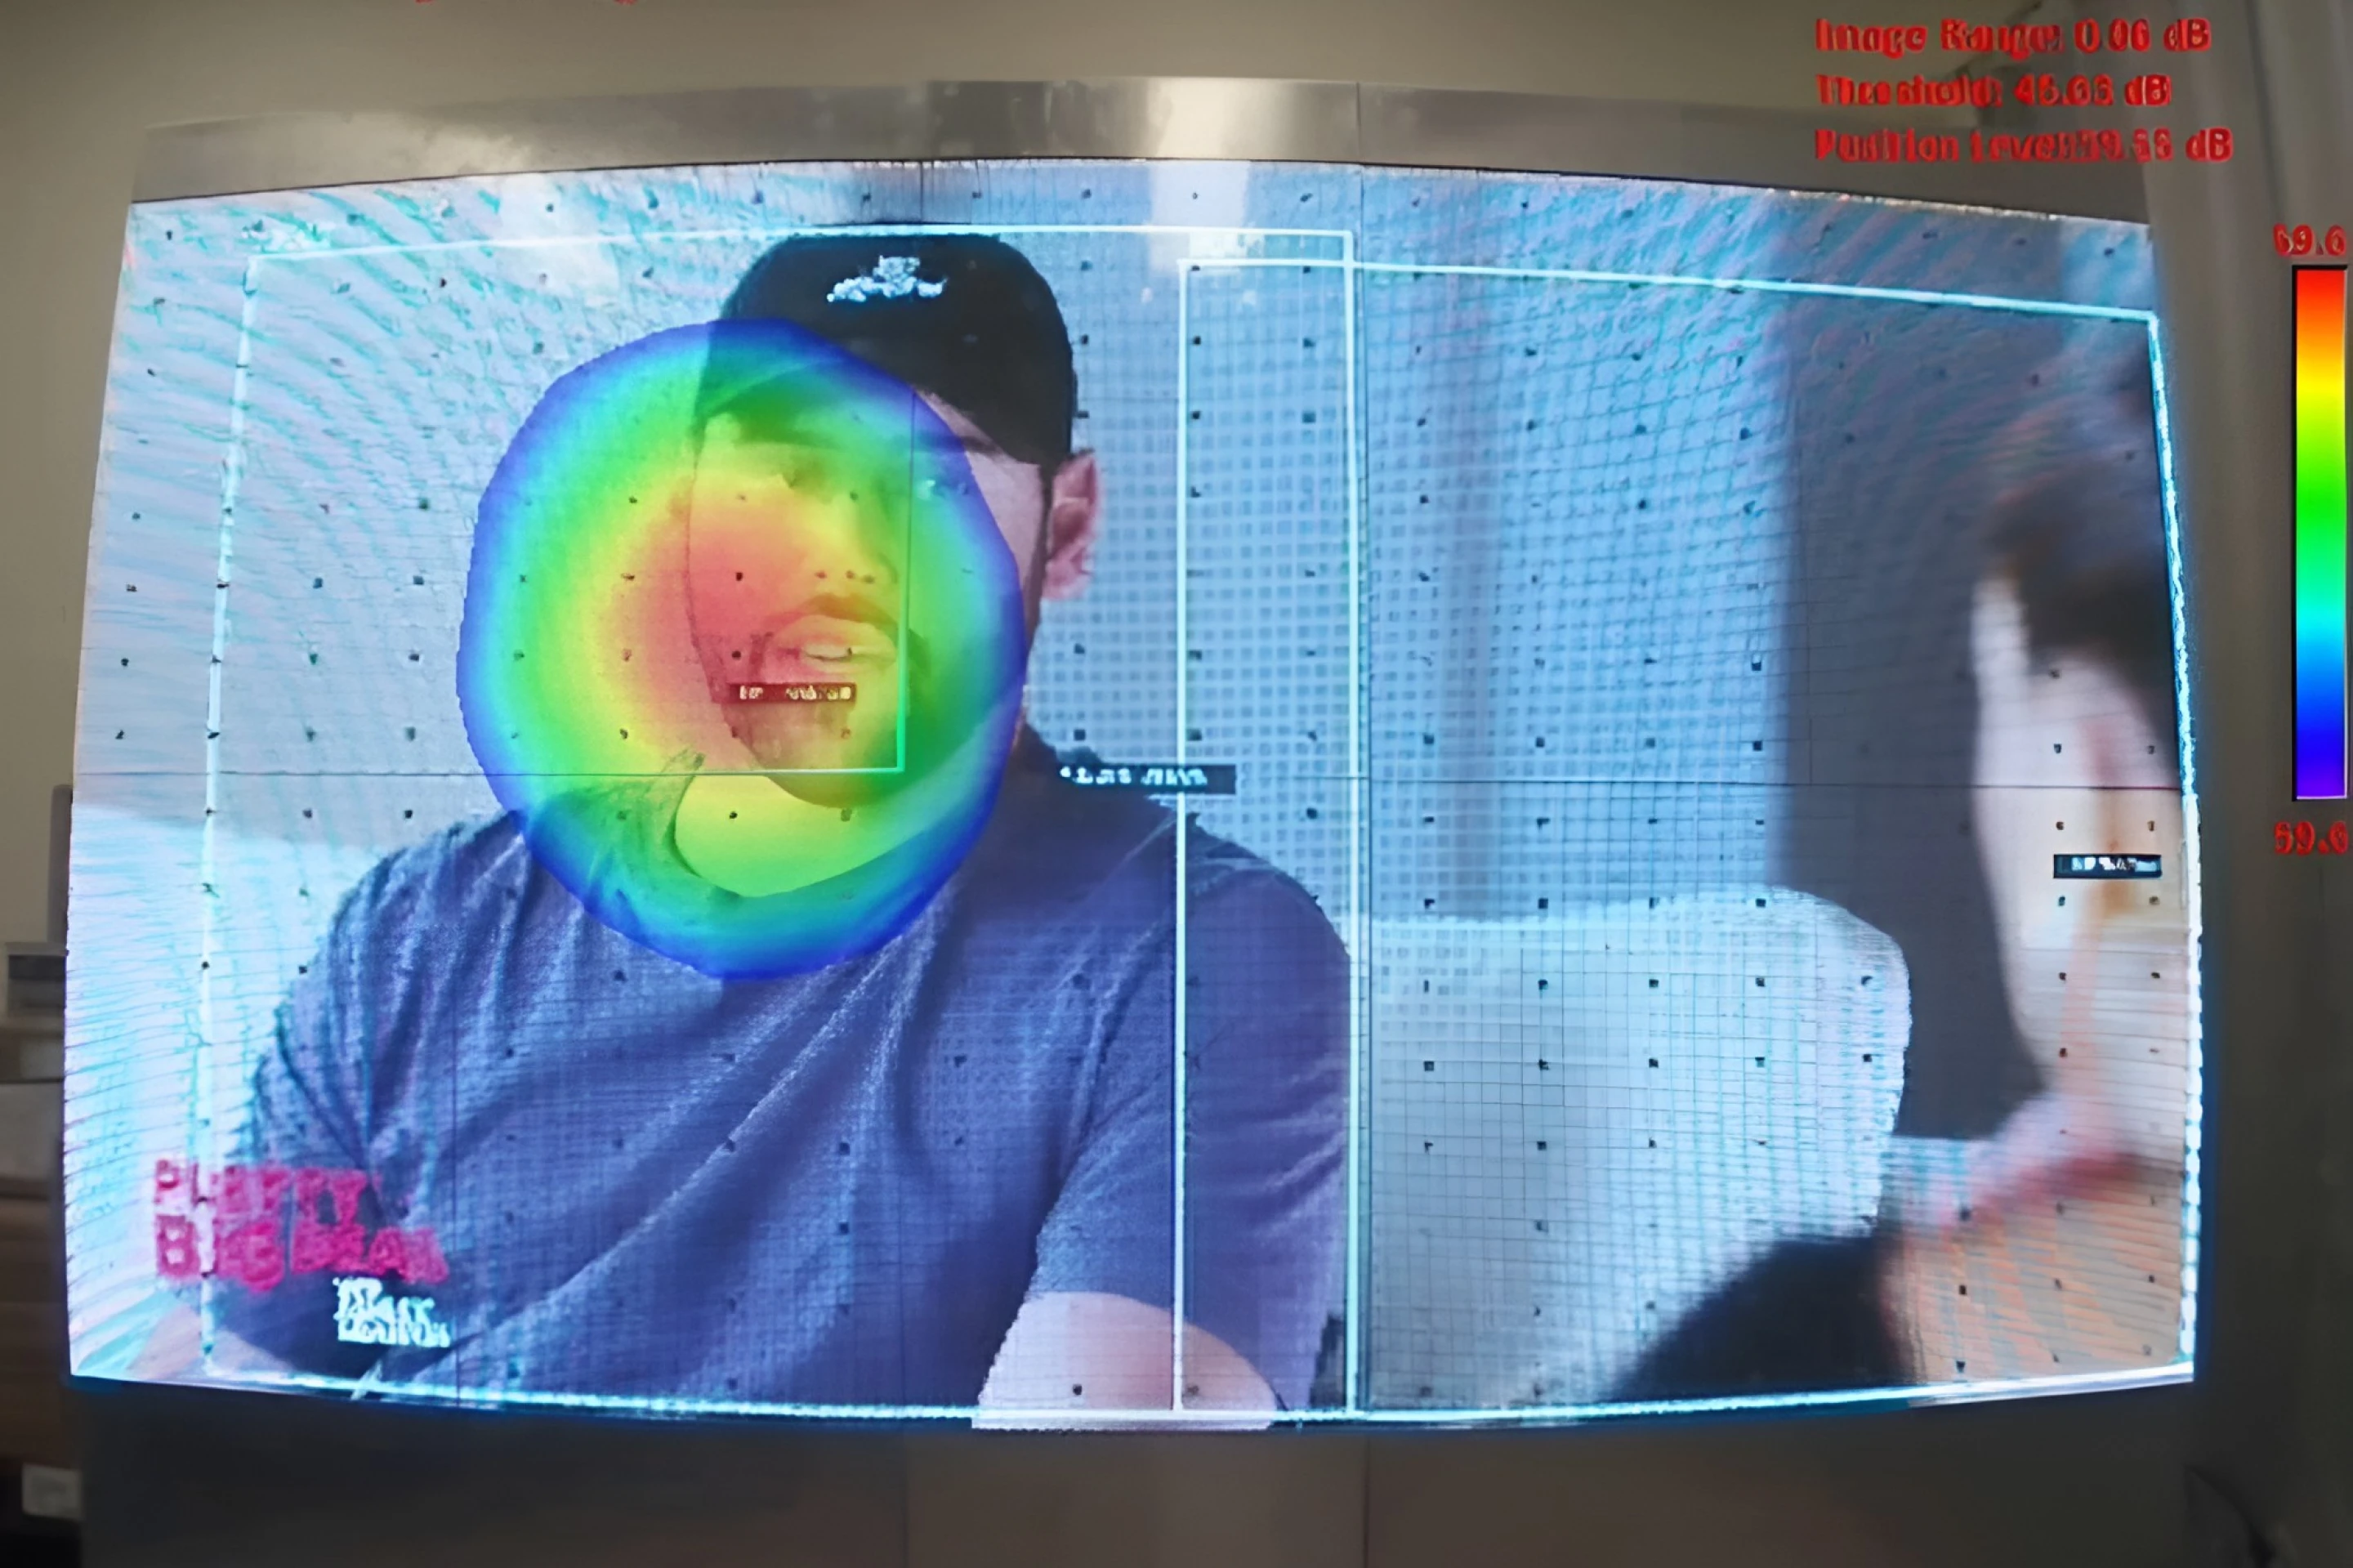
تظهر نتائج الاختبار أن النظام الأولي يتمتع بدقة تبلغ 99.9% في اختيار منطقة الصوت المستهدفة. ويصل الفرق في سعة الاهتزاز بين المنطقة النشطة والمنطقة غير النشطة إلى 35 ديسيبل، مما يثبت أن النظام يمكنه تركيز الاهتزازات بدرجة عالية في مناطق معينة وقمع الاهتزازات بشكل فعال في مناطق أخرى. وأكدت الاختبارات باستخدام الكاميرا الصوتية أيضًا أن موضع إخراج الصوت يمكنه متابعة هدف متحرك بشكل مستمر على الشاشة.
تم نشر نتائج الأبحاث ذات الصلة في مجلة العلوم والتكنولوجيا الميكانيكية. حاليًا، أثبتت هذه التقنية قدرات جيدة في تحديد موضع مجال الاهتزاز في نطاقات التردد المنخفضة والمتوسطة أقل من 500 هرتز.
من أجل التكيف مع أجهزة العرض ذات الأحجام المختلفة، اعتمد فريق البحث تصميمًا شبكيًا معياريًا. يمكن دمج وحدات العرض المتعددة أو تقسيمها بحرية حسب الحاجة، لذلك من الناحية النظرية يمكن استخدامها لأجهزة التلفزيون المنزلية ويمكن أيضًا توسيعها لتشمل سيناريوهات العرض التجارية مثل جدران العرض LED الكبيرة واللافتات الرقمية. وقال الباحثون أيضًا إنه عندما تعمل وحدات متعددة في وقت واحد، يمكن للنظام أن ينتج تأثيرًا منخفض التردد مشابهًا لتأثير مكبر الصوت الكبير.
يعتقد فريق البحث أن توحيد الصوت والصور على نفس السطح يمكن أن يعزز بشكل كبير تجربة الجمهور الغامرة. بالإضافة إلى مجال التلفزيون، من المتوقع أيضًا استخدام هذه التقنية في سيناريوهات مثل فنون الوسائط والعروض المسرحية وعروض المعارض وأنظمة العرض المثبتة على المركبات في المستقبل.
د. وقال جين دونغ جون، قائد المشروع البحثي، إن الفريق يخطط لتوسيع هذه التكنولوجيا لتشمل أنظمة عرض الربط LED المعيارية وتعزيز تطويرها إلى جيل جديد من التكنولوجيا الأساسية المناسبة لمجموعة واسعة من أجهزة العرض.
ومع ذلك، اعترف الباحثون أيضًا أنه على الرغم من قدرة النظام على محاكاة بعض تأثيرات وحدة صوت جهير كبيرة، إلا أنه لا يزال من الصعب استبدال نظام صوت احترافي مستقل تمامًا من حيث جودة الصوت الشاملة وأداء ضغط الصوت وقدرات تغطية النطاق الكامل. ومع ذلك، نجحت هذه التقنية في حل مشكلة عدم المحاذاة المكانية طويلة الأمد المتمثلة في "الصور في مكان والصوت في مكان آخر"، مما يجعل كل شيء على الشاشة يبدو وصوتًا أكثر واقعية وطبيعية.
التعليقات