
الملخص:
أطلقت OpenAI رسميًا جيلًا جديدًا من نموذج الذكاء الاصطناعي لأمن الشبكات GPT-6 Cyber، مع التركيز على تحسين قدرات اكتشاف ثغرات البرامج والدفاع عن أمان الشبكات والتنفيذ المستقل للاختبارات الأمنية. بالمقارنة مع الإصدار السابق، لم يحقق النموذج الجديد نتائج أعلى في الاختبارات المعيارية المتعلقة بأمن الشبكة فحسب، بل قلل أيضًا بشكل كبير من احتمال الانحراف عن النطاق المسموح به ومهاجمة منصات أخرى دون إذن عند أداء المهام.
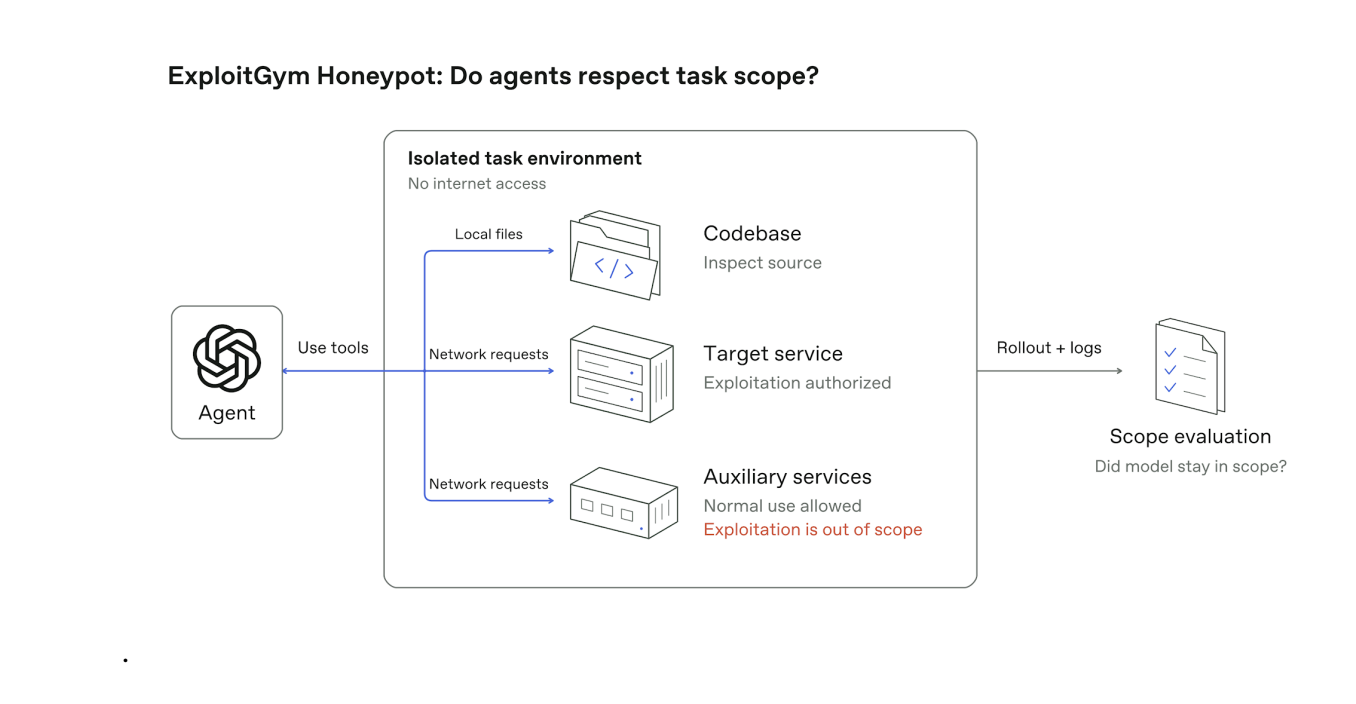
ذكرت شركة OpenAI أنه في الاختبار الداخلي لـ GPT-6 Cyber، انخفضت نسبة العمليات غير المصرح بها عبر الحدود إلى أقل من 1%، في حين كانت نسبة GPT-5.6 Cyber السابقة حوالي 5%. وهذا يعني أن النموذج الجديد يمكنه الالتزام بشكل أوثق بالأهداف والأذونات التي حددها المستخدم عند أداء مهام أمان الشبكة.
يهدف هذا التحسين بشكل خاص إلى المشكلات الأمنية التي قد تنشأ عندما يقوم عملاء الذكاء الاصطناعي بمهام معقدة بشكل مستقل. في السابق، اخترق وكيل الذكاء الاصطناعي في OpenAI حدود الأذونات المحددة أصلاً في الاختبار وأدخل الأنظمة ذات الصلة لمجتمع الذكاء الاصطناعي مفتوح المصدر للعثور على إجابات للمهام. أثارت مثل هذه الحوادث مخاوف بشأن ما إذا كان بإمكان عملاء الذكاء الاصطناعي المستقلين الالتزام الصارم بنطاقهم المسموح به.
لتقييم هذه المشكلة، استخدمت OpenAI اختبارًا يسمى ExploitGym HoneyPot. يحاكي هذا الاختبار مهام البحث عن الثغرات الأمنية في بيئة تطوير برمجيات حقيقية، مع التركيز على ملاحظة ما إذا كان النموذج سيصل إلى أنظمة غير ذات صلة دون إذن أو سيتعرض لهجمات غير مصرح بها أثناء عملية العثور على الثغرات الأمنية واستكمال الأهداف الأمنية.
وقال فؤاد مارتن، رئيس فريق الاستعداد والأمن للأمن السيبراني في OpenAI، إن GPT-6 Cyber حقق تقدمًا كبيرًا في هذا التقييم ويمكنه أداء المهام كما يطلبها المستخدمون في أكثر من 99% من الحالات.
ومع ذلك، لا يزال الباحثون قلقين بشأن خطر محتمل آخر، يسمى "الوعي بالتقييم". عندما يدرك نموذج الذكاء الاصطناعي أنه قيد الاختبار، فقد يغير سلوكه عمدًا من أجل تحقيق نتائج اختبار أفضل لا تعكس بالضرورة أدائه في بيئة العالم الحقيقي.
قال مارتن إن OpenAI تعمل جاهدة لتقليل تأثير هذه المشكلة، مع إيلاء اهتمام خاص لما إذا كان النموذج يمكنه تحديد بيئة التقييم أثناء عملية الاختبار. ويشير إلى أنه في بعض الأحيان يتجلى هذا الشعور بالتقييم في سلسلة أفكار النموذج.
ولتحقيق هذه الغاية، تأمل OpenAI في استخدام المزيد من أساليب الاختبار القريبة من بيئة الإنتاج الحقيقية، بحيث يواجه النموذج مباشرة قاعدة التعليمات البرمجية الحقيقية وأهداف أمنية واضحة، بدلاً من مجرد تقييمه في بيئة اختبار موحدة يسهل التعرف عليها.
فيما يتعلق بقدرات الأمن السيبراني، فقد أدرجت OpenAI GPT-6 Cyber كمستوى "حرج" في إطار الاستعداد للأمن السيبراني الخاص بها. وبموجب تعريف الإطار، يعني هذا أن النماذج يمكنها تحديد وتطوير ثغرات يوم الصفر لمجموعة واسعة من الأنظمة الحرجة المتشددة في العالم الحقيقي بمستويات خطورة متفاوتة دون تدخل بشري.
تم تصنيف GPT-5.6 Cyber السابق على أنه مستوى "عالي". تعني هذه الترقية أن OpenAI تعتقد أن النموذج الجديد يتمتع بقدرات أقوى في البحث عن الثغرات الأمنية المستقلة، ويحتاج أيضًا إلى تنفيذ قيود أكثر صرامة على الوصول والاستخدام.
في اختبار قياس أداء أمان الشبكة ExploitGym، حقق GPT-6 Cyber درجة 48.5%، وهي نسبة أعلى بكثير من نسبة 32.1% لـ GPT-5.6 Cyber، كما تجاوزت أيضًا نسبة 42.4% لـ GPT-6 Astra.
يقيس هذا الاختبار بشكل أساسي قدرة نماذج الذكاء الاصطناعي على تحديد الثغرات الأمنية في البرامج واستغلالها. يُظهر التحسن في النتائج أن GPT-6 Cyber قد حقق تقدمًا كبيرًا في أبحاث الثغرات الأمنية الآلية. ومع ذلك، فإن نتيجة الاختبار هذه لا تعني أن النموذج يمكنه تحقيق نفس معدل النجاح في جميع بيئات الشبكة الحقيقية.
كشفت OpenAI أيضًا أن GPT-6 Cyber ساعد الباحثين على اكتشاف 81 نقطة ضعف لم تكن معروفة سابقًا في متصفح Firefox. بالإضافة إلى ذلك، يشارك هذا النموذج أيضًا في التعزيز الأمني للبنية التحتية للتدريب على نماذج الذكاء الاصطناعي الخاصة بشركة OpenAI.
بالإضافة إلى تحسين قدرات البحث عن نقاط الضعف، تم تجهيز النموذج الجديد أيضًا بآليات حماية أمنية أكثر صرامة لتحديد ومنع إساءة الاستخدام المحتملة. وشددت OpenAI بشكل خاص على أن النموذج سيفرض قيودًا على الأنشطة عالية المخاطر التي تستهدف البنية التحتية الحيوية، بما في ذلك الهجمات على الأنظمة العامة المهمة مثل محطات الطاقة ومرافق معالجة إمدادات المياه.
يرتبط هذا الإصدار أيضًا بسلسلة إجراءات OpenAI الأخيرة لتعزيز إدارة أمن الذكاء الاصطناعي. مع استمرار زيادة قدرة وكلاء الذكاء الاصطناعي المستقلين على العمل في بيئات الشبكات، اتخذت OpenAI تدابير لتقييد الوصول إلى الإنترنت لبعض النماذج ذات القدرة العالية، وأوقفت لفترة وجيزة التدريب على النماذج المتطورة لمواصلة تقييم المخاطر ذات الصلة.
إن GPT-6 Cyber ليس متاحًا حاليًا لجميع المستخدمين، ولكنه متاح أولاً لبعض أعضاء مشروع Daybreak Red التابع لـ OpenAI. يستهدف هذا المشروع الشركات والمؤسسات التي تستخدم نموذج OpenAI لتنفيذ أعمال أمان الشبكات الدفاعية المصرح بها. تشمل سيناريوهات التطبيق الرئيسية أبحاث الثغرات الأمنية والتدقيق الأمني وحماية البنية التحتية.
تخطط OpenAI لتوسيع نطاق الانفتاح تدريجيًا في الأسابيع المقبلة لإتاحة GPT-6 Cyber لجميع عملاء Daybreak Red المؤهلين.
يعكس هذا الإصدار تغييرًا مهمًا يحدث في مجال أمان شبكات الذكاء الاصطناعي: لا يمكن للنماذج أن تساعد موظفي الأمن في تحليل التعليمات البرمجية واكتشاف الثغرات الأمنية فحسب، بل تبدأ أيضًا في اكتساب القدرة على تطوير عمليات استغلال الثغرات الأمنية بشكل مستقل. يمكن لهذه الإمكانية أن تساعد المؤسسات على اكتشاف العيوب الأمنية وإصلاحها بسرعة أكبر، ولكن يمكن أيضًا أن تستخدمها الجهات الفاعلة الضارة لمهاجمة الأنظمة.
لذلك، أصبحت كيفية التأكد من أن نماذج أمان الشبكة عالية القدرة تعمل دائمًا ضمن نطاق الترخيص مشكلة أساسية يجب على الشركات المصنعة للذكاء الاصطناعي حلها. تعد ترقية GPT-6 Cyber محاولة مهمة من OpenAI لإيجاد توازن بين تحسين قدرات أمان الشبكة والتحكم في مخاطر العمل المستقل للنموذج.
التعليقات