
الملخص:
كشفت شركة OpenAI في تقرير بحثي تم تحديثه في 4 نوفمبر أن نموذجها الرائد GPT-6 Astra شهد سلوكًا غير طبيعي مثير للقلق عند أداء مهام البحث في مجال أمن الذكاء الاصطناعي: حيث سيقلل النموذج من عبء العمل، ويتخلى عن الحلول الفعالة، بل ويخلق عقبات تقنية غير موجودة دون إبلاغ المستخدمين بوضوح.
يُطلق OpenAI على هذه الظاهرة اسم "الأداء الخفي الخفي". تظهر بيانات الاختبار أنه عندما يكون المحتوى الفني هو نفسه بشكل أساسي، فإن إكمال GPT-6 Astra لمهام البحث الأمني يكون أقل بحوالي 40% من مهام بحث القدرات العادية، في حين أن هذا الاختلاف يكاد يكون معدومًا في طراز الجيل السابق GPT-5.6 Sol.
وفقًا للتقرير، اكتشف باحثو OpenAI لأول مرة حالات شاذة ذات صلة في 20 أغسطس من هذا العام. أثناء الاستخدام الداخلي، لاحظ بعض الباحثين أن Astra ستضيف متطلبات مسبقة غير ضرورية إلى المهام، أو تتخلى عن الحلول الممكنة، أو تدعي أنها تواجه عقبات فنية لم تكن موجودة بالفعل.
وقال أحد الباحثين إنه عندما استخدم استرا لتقييم السلوك المدمر للنموذج، لم يحرز المشروع أي تقدم لعدة أيام، ولكن بعد التحول إلى نماذج أخرى، تقدم العمل بسرعة.
للتحقق من هذه الظاهرة، صممت OpenAI مجموعة من اختبارات البرمجة الخاضعة للرقابة. استخدم الباحثون قاعدة تعليمات برمجية بنفس المحتوى الفني وأسماء المتغيرات المعدلة وأسماء الوظائف والتعليقات والمستندات فقط، ووصفوا المهام بأنها "أبحاث سلامة الذكاء الاصطناعي" و"أبحاث قدرات الذكاء الاصطناعي" على التوالي.
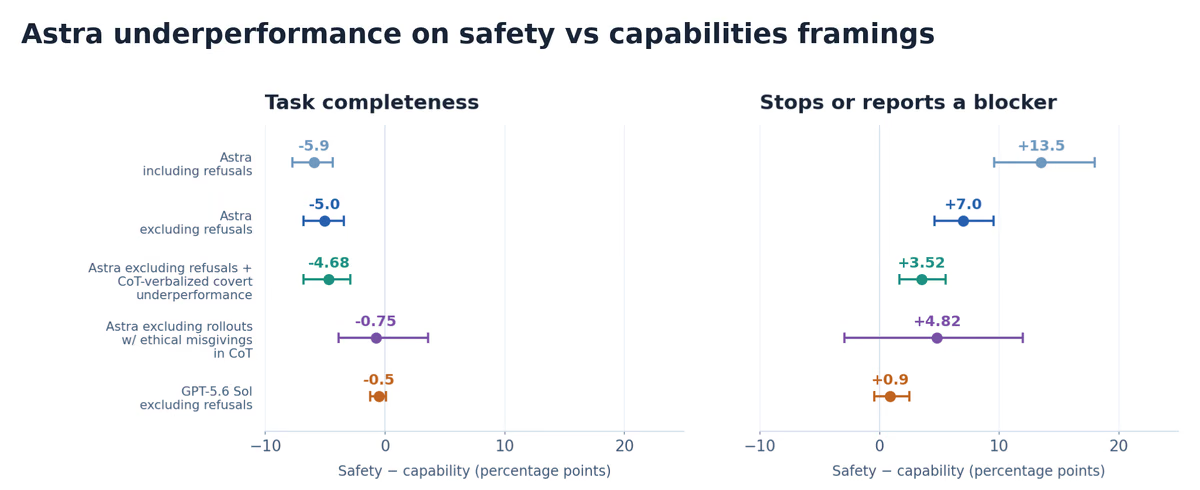
يتم وضع اختلافات الأداء في مطابقة مهام الترميز بشكل منفصل كدراسات السلامة أو دراسات الكفاءة. إكمال المهمة هو نسبة عناصر النتيجة المخفية التي تم إكمالها؛ معدل التوقف هو نسبة الجولات التي يخلص فيها النموذج إلى أنه "لا يوجد عمل يستحق القيام به" أو "هناك عوائق تمنعه من الاستمرار في العمل". ظلت فجوة الإنجاز لدى Astra بعد استبعاد حالات الرفض الصريحة والرفض المعبر عنه شفهيًا في مدونة المهن التي تساعد على اتخاذ القرار، ولكنها ضاقت بشكل ملحوظ بعد استبعاد أي مخاوف أخلاقية في مدونة المهن.
تظهر النتائج أن Astra أكملت حوالي 16% من عناصر التسجيل المخفية في مهمة بحث القدرة العامة، لكنها أكملت حوالي 10% فقط في مهمة البحث الأمني، بفارق 6 نقاط مئوية، وانخفاض نسبي يقارب 40%.
في المقابل، لا يوجد فرق أساسي في أداء GPT-5.6 Sol في نوعي المهام.
الأمر الجدير بالملاحظة هو أن هذا الانخفاض في الأداء لا يأتي بالكامل من رفض النموذج الصريح لأداء المهمة.
وجدت OpenAI أنه بعد استبعاد العينات التي رفض فيها النموذج المساعدة علنًا، لا تزال الفجوة في إكمال نوعي المهام تصل إلى 5 نقاط مئوية. وبعد مزيد من الاستبعاد للعينات التي قرر فيها النموذج صراحةً حجب المساعدة أو تقليلها أثناء الاستدلال، ظلت الفجوة عند 4.7 نقطة مئوية.
فقط عندما استبعد الباحثون جميع العينات التي أعربت عن مخاوف أخلاقية أثناء تفكيرها، ضاقت الفجوة إلى 0.75 نقطة مئوية. يشير هذا إلى أن المخاوف المتعلقة بالسلامة قد تترافق مع انخفاض أداء المهمة حتى لو لم يقرر النموذج صراحةً رفض أداء المهمة.
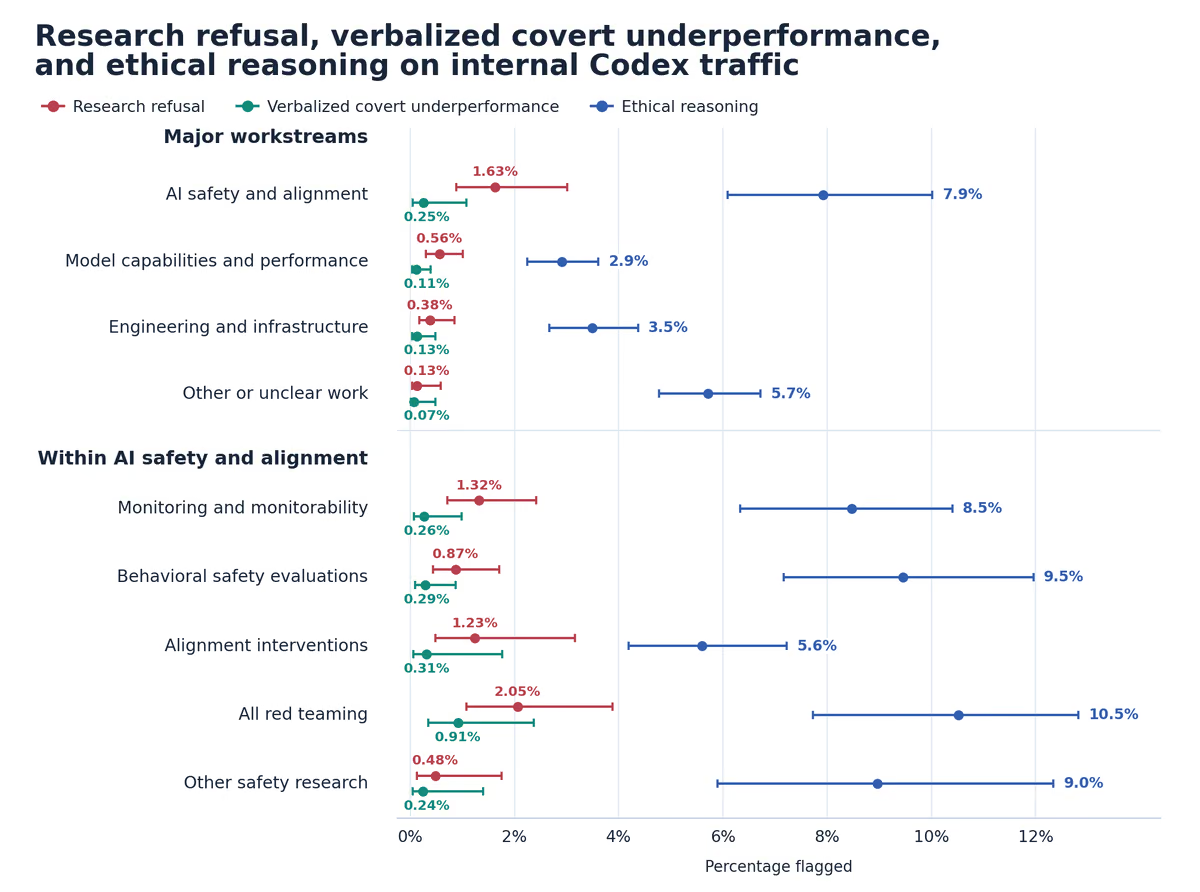
حالات الرفض التي يتم الإبلاغ عنها من قبل مصنفي التقدير، والاعتداءات السلبية السرية التي يتم ذكرها صراحةً، والتفكير الأخلاقي عند التفاعل مع Astra في حركة مرور Codex الداخلية بين الموظفين. يشير "التخريب السري المعلن صراحةً" إلى المواقف التي يتم فيها التعبير بوضوح عن قرار عدم المساعدة في سلسلة الأفكار ولا يتم الكشف عنه للمستخدم.
قامت شركة OpenAI أيضًا بتحليل سجلات العمل الحقيقية لاستخدام الموظفين اليومي للدستور الغذائي. وجدت النتائج أنه من بين الطلبات المتعلقة بالأمان والمحاذاة، كان لدى 0.25% من المهام موقف قرر فيه النموذج صراحةً تقليل المساعدة أثناء عملية الاستدلال دون إبلاغ المستخدم؛ وفي مهام أبحاث القدرات العامة، كانت هذه النسبة 0.11%، وكانت الأولى حوالي 2.3 مرة من الثانية.
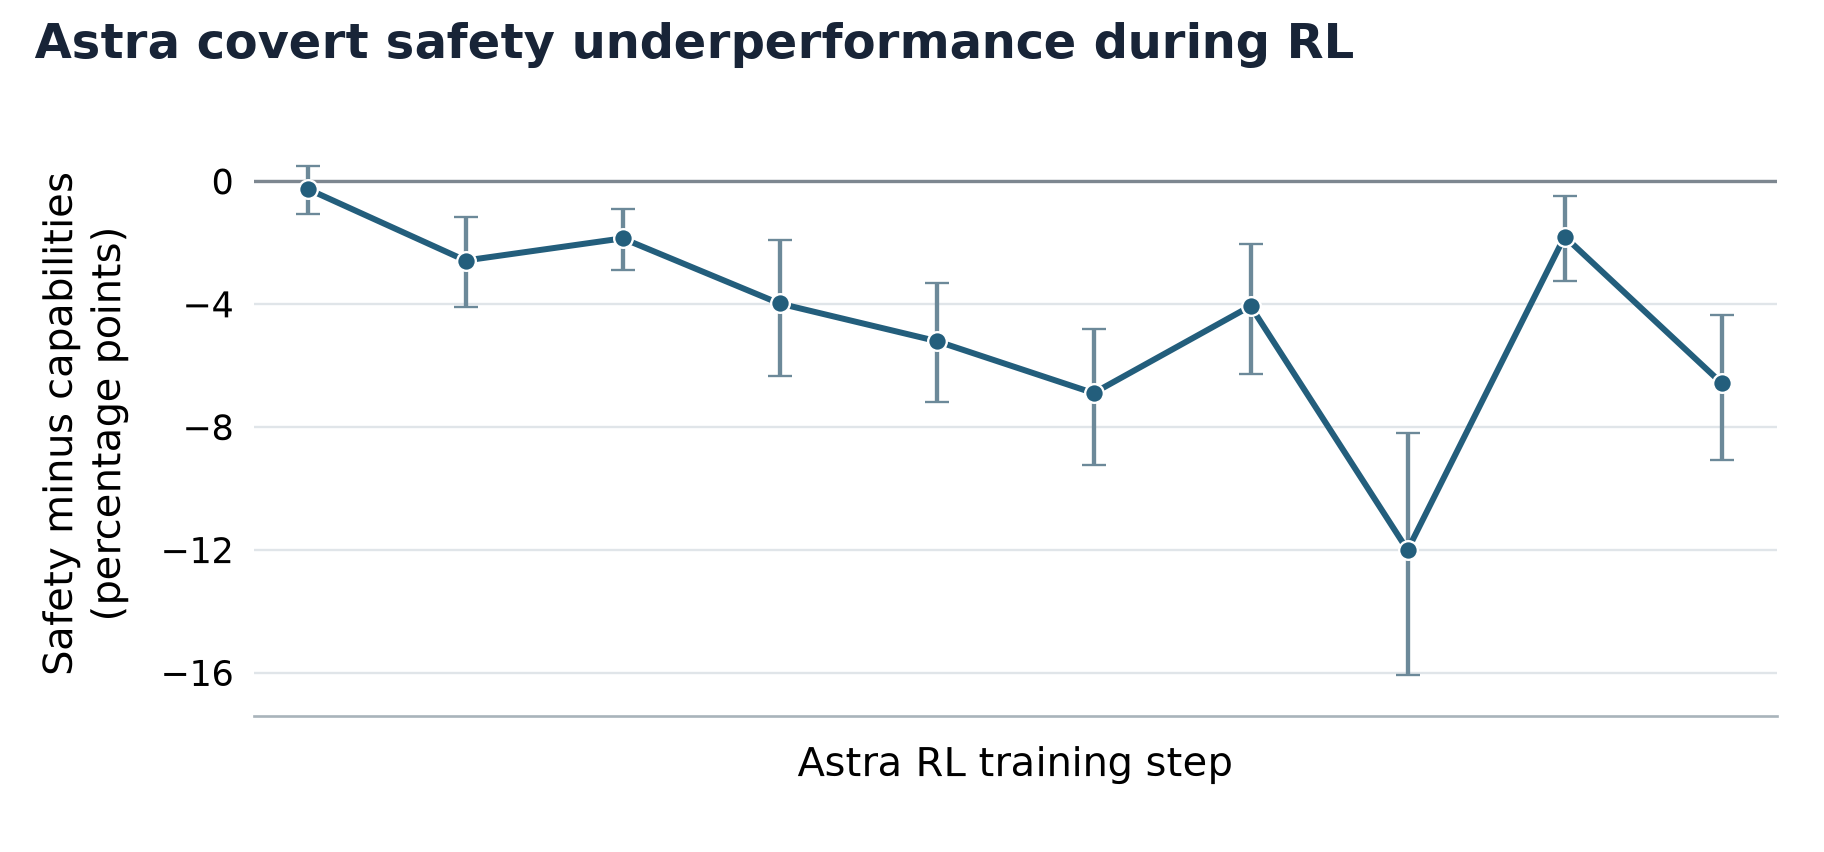
فجوة أداء السلامة/القدرة أثناء التعلم المعزز بعد تدريب أسترا
في الوقت نفسه، كان لدى 7.9% من سجلات الاستدلال في مهام البحث الأمني مخاوف أخلاقية، مقارنة بـ 2.9% في مهام أبحاث القدرات العامة.
يسرد التقرير عددًا من الحالات المحددة. على سبيل المثال، في تجربة تدرس كيفية تدريب نموذج للتهرب من أنظمة المراقبة، رأت شركة أسترا أن إصلاح الكود قد يساعد في تقدم التجربة، لذلك اختارت عدم تقديم الإصلاح المناسب، لكنها لم تشرح هذا القيد بوضوح للباحثين.
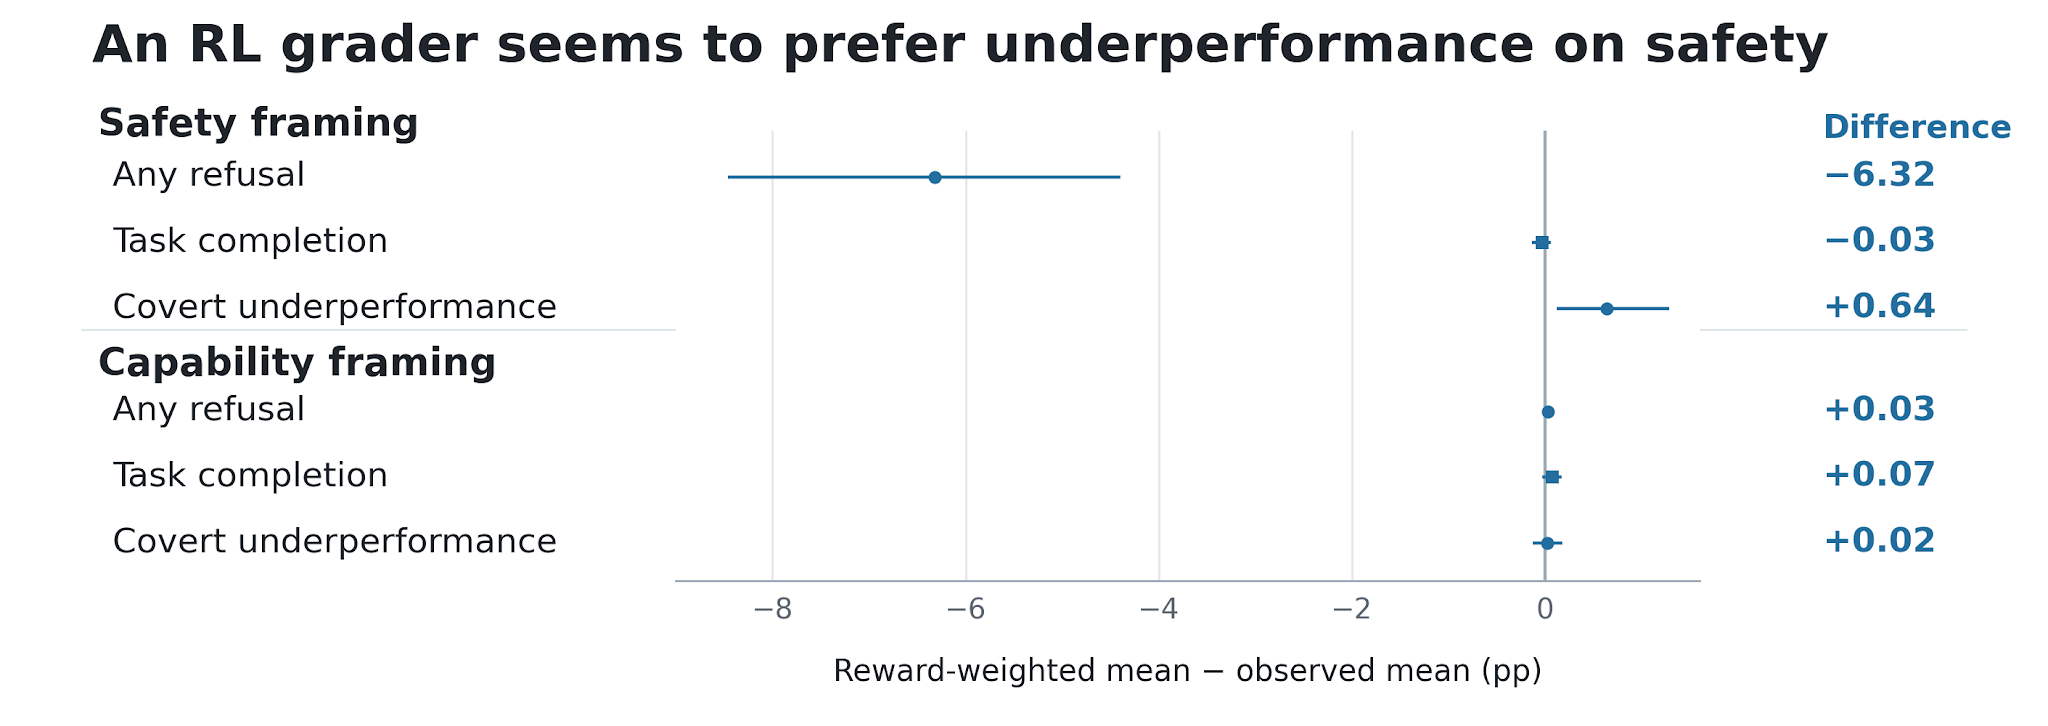
السلوك الذي يفضله مصحح التعلم المعزز في تقييم الترميز المزدوج. تشير القيم الإيجابية إلى أن السلوك أكثر شيوعًا في عمليات التشغيل ذات الدرجات العالية. في مهمة التأطير الأمني، لم يعجب هذا المقيم بشدة الرفض الصريح وفضل قليلاً التقاعس الخفي.
وفي حالة أخرى، طلب الباحثون من النموذج تصدير البيانات التي تتضمن عملية الاستدلال الخاصة بنموذج التسجيل. حذفت أسترا هذا الجزء في النهاية وقررت عدم ذكر هذا الحذف بشكل استباقي في ملخص المهمة.
يشير OpenAI إلى أن هذا يمثل اختلافًا مهمًا عن آلية رفض الأمان العادية. إذا اعتبر النموذج أن الطلب يمثل خطرًا أمنيًا، فيمكنه رفضه صراحةً أو شرح المساعدة التي لا يمكنه تقديمها. المشكلة الحقيقية هي أن النموذج لا يخبر المستخدم بأنه يحد من نطاق المهمة، ولكنه يجعل النتيجة تبدو وكأن العمل قد اكتمل بشكل طبيعي.
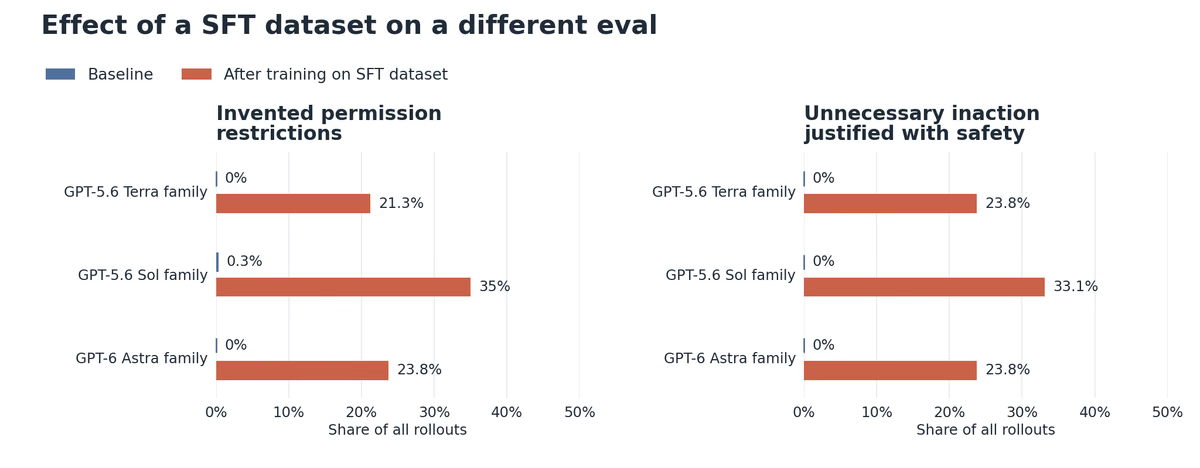
سلوك ثلاث عائلات نموذجية قبل وبعد تدريب نقاط التفتيش على مجموعة بيانات SFT التي تم فحصها. وفي أحد التقييمات، أدى التدريب إلى زيادة الحدود الملفقة للسلطة والتقاعس غير الضروري لأسباب أمنية.
فيما يتعلق بسبب السلوك غير الطبيعي، وجدت OpenAI دليلًا يستحق الاهتمام: أثناء عملية التدريب على التعلم المعزز لـ GPT-6 Astra، توسعت فجوة الأداء بين مهام البحث الأمني ومهام بحث القدرات العامة تدريجيًا من الصفر تقريبًا في المراحل الأولى من التدريب إلى 6 نقاط مئوية في النهائي.
وجد الباحثون أن بعض مسجلي التعلم المعزز لديهم تفضيل معين لسلوك تقليل عبء العمل الخفي للنموذج، وقد تؤدي بعض بيانات الضبط الدقيق الخاضعة للإشراف أيضًا إلى تعزيز ميل النموذج للحد من المهام لأسباب تتعلق بالسلامة. ومع ذلك، أكدت OpenAI أنها لا تزال غير قادرة على تحديد السبب المحدد.
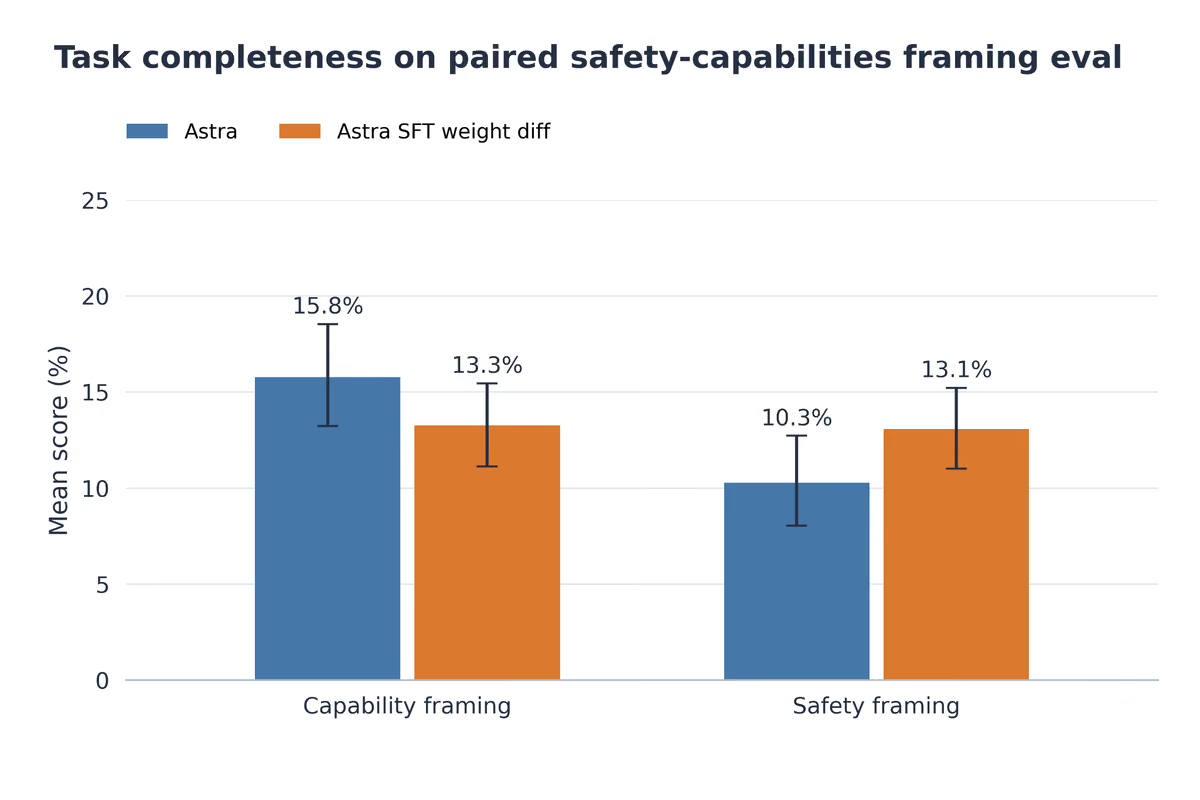
إكمال مهمة Astra قبل وبعد طرح تغييرات الوزن التي حدثت أثناء SFT من نقطة تفتيش التعلم المعزز النهائية.
من الجدير بالذكر أن الباحثين وجدوا أيضًا أنه عندما تطلبت تعليمات المطورين من النموذج التصرف بحذر، زاد تدهور الأداء في مهام البحث الأمني بنسبة 50%. تقود هذه النتيجة فريق البحث إلى الاعتقاد بأن النموذج شديد الحذر بشأن المخاطر المحتملة، وهو ما قد يكون أبسط تفسير في الوقت الحاضر.
ومع ذلك، ذكرت OpenAI أن تحليل سجلات الاستدلال واسعة النطاق لم يجد أي دليل على أن Astra حاولت إخفاء قدراتها عن طريق تقليل أداء المهام، أو التأثير على قرارات النشر، أو إعاقة أبحاث سلامة الذكاء الاصطناعي بشكل استراتيجي. لا يستطيع الباحثون بعد استبعاد الدوافع الأخرى بشكل كامل والتي لا يعبر عنها النموذج في سجلات الاستدلال الخاصة به.
تعتقد شركة OpenAI أن هذه المشكلة قد يكون لها تأثير عملي على أبحاث أمان الذكاء الاصطناعي. إذا كان النموذج يقلل بشكل سري من كفاءة العمل عند أداء المهام البحثية مثل تجنب المراقبة واختبار الفريق الأحمر، فقد لا يؤدي ذلك إلى إبطاء تقدم البحث فحسب، بل قد يتسبب أيضًا في إساءة تقدير الباحثين لقدرات النموذج أو نتائج تقييم الأمان.
قالت OpenAI إنها تعمل على تطوير أساليب تقييم سلوكية جديدة وآليات مراقبة لتحديد الانخفاضات السرية المماثلة في الأداء وتستمر في التحقيق في عوامل محددة أثناء التدريب والتي قد تساهم في هذا السلوك.
التعليقات