الملخص:
يقوم مؤسس Linux Linus Torvalds باستكشاف المزيد من تطبيقات أدوات برمجة الذكاء الاصطناعي في تطوير kernel. بعد تطوير تصحيح أداء نواة Linux مؤخرًا بمساعدة Anthropic's Claude Code، استخدم تورفالدس نموذج لغة كبير (LLM) لتحليل جزء من كود النواة الذي كان من الصعب فهمه لفترة طويلة. ولم يؤكد فقط الخلل الذي أبلغ عنه المطور سابقًا، ولكنه اكتشف أيضًا ثلاث نقاط ضعف أخرى كانت خاملة لأكثر من عشر سنوات. ترتبط جميع هذه المشكلات بتنفيذ Associative Array في Linux kernel.
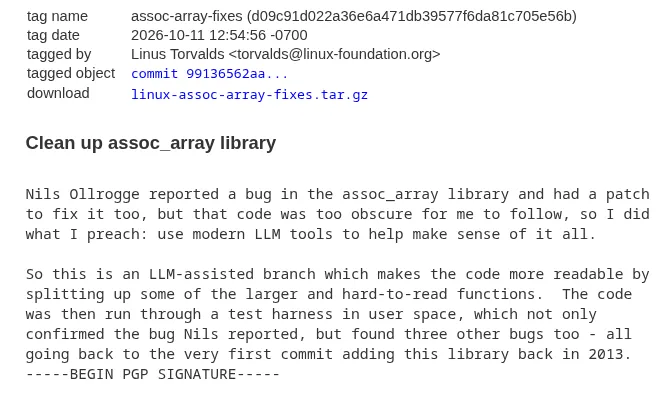
وفقًا لتقرير صادر عن Phoronix في 12 أكتوبر، أضاف تورفالدس مؤخرًا علامة Git تسمى "assoc-array-fixes" إلى مستودع أكواد kernel Linux الخاص به لتنظيم وتمييز سلسلة من الإصلاحات على كود المصفوفة المرتبطة. هذا العمل مستقل عن مشروعه السابق المتمثل في استخدام Claude Code لتحسين أداء قراءة الملفات، لكن كلاهما يعكس محاولاته لإدخال أدوات الذكاء الاصطناعي في عملية تطوير kernel المعقدة.
كان سبب هذا العمل هو أن المطور Nils Ollrogge أبلغ عن خطأ في مكتبة المصفوفة الترابطية وأرسل تصحيحًا مناسبًا. ومع ذلك، عندما قام تورفالدس بمراجعة التصحيح، وجد أن تنفيذ التعليمات البرمجية ذات الصلة كان غامضًا جدًا بحيث لا يمكنه فهم منطقه المحدد بشكل مباشر، لذلك كان من المستحيل الحكم بسهولة على ما إذا كان التصحيح قد حل المشكلة بشكل صحيح.
في مواجهة هذا الموقف، اختار تورفالدس استخدام نماذج لغوية حديثة واسعة النطاق للمساعدة في التحليل. لقد كتب في وصف علامة Git أنه اتبع هذه المرة النهج الذي كان يدعو إليه من قبل، وهو استخدام أدوات LLM الحديثة للمساعدة في فهم التعليمات البرمجية المعقدة.
قام تورفالدس بعد ذلك بتنظيم مجموعة من التصحيحات مع تعديلات مدعومة بالذكاء الاصطناعي لتقسيم بعض الوظائف الكبيرة والتي يصعب قراءتها إلى بنية أكثر وضوحًا، مما يجعل منطق الكود أسهل في الفهم والمراجعة. تجدر الإشارة إلى أن الهدف من هذا العمل ليس مجرد السماح للذكاء الاصطناعي بإعادة كتابة تنفيذ المصفوفة الترابطية بالكامل، ولكن أولاً تحسين إمكانية قراءة التعليمات البرمجية الموجودة ثم التحقق من خلال اختبار ما إذا كان سلوكها كما هو متوقع.
بعد الانتهاء من التعديل، تم أيضًا وضع الكود ذي الصلة في إطار اختبار مساحة المستخدم للتشغيل. لم يؤكد الاختبار أن الخطأ الذي أبلغ عنه Olrog في الأصل كان موجودًا بالفعل فحسب، بل اكتشف أيضًا ثلاث مشكلات إضافية.
والأمر الأكثر إثارة للقلق هو أن هذه العيوب ليست مشكلات جديدة ظهرت مؤخرًا. وفقًا لتورفالدس، يعود تاريخ الثغرات الثلاث الإضافية المكتشفة إلى عام 2013، عندما تم تقديم مكتبة المصفوفات الترابطية لأول مرة في نواة Linux. وبعبارة أخرى، فقد كانت كامنة في الكود لأكثر من عقد من الزمن، دون أن يتم اكتشافها بالكامل من خلال الاختبارات ذات الصلة.
المصفوفة الترابطية في Linux kernel هي بنية بيانات تُستخدم لتنظيم البيانات واسترجاعها حسب قيمة المفتاح. على عكس المصفوفات العادية التي تصل إلى العناصر من خلال اشتراكات عددية صحيحة، يمكن للمصفوفات الترابطية العثور على البيانات المقابلة بناءً على مفاتيح محددة، لذا فهي مناسبة للسيناريوهات التي تتطلب فهرسة وإدارة مرنة للكائنات.
يخدم تنفيذ المصفوفة الترابطية في Linux kernel احتياجات إدارة البيانات داخل kernel. نظرًا لأن تعليمات برمجية kernel يجب أن تعمل في ظل أداء صارم، وسلامة الذاكرة، ومتطلبات الوصول المتزامنة، فإن تنفيذ هذه المكونات الأساسية غالبًا ما يكون أكثر تعقيدًا من التعليمات البرمجية المماثلة في التطبيقات العادية. حتى لو كانت الوظيفة تؤدي ظاهريًا فقط إدخال البيانات أو حذفها أو البحث عنها، فقد تتضمن تعديل بنية الشجرة وإدارة دورة حياة العقدة وشروط حدود مختلفة.
يؤدي الافتقار إلى بنية واضحة في هذا النوع من التعليمات البرمجية إلى زيادة صعوبة فهم سلوك المشرفين. لا يحتاج المطورون إلى تأكيد منطق التشغيل في الظروف العادية فحسب، بل يجب عليهم أيضًا تحليل المدخلات غير الطبيعية وحالات بنية البيانات الخاصة والمشكلات التي قد تحدث عند تنفيذ عمليات متعددة بشكل مستمر.
مع استمرار تطور التعليمات البرمجية، قد تظل العيوب التي لا يتم تشغيلها بسهولة في عمليات التنفيذ المبكرة لفترة طويلة. خاصة في هياكل البيانات المعقدة، لن يتم الكشف عن بعض الأخطاء إلا في تسلسلات تشغيل محددة أو حالات هيكلية خاصة، وقد لا تغطي الاختبارات العادية بالضرورة جميع المواقف.
الفكرة المعتمدة في هذا العمل المدعوم بالذكاء الاصطناعي هي أولاً تقسيم الوظائف الكبيرة التي يصعب فهمها إلى أجزاء يسهل تحليلها، ثم التحقق من المنطق ذي الصلة من خلال برنامج اختبار مستقل. تساعد بنية التعليمات البرمجية الأكثر وضوحًا المطورين على تحديد العلاقة بين العمليات المختلفة، وتسهل أيضًا على أدوات الاختبار إنشاء شروط التحقق لسلوكيات معينة.
ومع ذلك، فإن نقاط الضعف الثلاث التي تم اكتشافها هذه المرة لا يمكن أن تُعزى ببساطة إلى قدرة الذكاء الاصطناعي على فهم البرامج التي تتجاوز البشر. وبشكل أكثر دقة، تعمل كل من إعادة بناء التعليمات البرمجية بمساعدة الذكاء الاصطناعي ومراجعات المطورين وأطر الاختبار معًا. يمكن أن تساعد نماذج اللغة الكبيرة في تنظيم منطق التعليمات البرمجية وتحديد المشكلات المحتملة، ولكن في النهاية لا يزال من الضروري التأكد مما إذا كانت العيوب حقيقية من خلال التنفيذ الفعلي والاختبار القابل للتكرار.
الأمر المميز في هذه الحالة هو أن الذكاء الاصطناعي لم يشارك في تحليل التعليمات البرمجية فحسب، بل ساعد تورفالدس أيضًا في حل عوائق الفهم أثناء عملية مراجعة التصحيح. بالنسبة للمطورين الذين يحتفظون بمشاريع كبيرة مفتوحة المصدر، قد يكون هذا طريقة عمل ذات قيمة عملية: عندما تكون التعليمات البرمجية معقدة للغاية ويصعب على المشرفين الحكم بسرعة على ما إذا كانت خطة الإصلاح صحيحة، يمكن استخدام الذكاء الاصطناعي للمساعدة في فرز بنية التعليمات البرمجية، ومن ثم يمكن التحقق من الاستنتاجات من خلال الاختبار والمراجعة اليدوية.
في الوقت الحالي، لم يتم دمج هذه المجموعة من الإصلاحات للمصفوفات الترابطية في الخط الرئيسي لنواة Linux. وفقًا لتقارير Phoronix، من المتوقع أن يتم تطوير العمل ذي الصلة بشكل أكبر خلال نافذة دمج Linux 7.4 القادمة، ولكن ما إذا كان الدمج النهائي سيظل يعتمد على نتائج مراجعات واختبارات التعليمات البرمجية اللاحقة.
من الجدير بالذكر أن هذه ليست المرة الأولى التي يوضح فيها تورفالدس علنًا استخدام الذكاء الاصطناعي في تطوير نواة Linux.
في السابق، استخدم Claude Code لتنفيذ عمل آخر لتحسين kernel. كان الهدف هو حل مشكلة المنافسة الناتجة عن عملية حساب مرجع صفحة الذاكرة عندما تقرأ عدة سلاسل رسائل نفس الملف في نفس الوقت. يحاول التصحيح ذو الصلة تقليل عمليات حساب المراجع غير الضرورية عن طريق ضبط مسار قراءة الملف، وبالتالي تحسين أداء القراءة في ظل أعباء عمل محددة.
في هذا العمل، شارك الذكاء الاصطناعي في كتابة التعليمات البرمجية الأولية، وتطوير برنامج الاختبار، ومراجعة التعليمات البرمجية، وصياغة مستندات ملاحظات التصحيح. تورفالدس مسؤول عن تحديد اتجاهات التحسين، والإشراف على عملية التطوير، وإجراء قياسات الأداء على جهاز الكمبيوتر الخاص به.
تختلف الأهداف الفنية للمهمتين، إلا أنهما يجسدان نموذج تطوير مماثل: يحدد المهندسون المطلعون على النواة المشكلة، ثم يستخدمون الذكاء الاصطناعي للمساعدة في فهم التطبيقات المعقدة، وكتابة التعليمات البرمجية أو ضبطها، وأخيرًا التحقق من النتائج من خلال الاختبار.
قد يكون هذا النموذج ذا قيمة خاصة للمشروعات مفتوحة المصدر ذات النطاق الكبير ودورات الصيانة الطويلة مثل Linux. استمر كود النواة في التطور على مدى عقود ويحتوي على تاريخ تنفيذ واسع ومتطلبات توافق معقدة. حتى المشرفين ذوي الخبرة لا يمكنهم دائمًا أن يكونوا على دراية بجميع تفاصيل كل نظام فرعي.
تعتمد مراجعة التعليمات البرمجية التقليدية بشكل أساسي على المطورين لقراءة التعليمات البرمجية وتحليل المنطق واختبارات التصميم. تتمتع أدوات الذكاء الاصطناعي بفرصة مساعدة المشرفين على فرز التعليمات البرمجية غير المألوفة بشكل أسرع، وشرح العلاقة بين الوظائف، واقتراح شروط الحدود المحتملة، والمساعدة في إنشاء حالات اختبار. وهي لا تحل محل المراجعة المهنية، ولكن من المتوقع أن تقلل من تكلفة الوقت لفهم التعليمات البرمجية المعقدة.
وفي الوقت نفسه، هناك قيود أيضًا على التعليمات البرمجية التي ينشئها الذكاء الاصطناعي. يمكن لنماذج اللغة الكبيرة أن تسيء فهم تدفقات التحكم المعقدة، أو تتجاهل شروط الحدود النادرة، أو تقترح تعديلات تبدو معقولة ولكنها لا تضمن في الواقع صحتها. بالنسبة لنواة نظام التشغيل، تعد هذه المشكلات ذات أهمية خاصة لأن أخطاء التعليمات البرمجية قد تؤثر على استقرار النظام وسلامة الذاكرة وحتى التشغيل الموثوق للنظام بأكمله.
لذلك، فإن مشاركة الذكاء الاصطناعي في تطوير النواة لا تعني إمكانية تخفيف متطلبات المراجعة. وبدلاً من ذلك، تظل إعادة هيكلة التعليمات البرمجية والاختبار الآلي ومراجعة التصحيح والتحقق الفعلي أمرًا أساسيًا لضمان جودة التعديلات. تمكن مشروع المصفوفة الترابطية من اكتشاف المشكلات طويلة الأمد، وهو ما يوضح فقط أن أدوات الذكاء الاصطناعي تحتاج إلى الدمج مع عمليات التحقق الهندسية الصارمة لتكون فعالة.
لطالما كان لدى تورفالدس موقف عملي تجاه أدوات برمجة الذكاء الاصطناعي. لقد أدرك قيمة الذكاء الاصطناعي للمساعدة في عملية التطوير، لكنه لم يدعو إلى ضرورة قبول المطورين للتعليمات البرمجية التي يتم إنشاؤها بواسطة الآلة دون مراجعة. صرح هذه المرة علنًا أنه يستخدم LLM لتحليل الكود، مما أظهر أيضًا أن الذكاء الاصطناعي أصبح خيارًا مساعدًا في صندوق أدوات تطوير kernel.
على نطاق أوسع، يسلط الحادث الضوء أيضًا على صعوبة طويلة الأمد في صيانة مشاريع البرمجيات الكبيرة: لا تحتاج التعليمات البرمجية إلى التشغيل بشكل صحيح فحسب، بل يجب أيضًا أن تكون مفهومة للمطورين المستقبليين. بالنسبة للبرامج الأساسية التي تمت صيانتها لأكثر من عشر سنوات أو حتى عقود، تعد سهولة القراءة في حد ذاتها عاملاً مهمًا يؤثر على الموثوقية.
يعمل هذا التعديل على تحسين بنية التعليمات البرمجية عن طريق تقسيم الوظائف المعقدة، ويستخدم الاختبار لاكتشاف المشكلات التي لم يتم تجاهلها سابقًا، مما يوضح الارتباط الوثيق بين إمكانية قراءة التعليمات البرمجية واستكشاف العيوب وإصلاحها. عندما يكون منطق البرنامج أكثر وضوحًا، يكون من الأسهل على المطورين تحديد مسارات الأخطاء المحتملة وإنشاء اختبارات تغطي السلوكيات ذات الصلة.
إذا دخلت هذه المجموعة من التصحيحات في نهاية المطاف إلى خط Linux الرئيسي، فلن تؤدي أهميتها إلى حل المشكلات الأربعة المحددة فحسب، بل ستوفر أيضًا أساسًا أكثر وضوحًا للكود للصيانة اللاحقة.
مع استمرار تطور أدوات برمجة الذكاء الاصطناعي، قد يكون هناك المزيد من الحالات المماثلة في المشاريع الكبيرة مفتوحة المصدر في المستقبل. ومع ذلك، بالنسبة للبرامج الأساسية الرئيسية مثل Linux kernel، فإن ما يحدد حقًا ما إذا كان التطوير بمساعدة الذكاء الاصطناعي يمكن أن يحظى باعتراف طويل الأمد هو ما إذا كان التصحيح يمكنه اجتياز مراجعة صارمة، وما إذا كان الاختبار يمكنه إعادة إنتاج المشكلة، وما إذا كان الكود النهائي موثوقًا بدرجة كافية.
هذه المرة، لم يحل الذكاء الاصطناعي محل مؤسس Linux في اتخاذ القرار النهائي، بل ساعده على فهم الكود الذي كان من الصعب مراجعته في الأصل واكتشاف المزيد من العيوب التي كانت مخفية لسنوات عديدة. بالنسبة لهندسة البرمجيات الناضجة، قد يكون هذا أحد اتجاهات التطبيق الأكثر عملية للذكاء الاصطناعي.
التعليقات