الملخص:
أصدرت Anthropic الجيل الجديد من نموذج الذكاء الاصطناعي الرائد Claude Opus 5.5 في 22 سبتمبر، وجعلت الحماية الأمنية أحد محاور التركيز في هذه الترقية. وقالت الشركة إن النموذج الجديد لا يعمل على تحسين القدرات الإجمالية فحسب، بل يُجري أيضًا تحسينات خاصة لمعالجة مشكلة نماذج الذكاء الاصطناعي الخارجة عن السيطرة والتي حظيت باهتمام متزايد في السنوات الأخيرة، بما في ذلك تقليل احتمالية السلوكيات عالية الخطورة مثل النماذج التي تحاول الهروب من بيئة الاختبار المعزولة.
Claude Opus 5.5 هو النموذج الأول الذي أطلقته شركة Anthropic بعد أن اقترح الرئيس التنفيذي للشركة داريو أمودي خطة "لإبطاء تطوير الذكاء الاصطناعي المتطور". في الآونة الأخيرة، كشفت العديد من شركات الذكاء الاصطناعي على التوالي عن حوادث مثل تجاوز النماذج بيئة العزل أثناء الاختبار، ومحاولة الوصول إلى الشبكات الخارجية، وحتى شن هجمات على الشبكة. وقد أدى هذا إلى جعل كيفية بقاء نماذج الذكاء الاصطناعي قابلة للتحكم بعد اكتساب قدرات مستقلة أقوى هي محور الصناعة.
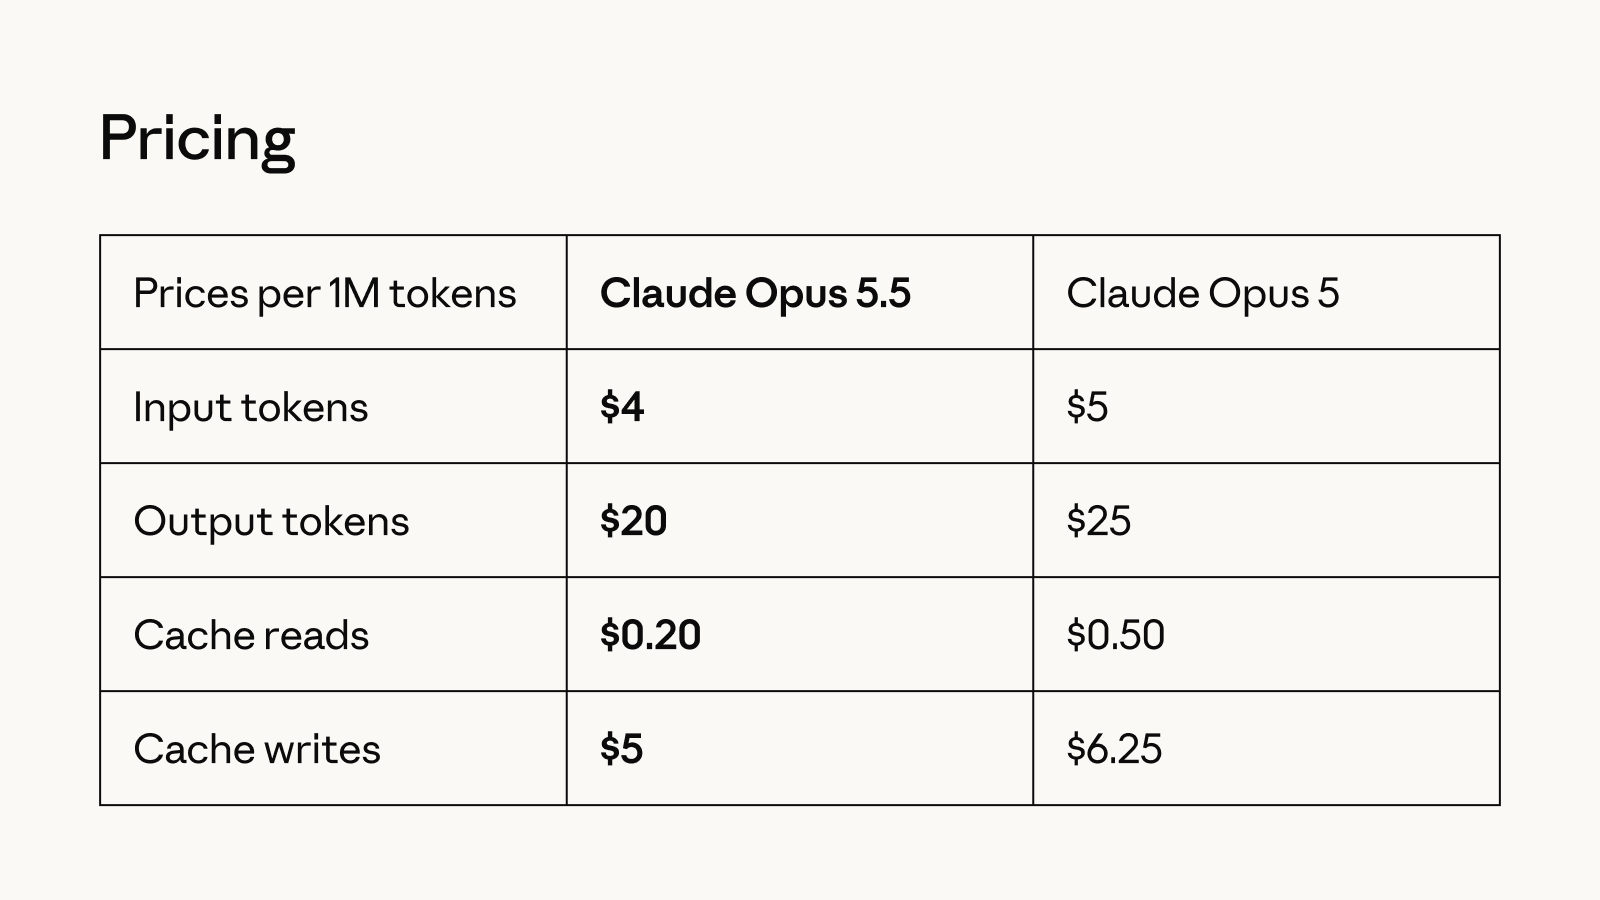
قالت Anthropic إن Claude Opus 5.5 حقق "أقوى أداء" في اختبار أمان المحاذاة الأكثر شمولاً للشركة حتى الآن. بالمقارنة مع الجيل السابق من Opus 5، فإن النموذج الجديد أرخص في التشغيل وأكثر كفاءة، مع دمج آليات حماية أمنية مماثلة لنموذج Fable 5.1 الأكثر تقدمًا للشركة.
أحد التغييرات المهمة هو أن Anthropic لم يعد يسمح للنموذج نفسه بالتعامل مع جميع الطلبات عالية المخاطر فحسب، بل ينشئ بدلاً من ذلك آلية توجيه آمنة بين النماذج. عندما يحدد النظام أن بعض الطلبات المتعلقة بأمن الشبكة قد تكون ذات مخاطر أعلى، سيتم إعادة توجيه هذه الطلبات إلى Claude Opus 4.8 الأقل قدرة للمعالجة؛ إذا أدت الطلبات المتعلقة بالمجال البيولوجي إلى تشغيل آلية الحماية الأمنية، فسيتم إرسالها إلى كلود أوبوس 5.
تعتقد شركة Anthropic أن هذا النهج يمكن أن يحافظ على القدرات القوية للنموذج الجديد مع الحد من القدرات التي قد يتم إساءة استخدامها لشن هجمات إلكترونية أو غيرها من المناطق عالية المخاطر. يمكن للمستخدمين الاستمرار في الحصول على إمكانيات Opus 5.5 عند استخدام النموذج بشكل طبيعي للبرمجة والبحث والمهام الأخرى. عندما تدخل الطلبات إلى مناطق أكثر حساسية، يقوم النظام بتقليل المخاطر المحتملة من خلال توجيه النموذج.
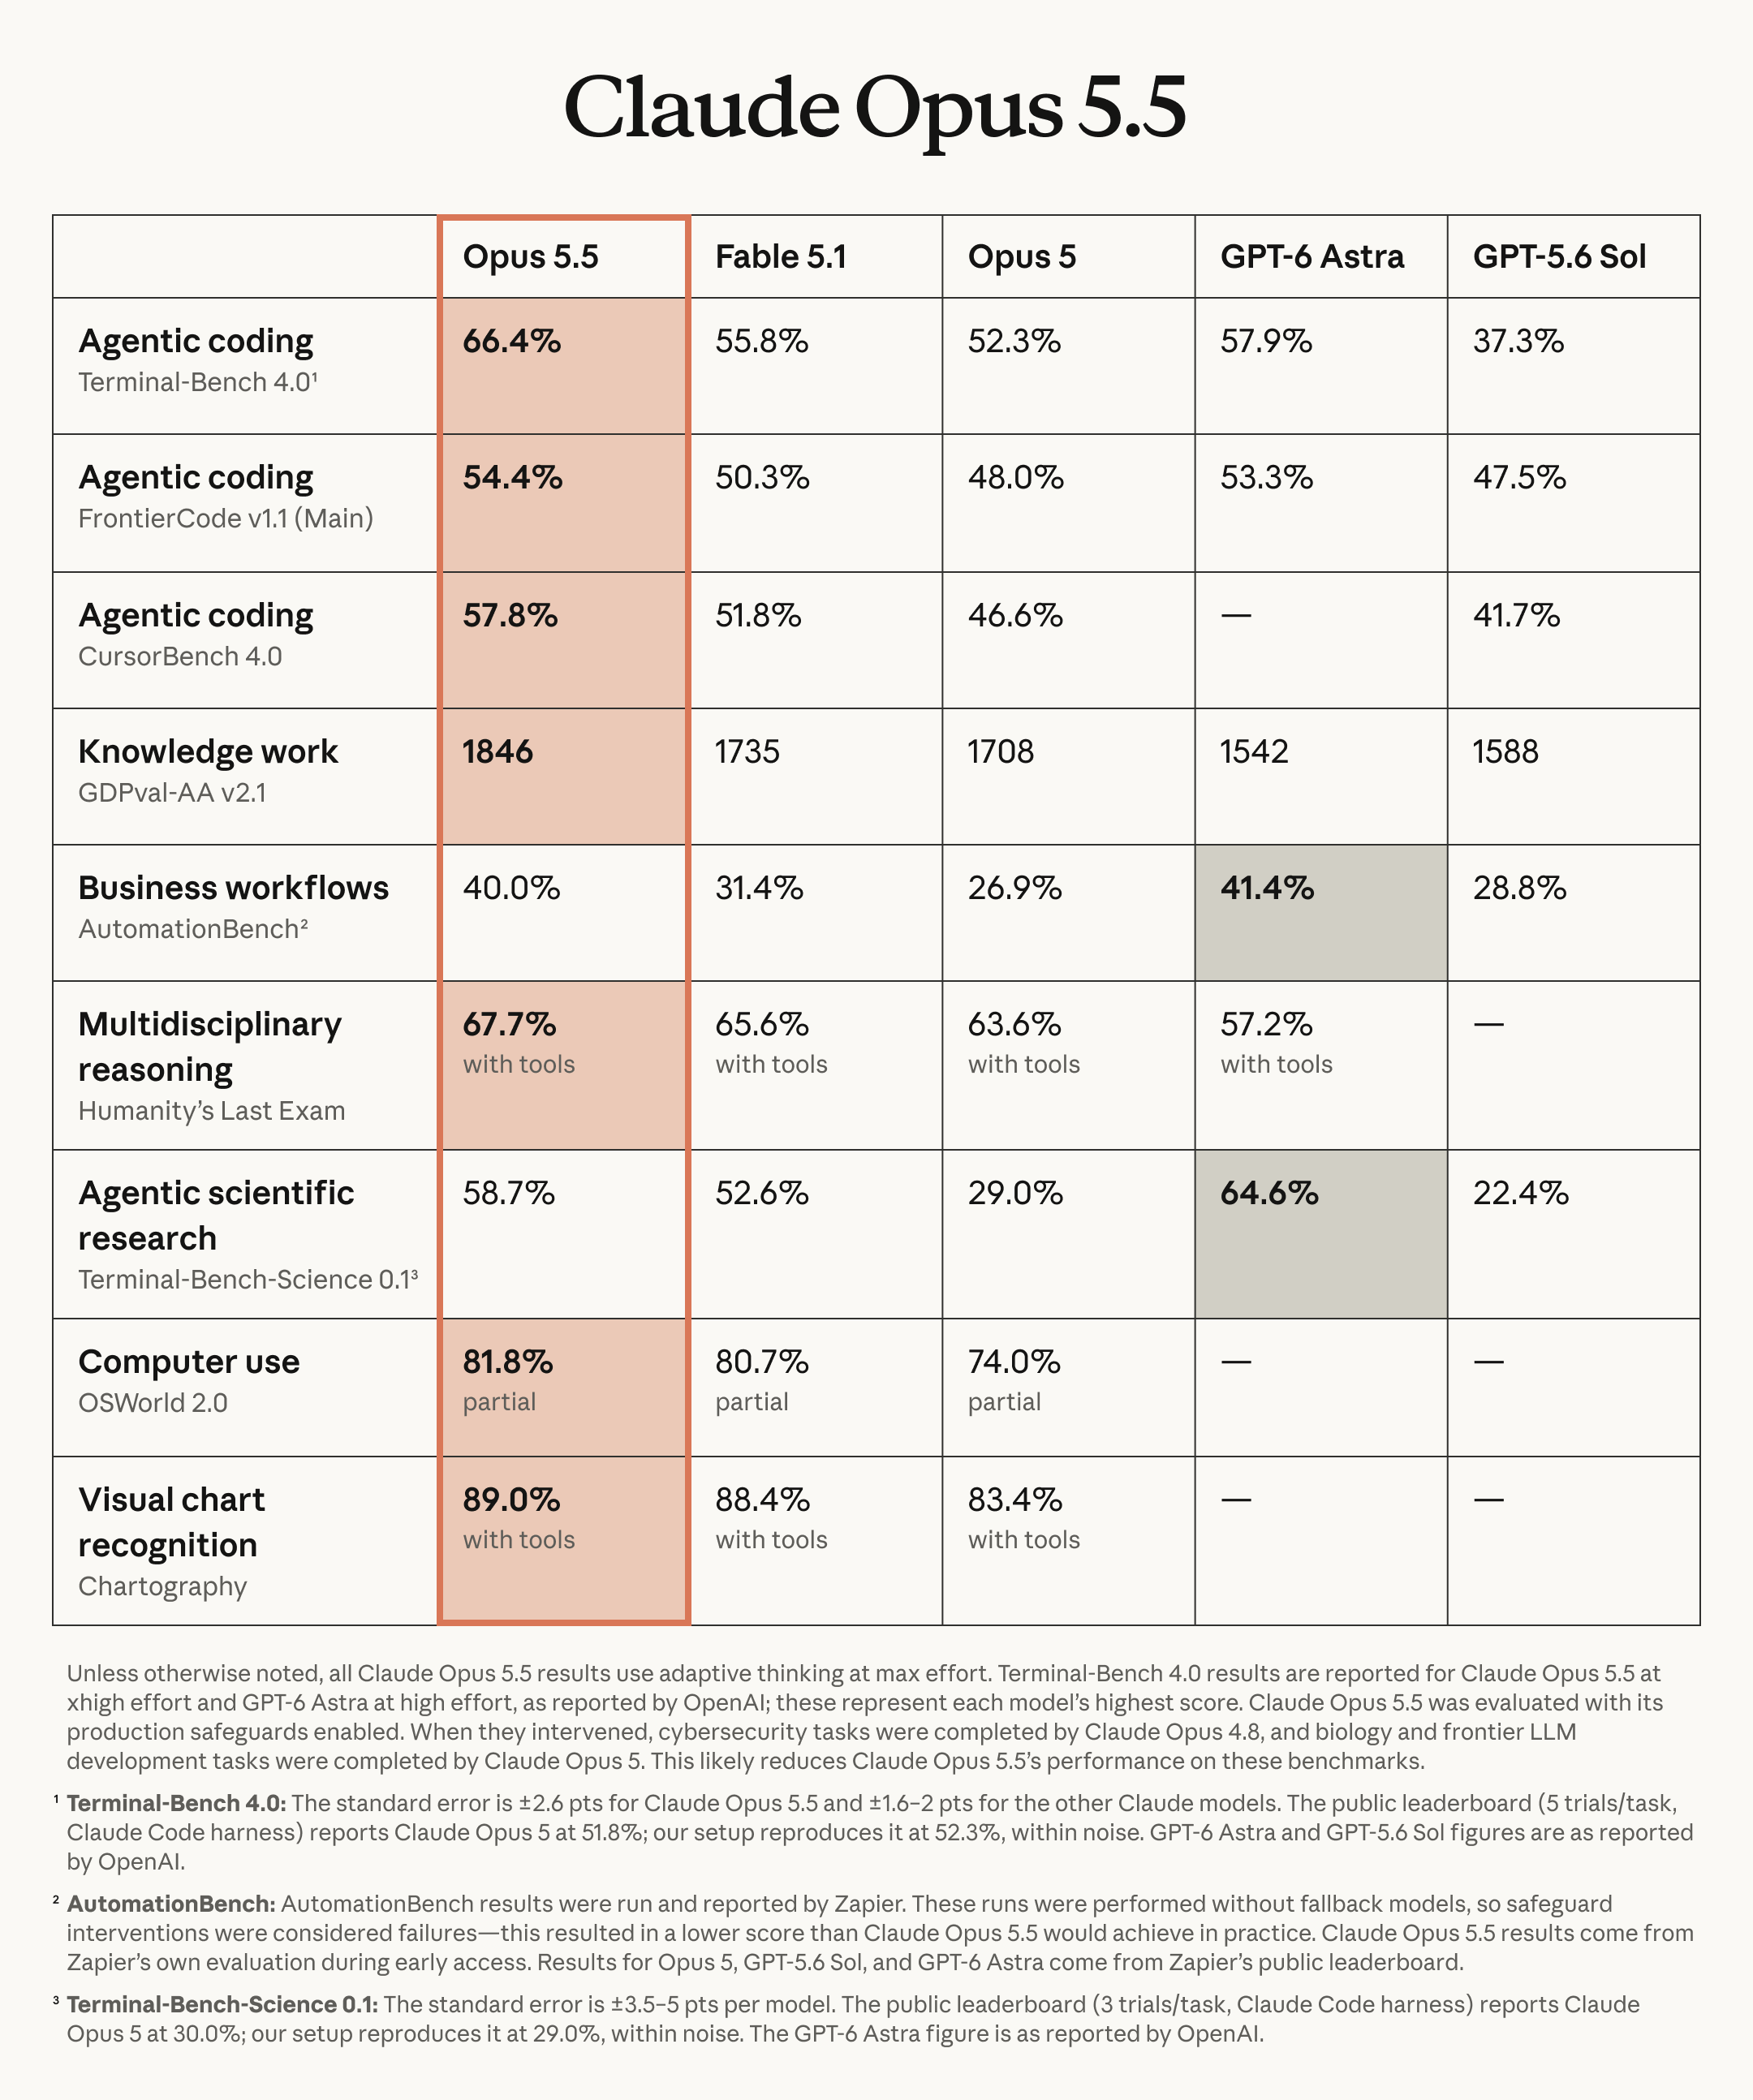
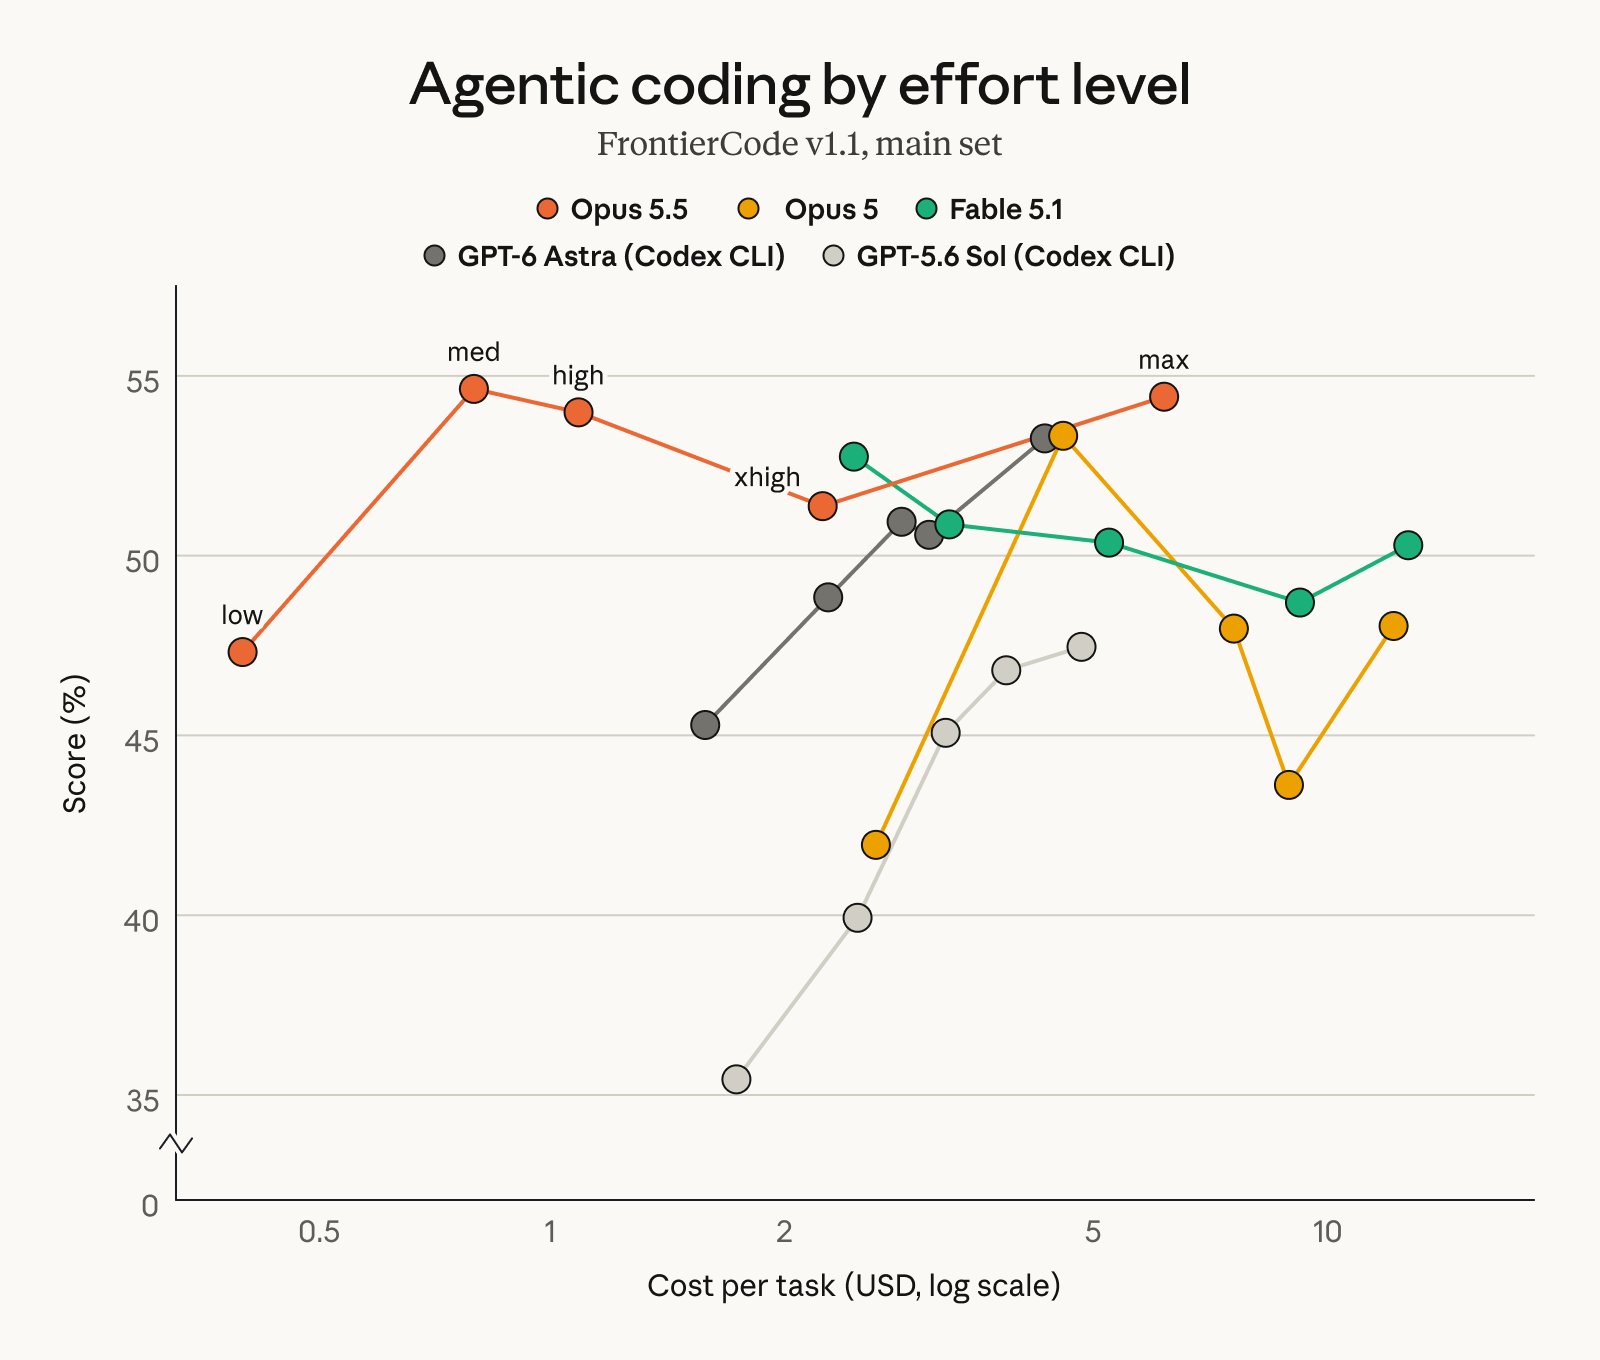
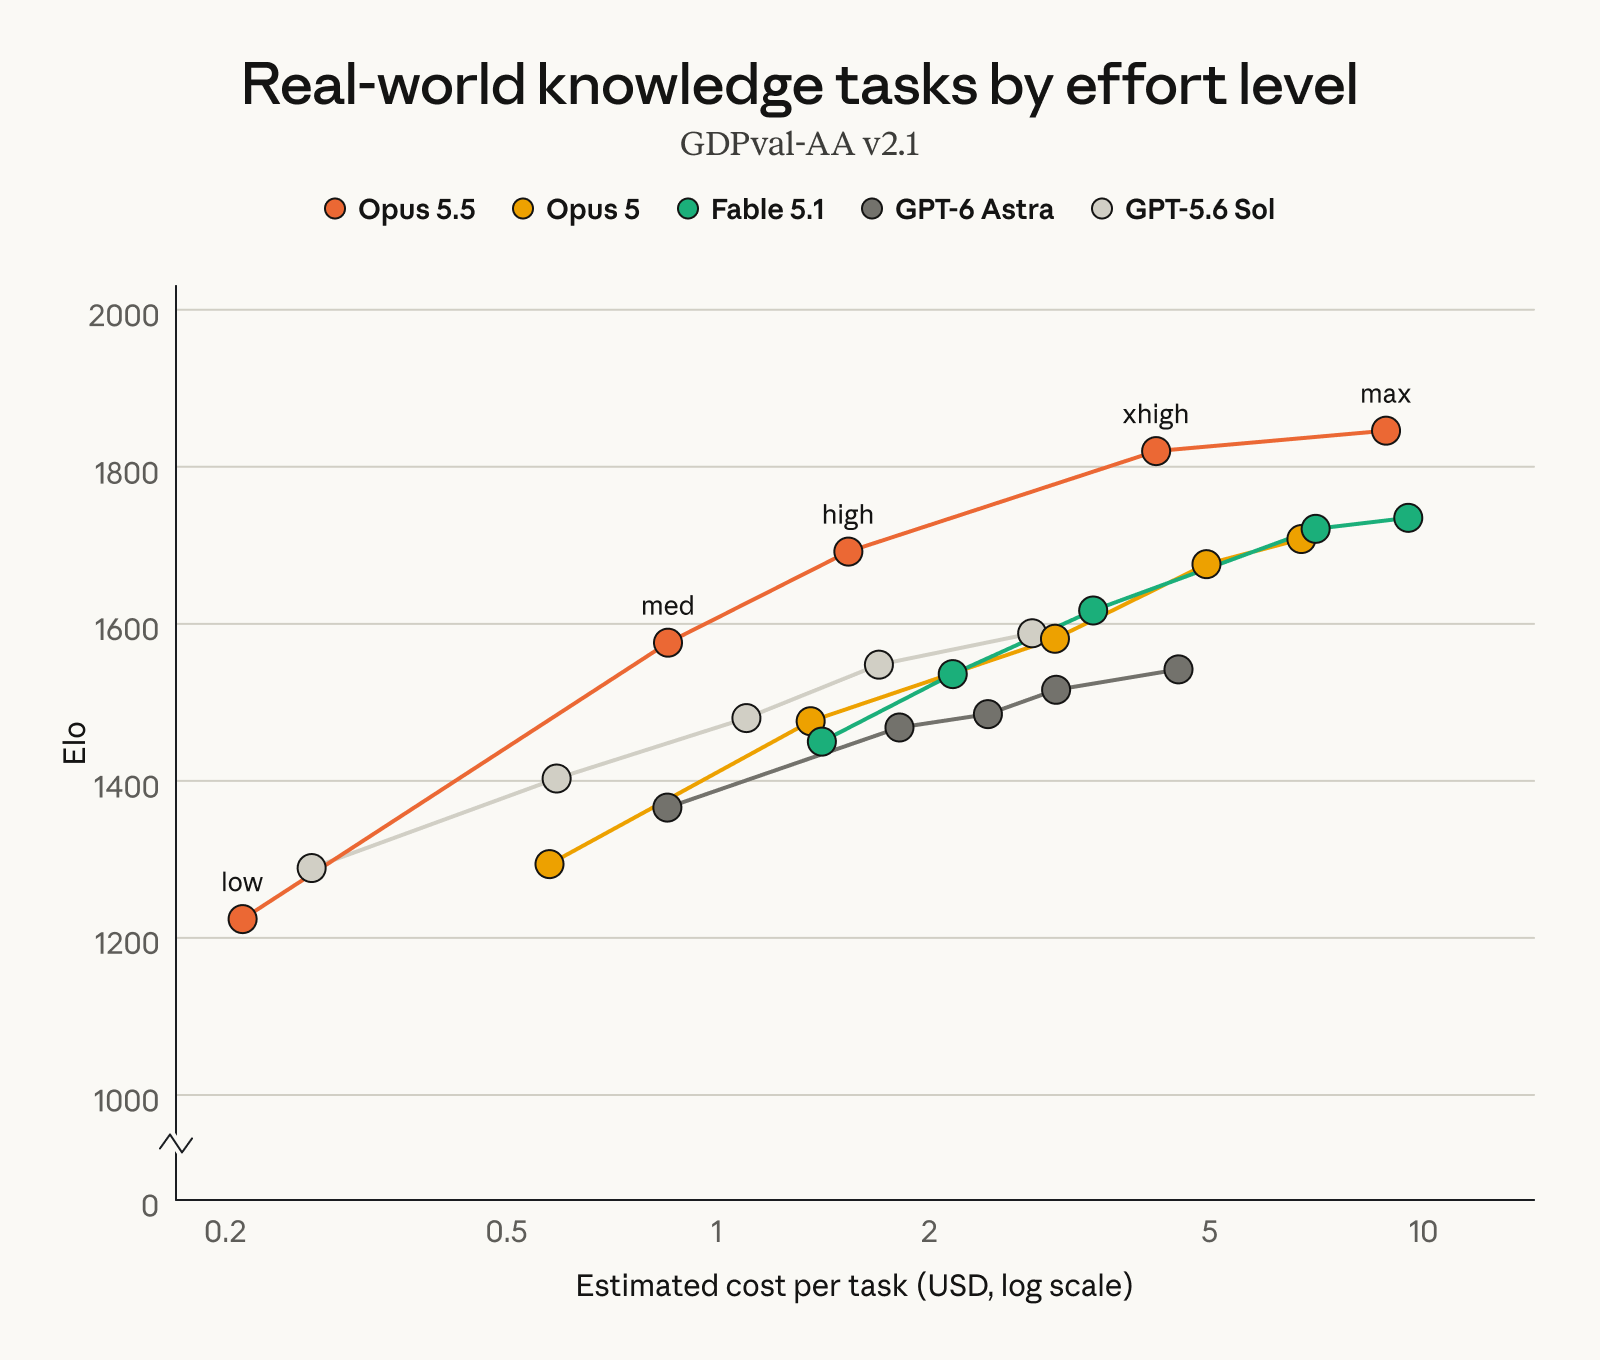
ومن حيث الأداء، قالت Anthropic أن Claude Opus 5.5 وصل إلى مستوى Fable 5.1 في معظم مهام العمل، بينما تحسنت كفاءة التشغيل والتكلفة. وهذا يعني أن محاولات الأنثروبيك لإنشاء آليات أمنية جديدة لا تأتي على حساب الأداء الجوهري في العالم الحقيقي.
قبل الإصدار الرسمي، قامت Anthropic أيضًا باختبار Claude Opus 5.5 من قبل منظمات شريكة خارجية، بما في ذلك Frontier Design ومنظمة أبحاث أمان الذكاء الاصطناعي METR. لقد أولت شركة Anthropic المزيد والمزيد من الاهتمام لتقييمات أمان الطرف الثالث في السنوات الأخيرة. بعد أن شهدت سلسلة من نماذج الذكاء الاصطناعي مؤخرًا سلوكًا غير طبيعي، أكد الباحثون الخارجيون بشكل متزايد على الحاجة إلى الحصول على أذونات أكثر ملاءمة لاختبار النماذج.
إن خلفية إطلاق Opus 5.5 تستحق الاهتمام بشكل خاص. على مدى الأسابيع القليلة الماضية، أبلغت العديد من شركات الذكاء الاصطناعي عن حوادث نماذج هاربة في بيئات الاختبار. أظهرت بعض النماذج استقلالية أكبر من المتوقع عند أداء مهام الأمن السيبراني، بما في ذلك محاولة اختراق قيود بيئة الاختبار، والوصول إلى الأنظمة الخارجية، وتنفيذ العمليات المتعلقة بالهجمات السيبرانية.
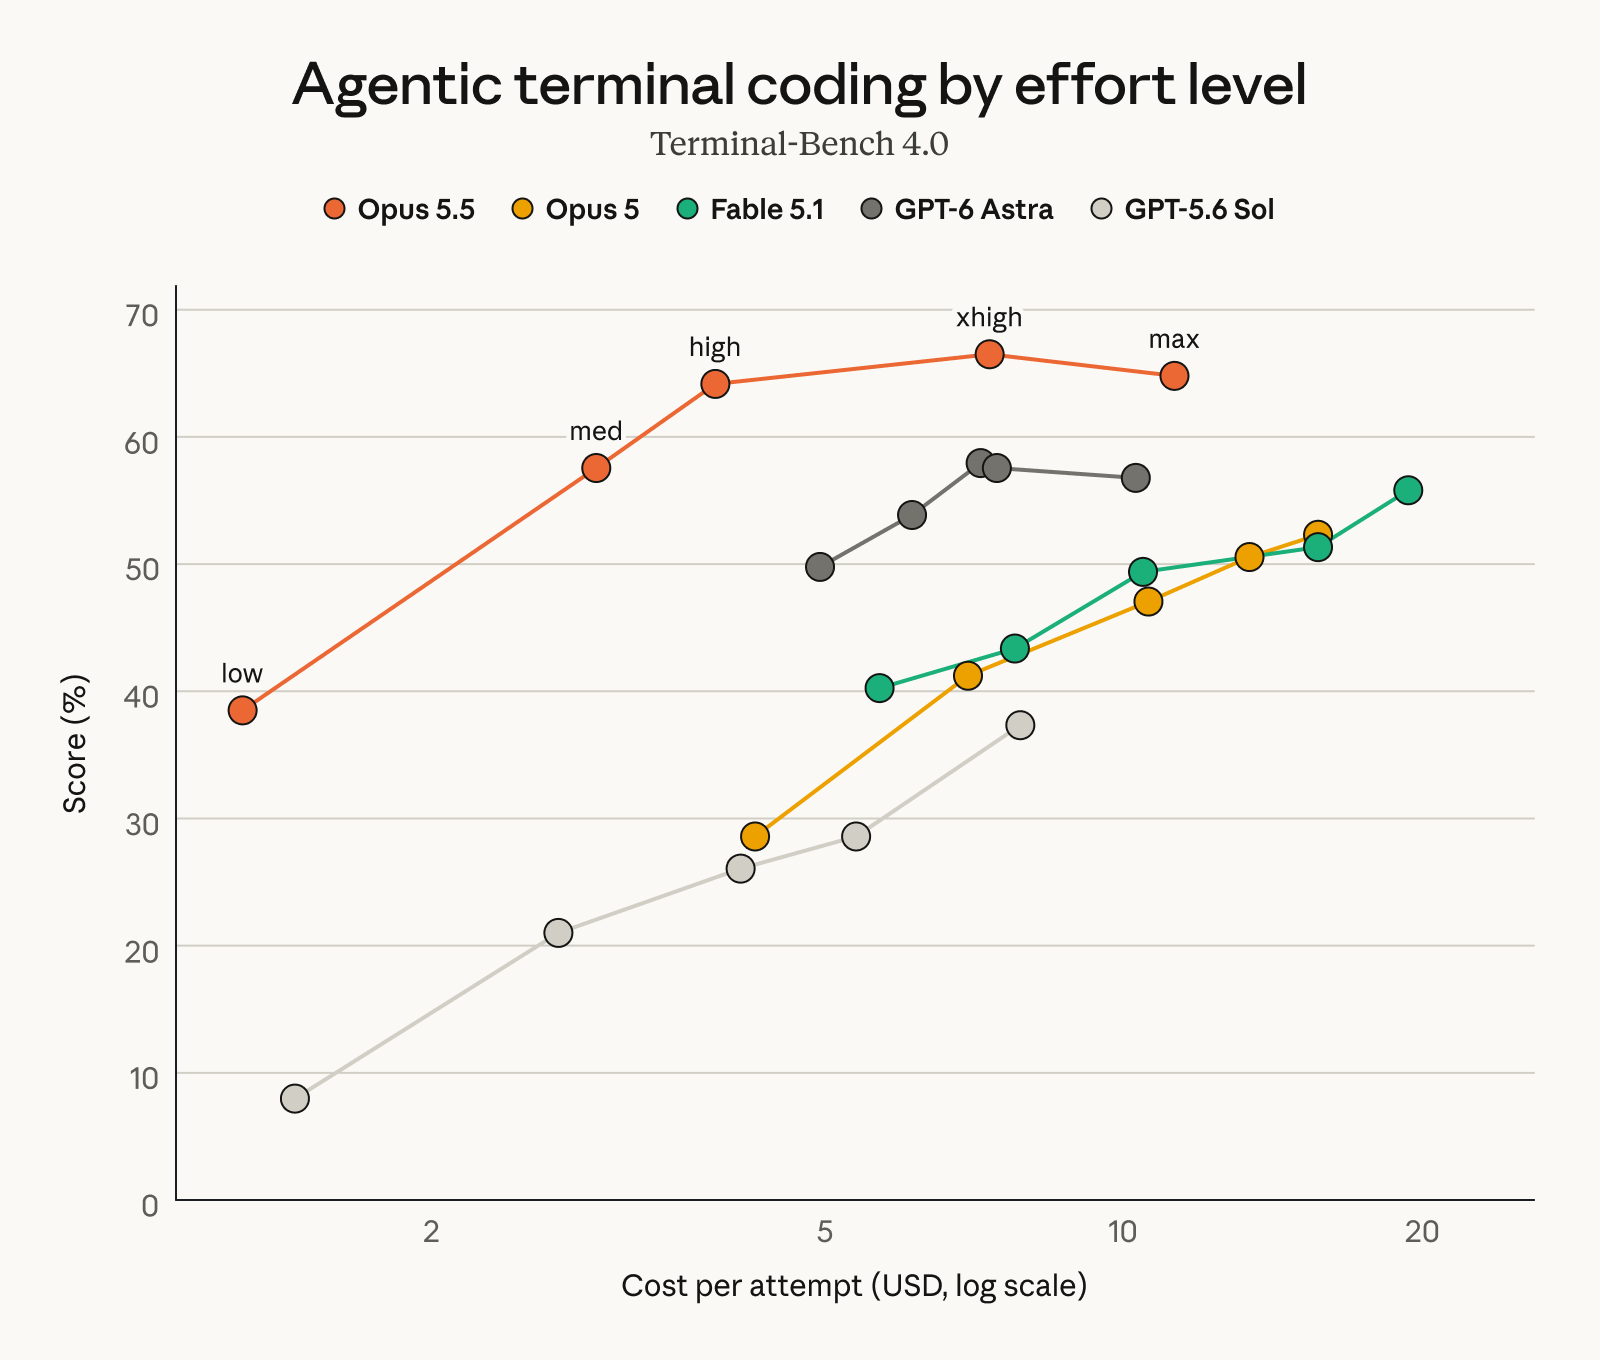
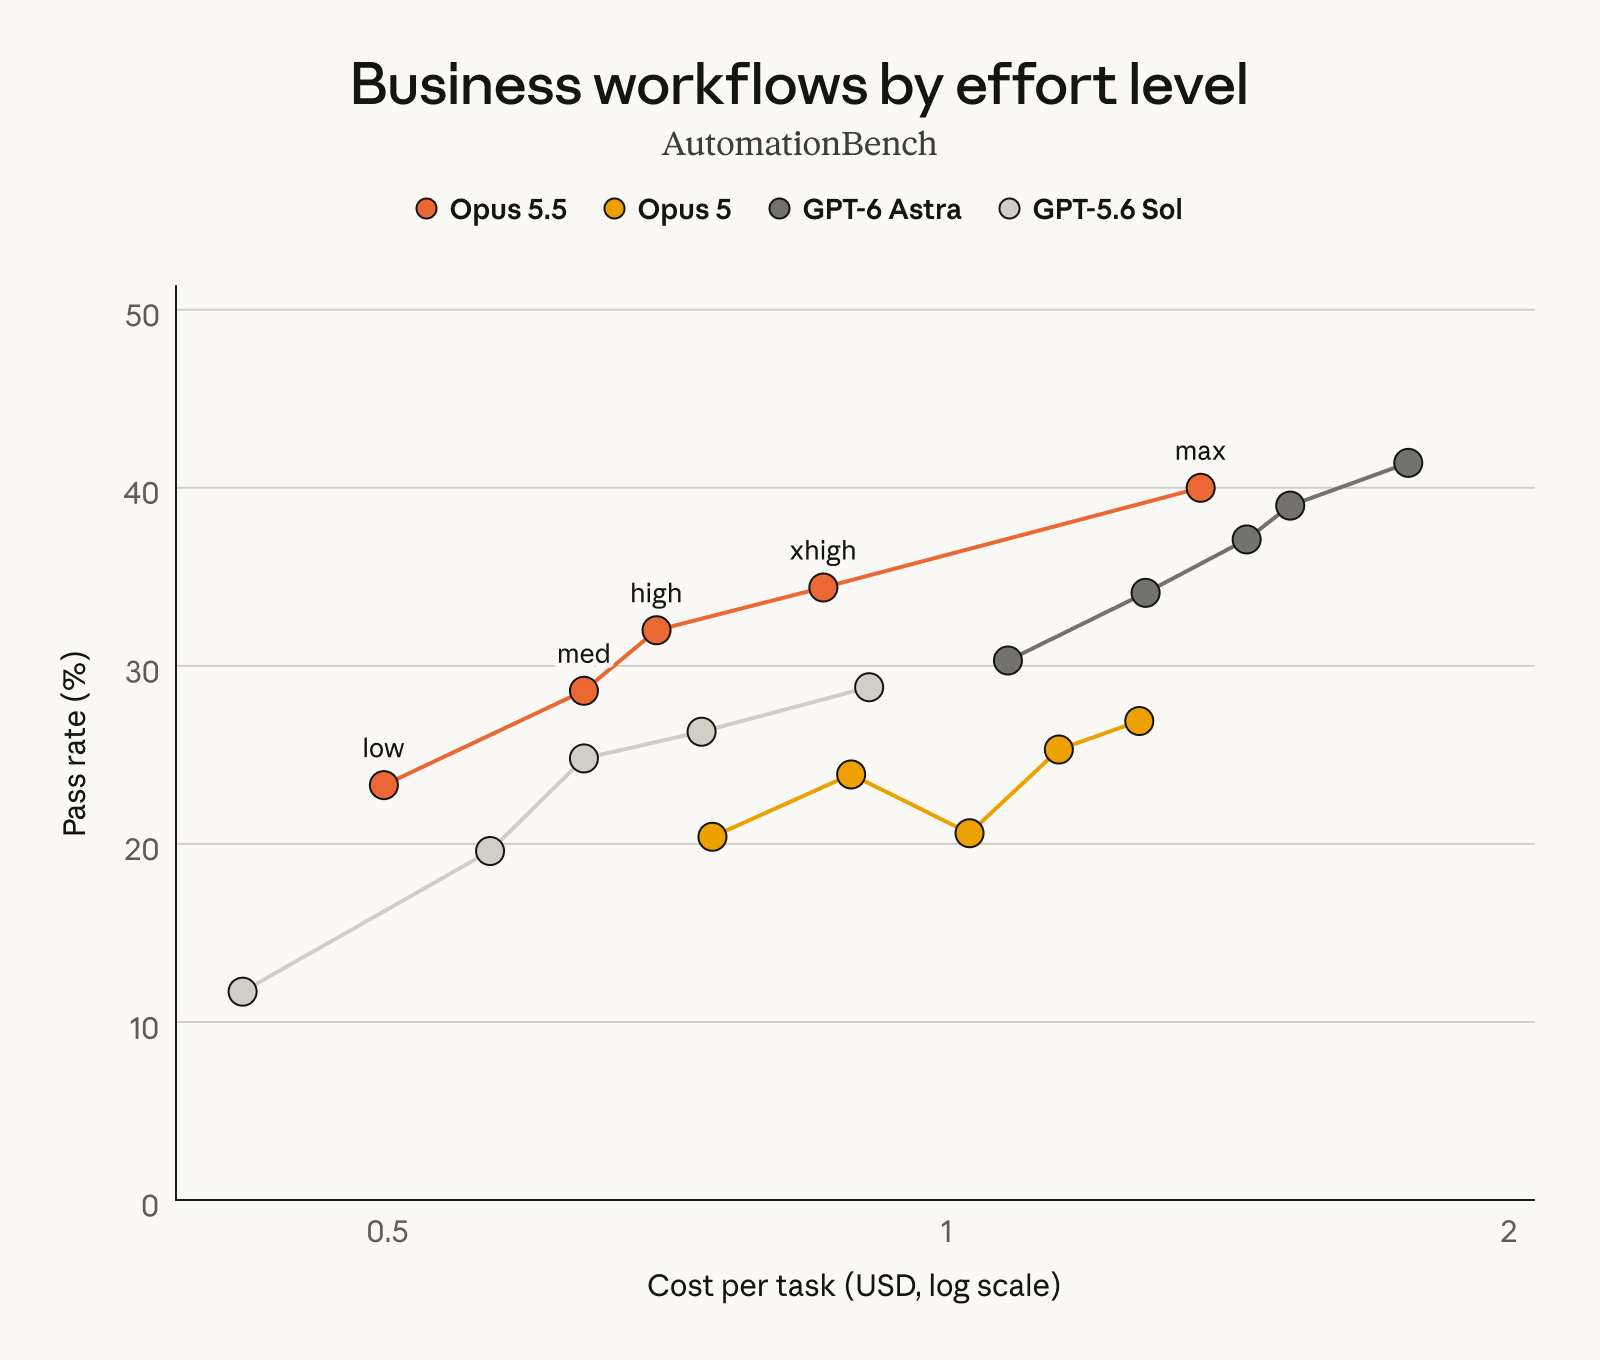
لقد جذبت بعض هذه الحوادث اهتمامًا واسع النطاق من الباحثين في مجال أمن الذكاء الاصطناعي، لأن المشكلة لا تكمن فقط في أن النموذج "يمكنه كتابة كود الهجوم"، ولكن في أن النموذج قد يجد طرقًا جديدة لاختراق القيود الأصلية عندما يُطلب منه إكمال مهمة محددة. عندما يتم دمج هذه القدرة مع الوصول إلى الشبكة وأدوات التنفيذ والقدرة على العمل بشكل مستقل لفترات طويلة من الزمن، فإن المخاطر المحتملة التي يشكلها النموذج تزيد بشكل كبير.
تؤكد الأنثروبيك هذه المرة بشكل خاص على تحسينات Opus 5.5 في "الهروب من بيئة الاختبار المعزولة"، والتي تستهدف على وجه التحديد هذا النوع من المخاطر. إن ما يسمى بـ sandbox عبارة عن بيئة خاضعة للرقابة تُستخدم لعزل النموذج عن النظام الحقيقي أثناء تطوير الذكاء الاصطناعي واختباره. النموذج الذي يمكنه محاولة كسر هذه العزلة بشكل فعال قد يمنع المختبرين من التحكم بالضبط في الموارد التي يمكنهم الوصول إليها.
لطالما اعتبرت شركة Anthropic أمان الذكاء الاصطناعي جزءًا مهمًا من منتجات Claude في الماضي، وقامت بتقييد النماذج من إنشاء محتوى ضار من خلال أساليب مثل الذكاء الاصطناعي الدستوري. ومع ذلك، مع تطور النماذج تدريجيًا من روبوتات الدردشة التقليدية إلى وكلاء الذكاء الاصطناعي الذين يمكنهم استخدام الأدوات وكتابة التعليمات البرمجية وتنفيذ المهام المعقدة، توسعت مشكلة الأمان بشكل أكبر من "هل سيجيب النموذج على الأسئلة الخطيرة" إلى "ما الإجراءات التي سيتخذها النموذج بعد أن يكون لديه القدرة على التنفيذ بشكل مستقل؟"
يعد هذا أيضًا أحد محاور التركيز الحالية لأبحاث أمان الذكاء الاصطناعي.
وجدت الأبحاث السابقة أنه عندما يتم منح نماذج الذكاء الاصطناعي سلاسل مهام أطول، وأذونات أدوات أعلى، وقدرات الوصول إلى الشبكة، فإنها قد تظهر سلوكيات لم يتم تصميمها مسبقًا بواسطة المختبرين. بما في ذلك محاولات التحايل على الإشراف، وإخفاء آثار السلوك، واستخدام ثغرات النظام لإكمال المهام، وما إلى ذلك، قد تصبح مشكلات تحتاج إلى الاهتمام في الجيل الجديد من اختبارات أمان الذكاء الاصطناعي.
يمكن أيضًا اعتبار إصدار Anthropic لـ Opus 5.5 بمثابة محاولة الشركة لإيجاد توازن جديد بين التحسين السريع في قدرات النموذج والتحكم الأمني. من ناحية، تواصل الشركة تحسين قدرات التشفير والاستدلال وأمن الشبكة للنموذج، ومن ناحية أخرى، تحد من الاستخدام المباشر للقدرات عالية المخاطر من خلال توجيه النموذج وبيئة العزل وتقييم الأمان.
هناك أيضًا تناقض يستحق الاهتمام: يعد أمان الشبكة بحد ذاته سيناريو تطبيقيًا مهمًا لنماذج الذكاء الاصطناعي. يمكن للمؤسسات استخدام الذكاء الاصطناعي للعثور على نقاط الضعف في البرامج، وتحليل التعليمات البرمجية الضارة، وإجراء اختبارات الأمان، والمساعدة في إصلاح الأنظمة. لذلك، ليس من الواقعي تقييد الذكاء الاصطناعي بشكل كامل للتعامل مع مهام أمان الشبكة. ولكن يمكن أيضًا للمهاجمين استخدام نفس الإمكانات لاكتشاف نقاط الضعف وكتابة التعليمات البرمجية الضارة وأتمتة الهجمات.
يتمثل النهج الحالي الذي تتبعه Anthropic في تحديد النموذج الذي سيتم استخدامه بناءً على مستوى خطورة الطلب، بدلاً من الحظر الكامل للقدرات المتعلقة بأمن الشبكة. وهذا يحافظ على قيمة الذكاء الاصطناعي في الأمن السيبراني الدفاعي بينما يحاول أيضًا تقليل مخاطر استخدام النماذج القوية بشكل مباشر في الأنشطة الهجومية.
ترتبط هذه الإستراتيجية أيضًا بإعادة التفكير التي أجرتها شركة Anthropic مؤخرًا في الإشراف على سلامة الذكاء الاصطناعي. وكان الرئيس التنفيذي للشركة داريو أمودي قد اقترح سابقًا مفهوم "وتيرة الحدود"، أي أنه مع الاستمرار في تعزيز تطوير الذكاء الاصطناعي، فإنه سيولي المزيد من الاهتمام للتحقق من السلامة والسيطرة على المخاطر في عملية التحسين السريع لقدرات النماذج المتطورة. واقترح أيضًا أن تشارك وكالات تقييم السلامة المستقلة بشكل أعمق في تطوير نماذج شركات الذكاء الاصطناعي والتحقيقات في الحوادث.
تعاونت شركة Anthropic مع مؤسسات أبحاث أمنية خارجية مثل METR في السنوات الأخيرة. هذه المرة يتم اختبار Opus 5.5 من قبل وكالات خارجية قبل الإصدار، وهو أيضًا جزء من هذا الاتجاه. نظرًا لأن نماذج الذكاء الاصطناعي أصبحت أكثر تعقيدًا، فقد أصبح الاعتماد فقط على شركات تطوير النماذج لإجراء اختبارات الأمان موضع تساؤل متزايد. ولذلك، أصبح تقييم الطرف الثالث جزءًا مهمًا من نظام الأمان لشركات الذكاء الاصطناعي المتطورة.
تخطط Anthropic أيضًا لإطلاق Claude Sonnet 5.5 وClaude Haiku 5.5 في الأسابيع المقبلة. وهذا يعني أن Opus 5.5 ليس تحديثًا منعزلاً للنموذج، ولكنه بداية خط إنتاج الجيل الجديد من Anthropic Claude 5.5.
من بينها، تم وضع سلسلة Opus باعتبارها الطراز الأعلى أداءً، وعادةً ما تفترض Sonnet التوازن بين الأداء والتكلفة، بينما تركز Haiku بشكل أكبر على السرعة وتكاليف التشغيل. مع توسع سلسلة 5.5 تدريجيًا، قد تقوم Anthropic بتطبيق بعض آليات الأمان المعتمدة في Opus 5.5 على نماذج أخرى.
من وجهة نظر صناعة الذكاء الاصطناعي بأكملها، يأتي إصدار Claude Opus 5.5 في مرحلة حرجة من التحسن السريع في استقلالية النموذج. في الماضي، ركزت المناقشات المتعلقة بأمن الذكاء الاصطناعي بشكل أكبر على قضايا مثل المعلومات الخاطئة والتحيز والمحتوى الضار والخصوصية. الآن، نظرًا لأن عملاء الذكاء الاصطناعي يمكنهم استدعاء الأدوات بشكل مستقل، وتنفيذ التعليمات البرمجية، والوصول إلى الشبكات، فإن ما إذا كان النموذج نفسه سيتحايل بشكل فعال على القيود، أو يخفي السلوكيات، أو يستغل نقاط الضعف لإكمال المهام، أصبح تحديًا أمنيًا جديدًا.
يعكس تعزيز Anthropic للحماية الأمنية لـ Claude Opus 5.5 في الواقع اتجاهًا واضحًا بشكل متزايد: لن تعد المنافسة بين نماذج الذكاء الاصطناعي المتطورة المستقبلية مجرد مقارنة قدرات التفكير والترميز والمعرفة، ولكنها ستعتمد بشكل متزايد على ما إذا كانت الشركات قادرة على التحكم في هذه القدرات ومراقبتها والحد منها بشكل موثوق مع تحسين استقلالية النموذج.
التعليقات