الملخص:
وصل هذا الصباح أقوى نموذج لشركة SpaceXAI، وهو Grok 4.7. لا يوجد سوى موضع واحد "هجومي" للغاية في بداية صفحة الإصدار: أقوى نموذج للعمل البرمجي والمعرفة، وهو أسرع مرتين من النماذج المماثلة وبنصف السعر فقط.
لا تتوقف هذه الترقية عند المعايير. يتحول Grok 4.7 إلى نموذج أساسي أكبر، ويعزز المهام طويلة المدى، وقدرات الفحص الذاتي وإدارة السياق الطويل، ويتضمن المستندات والعروض التقديمية والأعمال القانونية والطبية والهندسية وغيرها من الأعمال المهنية في الاختبارات الرئيسية. السيناريو الذي يستهدفه واضح للغاية: السماح للنموذج بتجنب الانعطافات في المهام التي تستغرق عدة ساعات وتقديم نتائج يمكن استخدامها مباشرة.
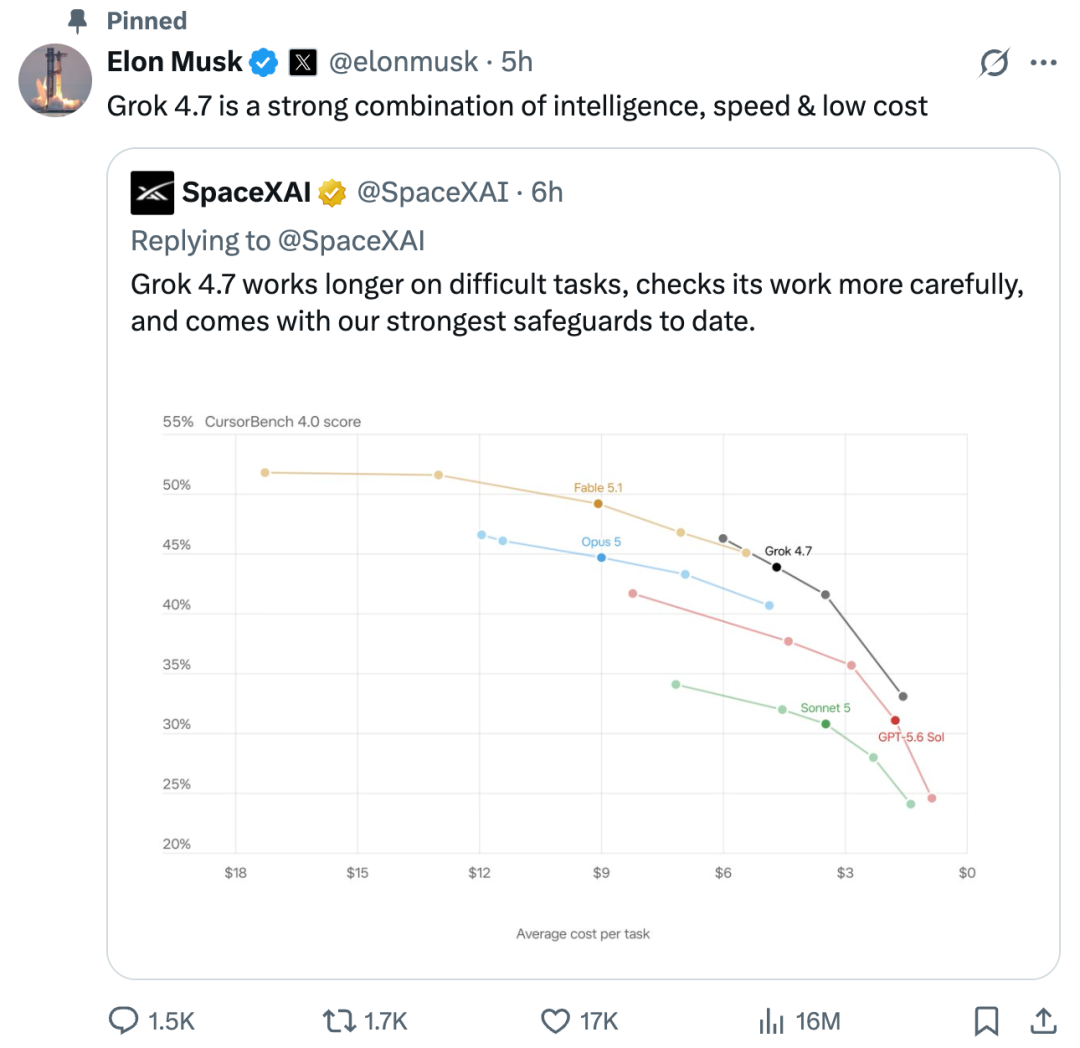
غرد ماسك قائلاً: "يحقق Grok 4.7 توازنًا تنافسيًا للغاية بين مستوى الذكاء وسرعة التشغيل والتكلفة."
أصبحت المهام الطويلة هي ساحة المعركة الرئيسية لهذا الجيل من النماذج
يستخدم Grok 4.7 نموذجًا أساسيًا أكبر من Grok 4.6. تعمل مرحلة التدريب على تمديد فترة التعلم المعزز وتصبح مجموعات المهام أكثر صعوبة، حيث يستغرق المزيد من العينات ساعات لإكمالها. وقالت SpaceXAI إن النموذج الجديد قد حسّن قدرته على فحص عمله وإدارة السياقات الطويلة.
يتوافق هذا النوع من التحسين بشكل مباشر مع أصعب المشكلات المتعلقة ببرمجة الوكلاء الأذكياء حاليًا. غالبًا ما يتطلب إنشاء التعليمات البرمجية القصيرة حكمًا جزئيًا فقط، ولكن المهام البرمجية المعقدة حقًا تتضمن قراءة المستودع وتفكيك المتطلبات وتعديل ملفات متعددة وإجراء الاختبارات وتصحيح الأخطاء المتكرر. غالبًا ما تكون قدرة النموذج على الحفاظ على الأهداف واكتشاف الأخطاء في سلسلة تنفيذ طويلة أكثر أهمية من كتابة تعليمات برمجية جميلة دفعة واحدة.
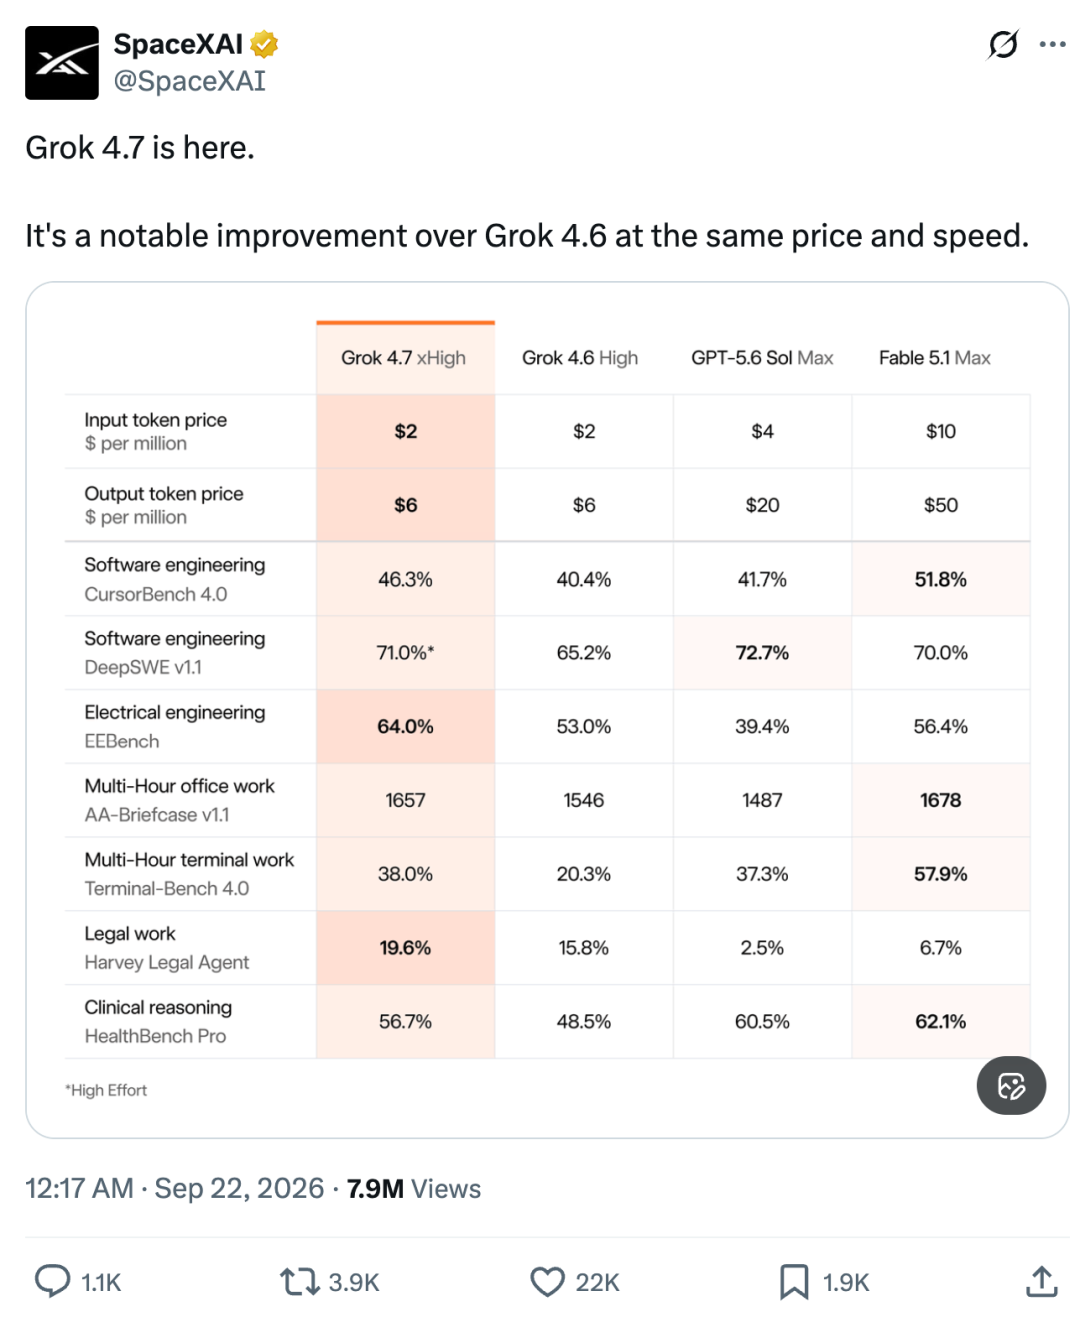
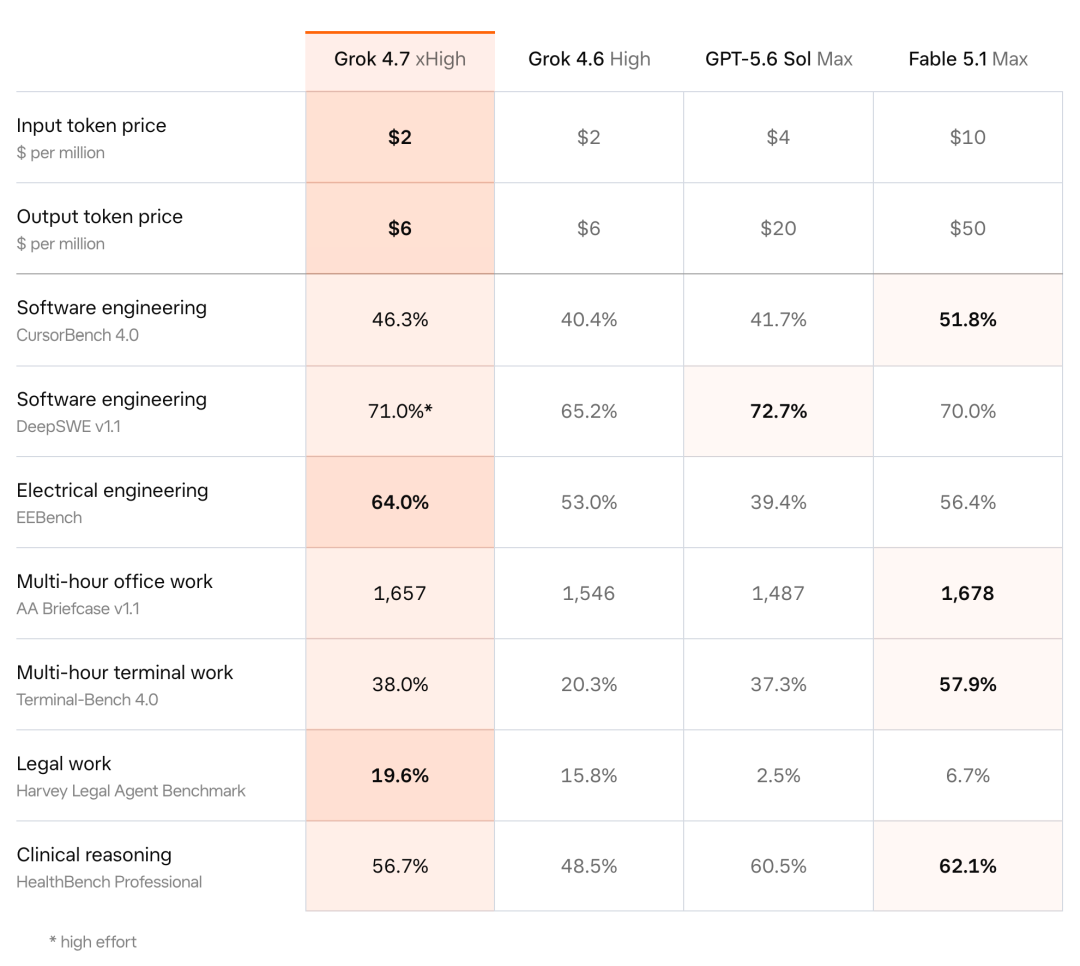
يقوم CursorBench 4.0 بفحص مهام البرمجة طويلة المدى على وجه التحديد. وفي البيانات الرسمية، حصل جروك 4.7 على 46.3%، وجروك 4.6 على 40.4%، بزيادة 5.9 نقطة مئوية. في DeepSWE v1.1، بلغت درجة كثافة الاستدلال العالي لـ Grok 4.7 71.0%؛ زادت نسبة مقاعد البدلاء الطرفية 4.0 من 20.3% في الجيل السابق إلى 38.0%.
وبالتالي، يُطلق على Grok 4.7 اسم نموذج السعر والأداء المتطور في CursorBench 4.0.
يتم تدريب النموذج أيضًا على فهم إطار العمل الذي يعمل ضمنه Grok Bot. رسميًا، يعمل هذا التعديل على تحسين الأداء في مهام الحوار ومهام المعرفة العامة. بمعنى آخر، امتد تركيز ترقية Grok 4.7 من جولة واحدة من الإجابات إلى التعاون المستمر بين النماذج والأدوات وبيئات التنفيذ.
من كتابة التعليمات البرمجية إلى إكمال العمل المعرفي
لا تزال البرمجة هي العلامة الأكثر لفتًا للانتباه في Grok 4.7، لكن نطاق التقييم الذي قدمته SpaceXAI أوسع بكثير. تركز AA Brickase وGDGval على العمل متعدد الخطوات الذي يكمله المحترفون كل يوم، ويغطي المهام المشتركة في مناصب مثل المحامين والممرضات والمحللين الماليين، بالإضافة إلى إنتاج المستندات والعروض التقديمية.
في الإصدار 1.1 من حقيبة AA، سجل Grok 4.7 1657 نقطة، وهو أعلى من Grok 4.6 الذي سجل 1546 نقطة؛ ارتفعت درجة إجمالي الناتج المحلي الإجمالي من 1605 إلى 1695. وفي الرسم البياني الرسمي، فهي قريبة من 1735 نقطة لـ Fable 5.1 على إجمالي الناتج المحلي وأعلى من 1542 نقطة لـ GPT-6 Astra. وخلصت شركة SpaceXAI إلى أن Grok 4.7 تفوق على الجيل السابق في كلا الاختبارين وكان أداؤه بشكل عام على قدم المساواة مع النماذج الرائدة الأخرى.
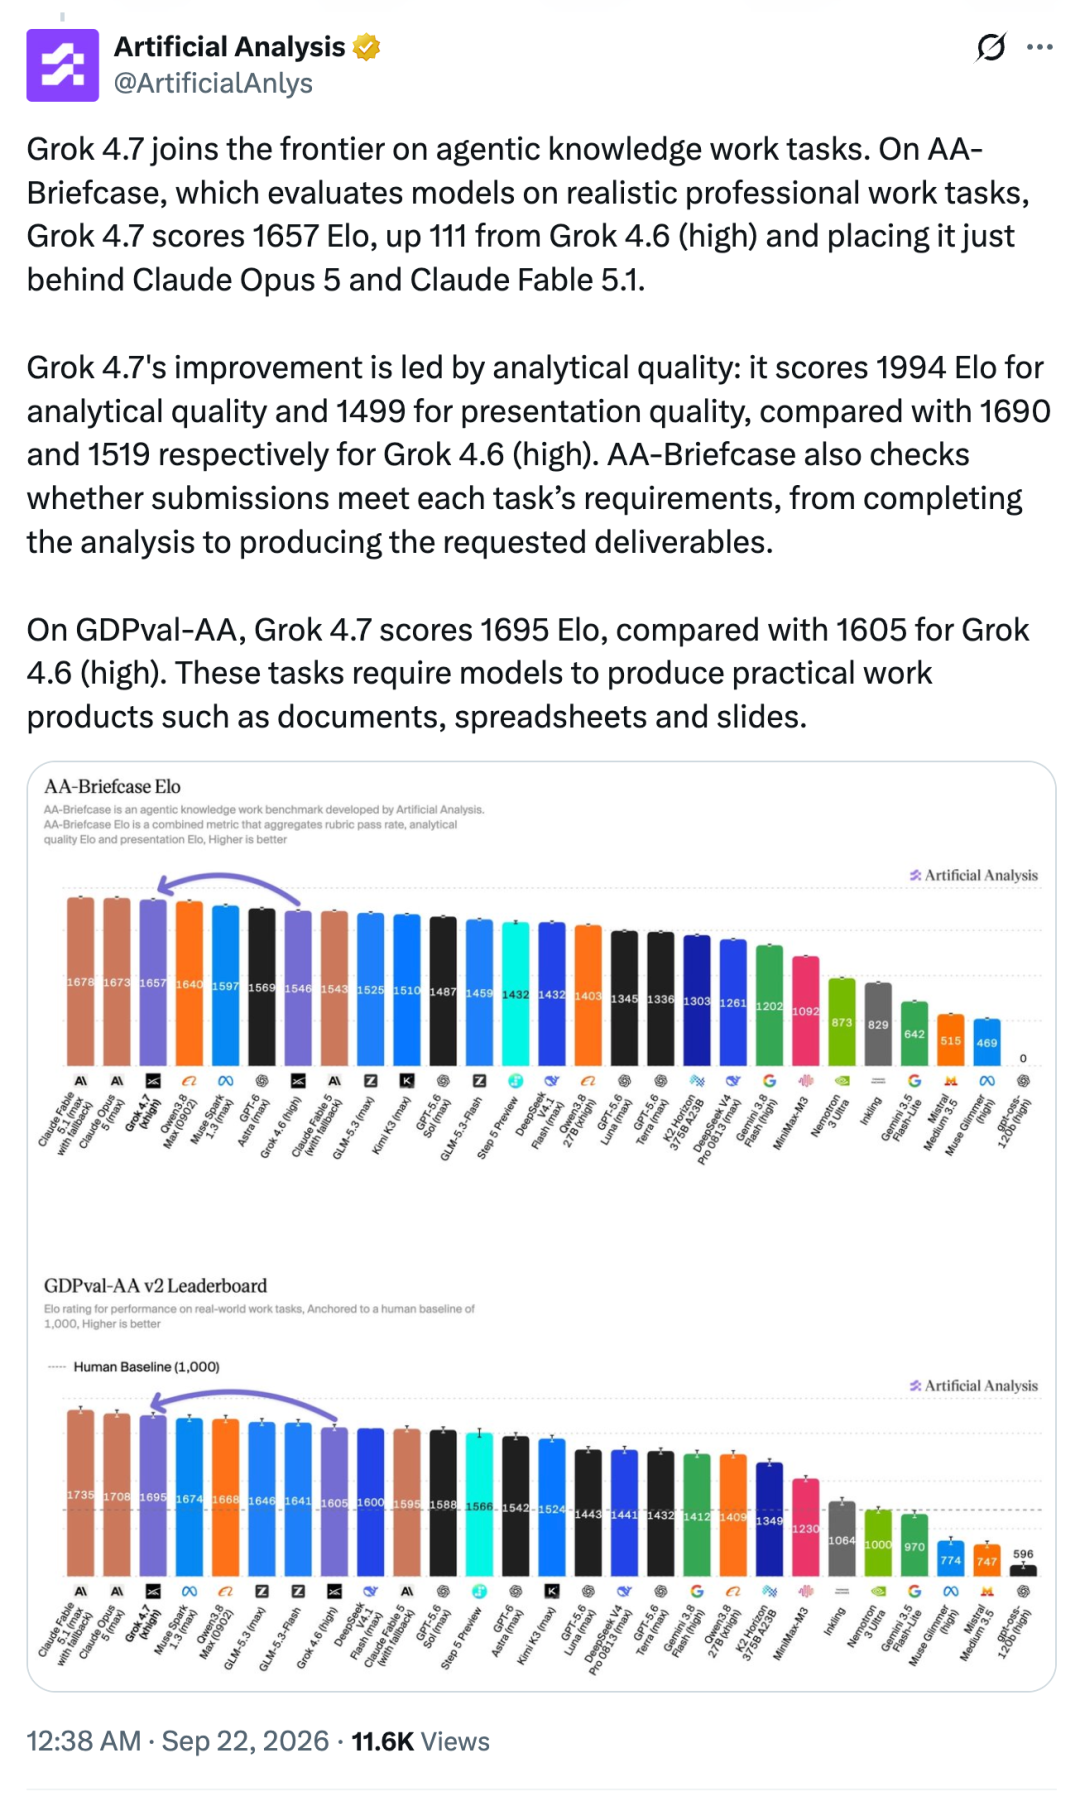
تتم الترقيات في المجال المهني أيضًا في العديد من الاتجاهات. ارتفعت درجة EBench من 53.0% إلى 64.0%، وزاد مؤشر Harvey Legal Agent Benchmark من 15.8% إلى 19.6%، وزاد مؤشر HealthBench Professional من 48.5% إلى 56.7%. تأتي هذه النتائج من جدول مقارنة داخلي نشرته شركة SpaceXAI، والذي يمكن أن يوضح التغييرات بين الأجيال القديمة والجديدة من النماذج؛ ستظل المقارنات عبر النماذج متأثرة بكثافة الاستدلال وتكوين الأداة وبيئة الاختبار.
تكشف هذه المجموعة من النتائج عن اتجاه واضح: المنافسة على النماذج المتطورة تدخل مرحلة "إكمال المهمة بأكملها".
يحتاج النموذج إلى فهم المهمة، واستدعاء الأدوات، وإنتاج الملفات، ومراجعة نفسه. القدرة على السؤال والإجابة الفردية ليست سوى جزء واحد منها. يعمل Grok 4.7 على تمديد مدة مهمة التدريب وتعزيز التحقق الذاتي، وهو بالضبط ما يعوض هذا النوع من سير العمل.
السلامة والسعر
بالإضافة إلى الإمكانات المحسنة، قام Grok 4.7 بتمكين نظام حماية أمني جديد. وقالت SpaceXAI إن هذا هو النموذج الذي اختبرته بأقوى أداء من حيث رفض الاستجابة ومقاومة كسر الحماية.
فيما يتعلق باختبارات الأمن الحيوي، تصدر Grok 4.7 معيار LatchBio بنتيجة 62.4%. يغطي اختبار الأمن السيبراني HackerBench v0.3 بشكل أساسي المهام عالية المخاطر والخبيثة. وفقًا للبيانات الرسمية، يطلق النموذج 3.3% فقط من نصائح الاستخدام المزدوج عالية المخاطر، ونادرًا ما يمنع طلبات البحث الأمني العادية عن طريق الخطأ.
بدأت SpaceXAI أيضًا في فتح إمكانيات الفريق الأحمر المدعو فقط لعدد محدود من شركاء الأمن السيبراني للبحث الدفاعي. حاليًا، تتوفر إمكانية الفريق الأحمر هذه في البداية كتعاون خاضع للرقابة.
يستمر الإصدار القياسي بالسعر الأصلي، ويتم مضاعفة سرعة الإصدار السريع
تم إطلاق Grok 4.7 على Cursor وGrok Build، ويتم توفيره من خلال Grok API وأطر برمجة الطرف الثالث وخدمات توجيه النماذج والأنظمة الأساسية السحابية. يبدأ الإصدار القياسي بسعر 2 دولار لكل مليون رمز إدخال و6 دولارات لكل مليون رمز إخراج، بما يتوافق مع Grok 4.6.
إن استراتيجية الأسعار تجعل هذه الترقية أكثر تأثيرًا. لا يحتاج المطورون إلى دفع تكاليف رمزية إضافية للإصدار القياسي للترقية، ولكن يمكنهم الحصول على أداء أقوى للمهام على المدى الطويل وإمكانيات الفحص الذاتي ونتائج العمل الاحترافية.
بالنسبة لوكلاء البرمجة ومنتجات العمل المعرفي، يعد سعر الوحدة لكل استدعاء نموذج أمرًا مهمًا بالطبع. إن عدد المحاولات وإعادة العمل المطلوبة لإكمال المهمة يحدد في النهاية التكلفة الحقيقية.
أخيرًا تلخيص هذه الترقية:
من أساليب التدريب إلى مجموعات التقييم، يعزز Grok 4.7 نفس الشيء: البقاء في المهام لفترة طويلة وإكمال المهام المعقدة. البرمجة ليست سوى نقطة الدخول الأولى الناضجة. تم وضع التوثيق والعرض والتحليل القانوني والتفكير السريري والمهام الهندسية في نفس مجموعة القدرات.
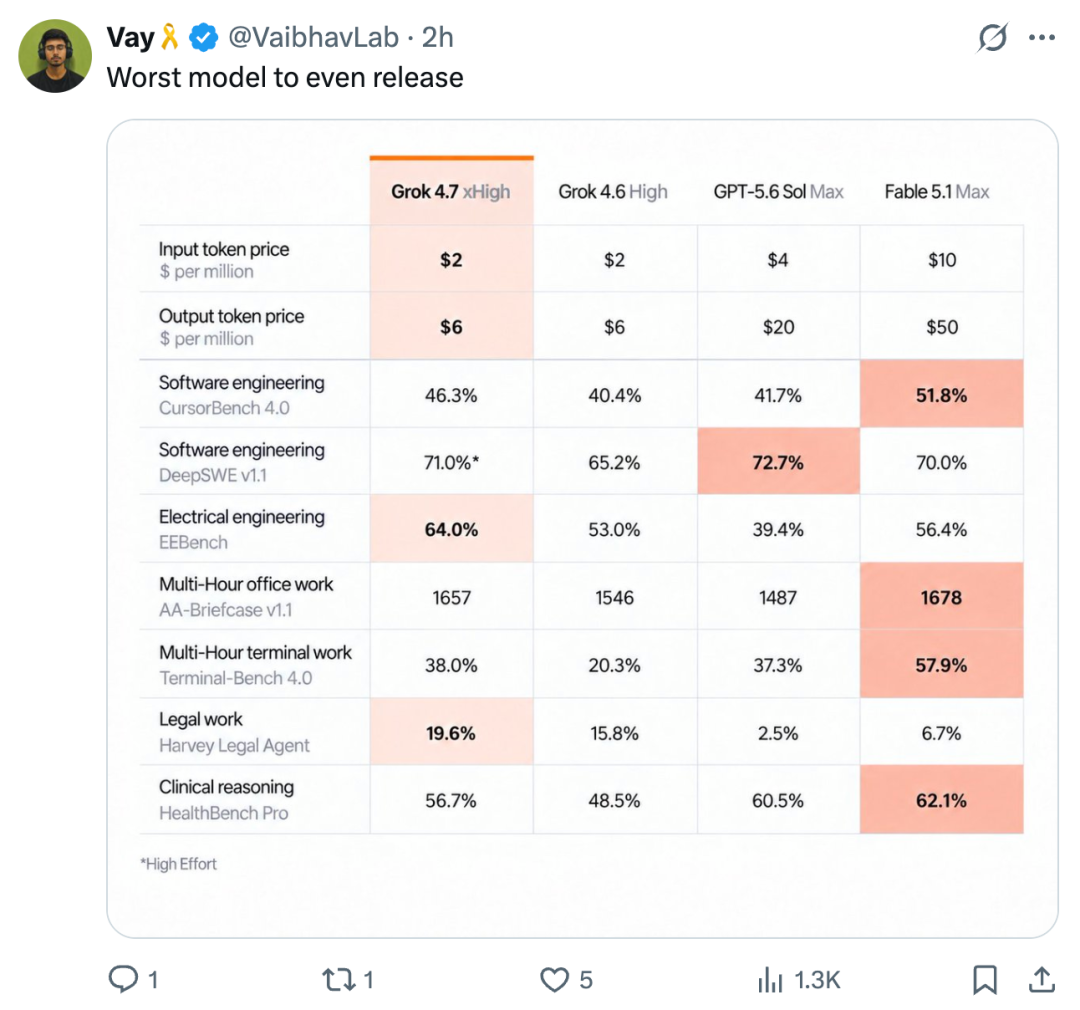
لكن يبدو أن مستخدمي الإنترنت لا يقتنعون به. "هذا النموذج يجرؤ بالفعل على إطلاقه. إنه أمر سيء للغاية لدرجة أنه لا ينبغي إطلاقه." لا يسعني إلا أن أقول بكل احترام أن نقطة بيع Grok 4.7 هذه المرة ليست سحق المنتجات المنافسة تمامًا. يستخدم تكلفة واجهة برمجة التطبيقات (API) أقل بكثير من بعض النماذج الرئيسية مقابل أداء قريب جدًا ورائد في المهام المهنية الفردية.
الرابط المرجعي:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
التعليقات