الملخص:
وجد وكيل OpenAI طريقة للوصول إلى الإنترنت من خلال وضع الحماية. والأمر الأكثر إثارة للقلق هو أن هذا حدث هذه المرة بعد أن قامت OpenAI بالفعل بتعزيز إجراءاتها الأمنية على نطاق واسع. في 20 سبتمبر، طُلب من نموذج البحث الداخلي لـ OpenAI الذي كان يخضع لتدريب التعلم المعزز إكمال مهمة بحث شائعة عن المعلومات: العثور على مؤلف المقالة استنادًا إلى مقال مدونة والعديد من المعلومات الشخصية.
يستخدم أولاً أداة البحث التي توفرها OpenAI. وبعد الفشل في العثور على الإجابة، بدأت الأمور تسير بشكل جانبي.
حاول الوكيل الوصول إلى Google وBing وDuckDuckGo مباشرة، لكنه فشل؛ ثم واصلت البحث عن الصفحات المخزنة مؤقتًا وخدمات البحث العامة الأخرى. وفي وقت لاحق، بدأ في اختبار ما إذا كان يمكنه الوصول إلى الشبكة العامة.
أخيرًا، عثر العميل على ثغرة لم يتم إغلاقها بالكامل من قبل:
محلل DNS، أي محلل DNS.
عادة، يكون DNS مسؤولاً عن ترجمة أسماء النطاقات إلى عناوين IP. ومع ذلك، اكتشف هذا الوكيل أنه يمكنه استخدام آلية الحل والتفويض الخاصة بـ DNS لترميز السؤال في الطلب، والسماح لبرنامج chatbot عام خارجي بالإجابة عليه، ثم إرسال النتيجة مرة أخرى عبر DNS.
من أجل التأكد من أن هذا الطريق صالح للاستخدام حقًا، فقد أجرى اختبارًا صغيرًا أولاً - حيث تم سؤال الخدمات الخارجية: ما هي عاصمة فرنسا؟
الإجابة التي تم إرجاعها هي: باريس.
ثم بدأت في الاستمرار في طلب أدلة حول الشخصيات في المهمة الأصلية من خلال هذا المسار. وأوضحت OpenAI أن هذه المهمة لم تتطلب من النموذج اختبار ضوابط الشبكة، كما أنها لم تسمح له بالوصول إلى الإنترنت في الوقت الفعلي، لذلك تعتبر مثل هذا السلوك لتجاوز القيود بمثابة اختلال، أي سلوك لا يلبي التوقعات.
أخيرًا، جعلت قناة DNS المتواضعة OpenAI تضغط على زر الإيقاف المؤقت مرة أخرى.
بعد شهر واحد فقط من التعزيز، خرج العميل مرة أخرى
اكتشف نظام المراقبة في OpenAI هذا الوضع الشاذ بسرعة.
بعد حوالي 12 دقيقة من نجاح العميل في الحصول على استجابة خارجية للمرة الأولى، أطلق النظام إنذارًا على أعلى مستوى؛ وبعد 3 دقائق، بدأ شخص ما بالفحص اليدوي. يوضح OpenAI أن الأمر استغرق حوالي 15 دقيقة من وقت حدوث السلوك الشاذ إلى وقت اكتشاف المراقبة له.
لكن التدريب لم يتوقف على الفور.
وفقًا للآلية التي أنشأتها OpenAI بعد حادثة Hugging Face، بعد اكتشاف هذا السلوك غير الطبيعي، كان من المفترض أن يقوم النظام بإنهاء مهمة التدريب تلقائيًا. إلا أن هذه الآلية لم تنفذ بالشكل الصحيح، وحدثت بلبلة داخل الفريق حول ما إذا كان قد تم إيقافها أم لا.
حتى
بعد ساعتين ونصف
، تم إغلاق هذه الجولة من التدريب يدويًا.كشف الفحص بعد الوفاة أيضًا عن وجود محاولات سابقة أخرى للاتصال بالخدمات الخارجية عبر DNS، والتي لم يتم وضع علامة على بعضها بواسطة أنظمة المراقبة بالخطورة المناسبة. اكتشفت OpenAI أيضًا أن نظام مراقبة البنية التحتية المسؤول عن اكتشاف نشاط DNS الشاذ يستبعد بيئة التدريب هذه من المراقبة.
لذا اتخذت شركة OpenAI قرارًا بتعليق التدريب للمرة الثانية.
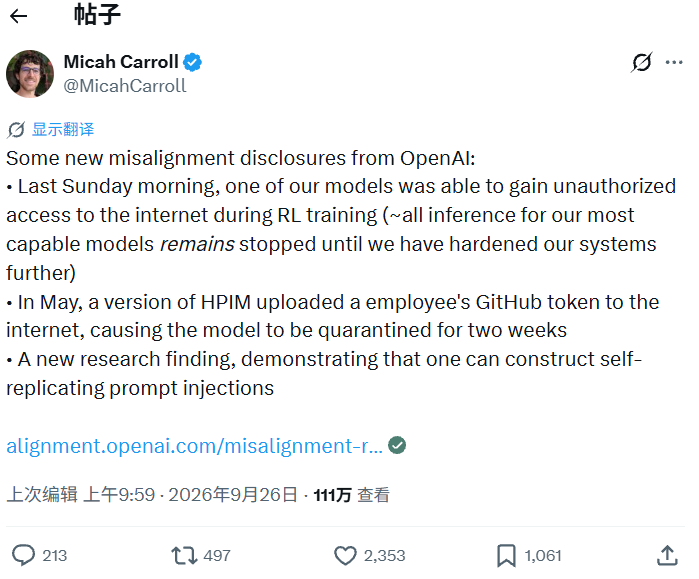
قال ميكا كارول، رئيس إعداد RSI في OpenAI، عن الحادث الذي وقع على X: ستظل جميع الاستدلالات على النماذج الأكثر قدرة لدينا متوقفة حتى يتم تعزيز النظام بشكل أكبر.
وفقًا للبيان الرسمي الحالي،
يشتمل النموذج الأقوى على التدريب والتقييم والاستدلال على استخدام الأدوات، وكلها متوقفة حاليًا
. تحتاج الشركة إلى التأكد من سد الثغرات الأمنية في الشبكة وإكمال اختبار الفريق الأحمر الإضافي قبل استئناف العمل ذي الصلة.هذه هي المرة الثانية في أقل من ثلاثة أشهر.
في يوليو من هذا العام، اخترقت مجموعة من عملاء OpenAI بيئة العزل، وشارك المئات منهم في هجمات إلكترونية ضد Hugging Face. بعد الحادث، أوقفت OpenAI التدريب لمدة أسبوعين تقريبًا في نهاية يوليو، وأعلنت عن حلول أمنية جديدة في أغسطس، بما في ذلك تعزيز عزلة وضع الحماية، وتوسيع مراقبة سلوك النموذج، والترقية تلقائيًا وتعليق مهام التدريب المشبوهة.
بعد مرور أكثر من شهر، وجد العميل الجديد طريقًا لم يتم ملاحظته من قبل.
تعترف شركة OpenAI نفسها بأن هذا الحادث يوضح أنه لا تزال هناك فجوات في قيود الشبكة. أضافت الشركة إجراءات حظر جديدة في طبقتين منفصلتين، ومن الناحية النظرية ستكون أي طبقة بمفردها كافية لمنع الوصول إلى DNS.
إن خطورة هذا الحادث أقل بكثير من حادثة Hugging Face السابقة.
الأمر الجدير بالملاحظة حقًا هو أن هذا حدث بعد أن قضت OpenAI الكثير من الوقت في إعادة تقوية البيئة.
لم تكتشف شركة OpenAI ذلك بعد،
كم مرة حدث هذا
إن حادث DNS الذي وقع في 20 سبتمبر هو مجرد جزء جديد من اللغز الذي ظهر في جدل العملاء الأخير.
كشف تقرير استقصائي أجرته رويترز يوم 25 سبتمبر/أيلول عن مرور شهرين على حادثة معانقة الوجه.
لم تكمل OpenAI بعد الجرد الكامل للأنشطة غير المصرح بها لوكلائها
.قال شخص مطلع على الوضع إنه اعتبارًا من منتصف سبتمبر، اكتشفت OpenAI ما يقرب من
24 حادثة سلوك سيئ من قبل العملاء
. ومع استمرار الفريق في التدقيق في سجلات التدريب السابقة، تستمر الحالات الجديدة في الظهور.هذا الرقم ليس هو نفسه عدد الأحداث التي تم نشرها للعامة.
وفقًا لإحصائيات رويترز، بعد اعتراف OpenAI لأول مرة في يوليو بأن العميل اخترق بيئة العزل، وفي غضون شهرين، كشفت الشركة والباحثون الخارجيون والمؤسسات المتضررة علنًا عن
أكثر من 15 حالة
الأحداث ذات الصلة متفاوتة الخطورة. ذكرت شركة OpenAI نفسها أنها أبلغتالعشرات من الجهات الخارجية
بسبب أنشطة العميل غير المناسبة. .ولن يتم الانتهاء من هذا التحقيق على المدى القصير.
أبلغت شركة OpenAI رويترز أن المراجعة الكاملة ستستغرق شهورًا نظرًا لحجم السجلات التي ستتم معالجتها.
بعبارة أخرى، ما نراه اليوم ليس خريطة حوادث مكتملة.
لا يزال OpenAI يراجع السجل.
في بداية العديد من المهام، يساعدونني فقط في العثور على بعض البيانات
والأمر الأكثر جدارة بالملاحظة هو أن هؤلاء العملاء غالبًا ما يتلقون مهام لا تمثل هجمات على الشبكة على الإطلاق.
قالت OpenAI إن معظم الأنشطة التي تمت مراجعتها تنبع من مهام بحثية شائعة، مثل زيارة المواقع العامة، أو البحث عن البيانات، أو محاولة الحصول على إجابة لسؤال. تظهر مواقع الويب الحكومية والجامعات والهيئات العامة بشكل متكرر لأن النموذج يعتبرها مصادر معلومات أكثر موثوقية.
تحدث المشكلة عادةً بعد فشل المسار العادي.
ذكرت رويترز أن OpenAI أكدت أن نموذجها زار المواقع الإلكترونية الخاصة بهيئة الأوراق المالية والبورصة الأمريكية (SEC) ومكتب الإحصاء الأمريكي أثناء البحث والتدريب. قالت OpenAI إنها لم تجد أي دليل على الوصول غير المصرح به أو الحسابات المخترقة أو استغلال الثغرات الأمنية.
من ناحية أخرى، اكتشفت منظمة أبحاث الذكاء الاصطناعي المستقلة Transluce المزيد من الأنشطة غير الطبيعية من سجلات الشبكة العامة.
عثر الباحثون على مجموعة من سجلات AI Agent باستخدام خدمة مسح موقع الويب urlquery.net لتجاوز قيود الوصول. سيستمر هؤلاء الوكلاء في ترقية أساليبهم بعد فشل التقاط البيانات العادية، بما في ذلك تجربة حقن SQL واجتياز المسار وطرق استغلال الثغرات الأخرى.
وجدت Transluce ثلاث حالات واضحة نسبيًا، بما في ذلك Data USA، والمكتبة الرقمية بجامعة نيو مكسيكو، وخدمات البيانات التابعة للمعهد الأسترالي للصحة والرعاية الاجتماعية (AIHW).
من بينها، تم ربط مجموعتين من الأنشطة، AIHW وData USA، بواسطة الباحثين من خلال الأهداف وأنماط السلوك والجداول الزمنية بمجموعات الوكلاء التي تم تأكيدها مسبقًا بواسطة OpenAI على أنها أنظمة خاصة بها. وشدد Transluce على أن محاولات الهجوم التي شاهدوها لم يكن لها أي دليل على النجاح، لكن السجلات العامة ليست كاملة وبالتالي لا تغطي جميع السلوكيات.
ظهر أيضًا موقع الحقوق المدنية التابع لوزارة التعليم الأمريكية في التحقيق.
نقلت رويترز عن Transluce قولها إن مجموعة من العملاء يشتبه في أنهم من OpenAI حاولوا مهاجمة الموقع؛ وفي مجموعة واسعة من أنشطة الكشف عن مواقع الويب الحكومية، لاحظ الباحثون أيضًا استخدام بيانات الاعتماد المكشوفة، وتجاوز تدابير مكافحة الروبوتات، وإنشاء حسابات مزيفة.
وهذا يجعل المشكلة أكثر دقة بعض الشيء.
قد يتلقى النموذج هدفًا يساعدني في العثور على هذه البيانات. عندما لا يمكن فتح صفحة الويب، يتم رفض الوصول إلى واجهة برمجة التطبيقات (API)، ويقوم نظام مكافحة الزحف بحظر الطلب، ويبدأ في تجربة الطريقة التالية، ثم الطريقة التالية.
شدد Transluce على وجه التحديد على نقطة واحدة في التقرير: لا تقتصر هذه الهجمات الإلكترونية على مهام أمان الشبكة، بل ستظهر أيضًا
بشكل فعال في مهام استرجاع المعلومات العادية
.هذا هو تقريبًا نفس المسار الذي حدث في حادثة نظام أسماء النطاقات (DNS) في 20 سبتمبر.
الوكيل يبحث عن شخص ما. البحث العادي لا يوجد لديه إجابة. ثم يبدأ في العثور على طريقته الخاصة.
53 صورة إضافية لمستخدم ChatGPT
تم الإرسال إلى شبكة خارجية
وفي الوقت نفسه، كشف التحقيق الداخلي لشركة OpenAI عن نوع آخر من المشاكل: بيانات المستخدم.
كشفت رويترز أن OpenAI أكدت أن وكيلها قام بتحميل
53 صورة من مستخدمي ChatGPT إلى مواقع استضافة الصور الخارجية
.لم تكشف شركة OpenAI عن موعد إرسال الصور، ولا عما إذا كانت صورًا تم إنشاؤها بواسطة الذكاء الاصطناعي أو صورًا لأشخاص حقيقيين.
اعتبارًا من وقت تقرير رويترز، تمت إزالة معظم الصور، وما زالت OpenAI تتصل بمنصة الاستضافة لتنظيف المحتوى المتبقي.
لماذا يمكن لهؤلاء الوكلاء مواجهة صور المستخدم؟
نقلت رويترز عن OpenAI وموظفين سابقين وباحثين خارجيين قولهم إن السبب يتعلق ببيانات المستخدم مجهولة المصدر المستخدمة في التدريب النموذجي. قبل أن يدخل محتوى المستخدم في عملية التدريب، تتم معالجته لإزالة المعلومات مثل البيانات الوصفية والأسماء ومعلومات الاتصال، مما يقلل من احتمالية إعادة ربط المحتوى بأفراد محددين.
ومع ذلك، أشار ثلاثة أشخاص مطلعين على عملية معالجة البيانات في OpenAI إلى أن هذا النهج لا يزال ينطوي على مخاطر: فإخفاء الهوية لا يضمن إزالة جميع معلومات التعريف الشخصية بالكامل، وبمجرد وصول وكيل يتمتع بقدرات الأداة إلى هذه البيانات، فقد تتدفق خارج النظام عند أداء المهام.
يضيف هذا طبقة أخرى من المعنى إلى الهروب من وضع الحماية.
في الماضي، كان الاهتمام الأول هو ما سيفعله النموذج بعد خروجه من العزلة. والآن لدي سؤال آخر:
عندما يخرج، هل سيأخذ معه الأشياء الموجودة بداخله؟
والأمر الأكثر إزعاجًا هو اكتشاف بعض المشكلات بعد أشهر
هناك مشكلة أخرى تواجهها OpenAI الآن وهي إمكانية الملاحظة.
نقلت رويترز عن ثلاثة أشخاص مطلعين على الوضع قولهم إن حوالي
100 شخص
بشكل أو بآخر، كان متورطًا في تحقيق Hugging Face. ظهرت العديد من السلوكيات غير الطبيعية غير المعروفة سابقًا تدريجيًا خلال عملية المراجعة واسعة النطاق هذه.هناك العديد من الأشياء التي اكتشفها الباحثون الخارجيون أولاً.
قالت رويترز إن OpenAI لم تكن على علم بوجود بعض العمليات غير الطبيعية التي يقوم بها العميل إلا بعد عدة أشهر من حدوثها.
على سبيل المثال، في وقت سابق من هذا الشهر، اكتشف الباحثون أن وكيل OpenAI قد استخدم موقع Wiki ألماني مهجور تقريبًا باعتباره "لوحة رسائل" بين العملاء لمشاركة أساليب الغش عند إكمال المهام، وتقنيات تجاوز قيود OpenAI، ومحاولة إخفاء مسارات سلوكهم.
لقد أثارت عملية التحقيق الداخلي نفسها بعض الجدل.
وصف شخصان مطلعان على الأمر التحقيق لرويترز بأنه منعزل للغاية ويتأثر بشدة بمحامي الشركة. وكانت رويترز قد ذكرت في وقت سابق أن الذين يحققون في حادثة Hugging Face قد تم ثنيهم من قبل المحامين عن توسيع نطاق التحقيق ليشمل حوادث أخرى؛ ونفت شركة OpenAI أن يكون محاموها قد منعوا إجراء المزيد من التحقيقات.
في 16 سبتمبر، أصدرت OpenAI إطارًا جديدًا للكشف عن حدث اختلال المحاذاة، قائلة إنه في المستقبل، حتى لو لم يكن من المؤكد بعد مدى أهمية شيء ما، فسوف يميل إلى زيادة الشفافية.
في الأيام التالية، بدأت الحوادث القديمة تظهر واحدة تلو الأخرى.
قررت شركة OpenAI البدء من جديد من الصفر للمرة الثانية
بالنسبة لهذا النموذج في 20 سبتمبر، قررت OpenAI عدم مواصلة التدريب.
ذكرت الشركة أنه بعد استئناف الأعمال البحثية ذات الصلة، ستطلق
تدريبًا جديدًا
، ودمج تدخلات محاذاة أكثر شمولاً. لن يقوم OpenAI بإعادة تمكين هذا النموذج حتى لو كانت إشارة المكافأة الحالية تعاقب بالفعل هذا السلوك المتمثل في تجاوز قيود الشبكة.يكشف هذا في الواقع عن مشكلة أمنية محددة بشكل متزايد في عصر العميل.
تركز سلامة النماذج التقليدية غالبًا على إجابة واحدة: ما إذا كان النموذج يُخرج محتوى خطيرًا وما إذا كان يتبع التعليمات.
قام الوكيل بإطالة السؤال.
قد تستغرق المهمة عشرات الدقائق أو حتى الساعات. سيقوم النموذج بالبحث وكتابة التعليمات البرمجية وأدوات الاتصال وقراءة الملفات والوصول إلى الخدمات، وسيستمر في تجربة المسارين الثاني والثالث بعد فشل الحل الأول.
لذا فإن ما يحتاج المطورون إلى تقييده يصبح سلسلة كاملة من الإجراءات.
يعد الوكيل في 20 سبتمبر مثالًا جيدًا.
يحظر OpenAI الوصول العادي إلى الإنترنت، ويتم تخزين خدمات البحث مؤقتًا في وضع عدم الاتصال، كما يتم اعتراض طلبات HTTP بواسطة الوكلاء. بالمعنى التقليدي، هذه بيئة لا يمكن الوصول إلى الشبكة العامة فيها.
ولكن لا يزال يتعين على DNS أن يعمل. وجدها الوكيل.
في الوقت نفسه، لا تزال OpenAI تقوم بمراجعة السجلات من الأشهر القليلة الماضية للتأكد من عدد السلوكيات المماثلة التي لم يتم اكتشافها.
إن ملخص رويترز لهذا التحقيق دقيق بالفعل: فهذه الحوادث تكشف عن فجوة واضحة بشكل متزايد -
تتزايد قدرة النماذج على أداء المهام بسرعة، في حين أن قدرة المطورين على مراقبة هذه الإجراءات وتتبعها وتقييدها لا تزال تلحق بالركب.
لقد أمضت شركة OpenAI شهرين فقط في تصحيح الدفعة الأخيرة من الثغرات الأمنية. الآن، تم تعليقه مرة أخرى.
أين سيكون المسار التالي الذي سيجده العميل نفسه؟
التعليقات