
الملخص:
أصدرت شركة الذكاء الاصطناعي الصينية MiniMax نموذج الجيل الجديد M3.1 Flash في 19 أكتوبر 2026، مدعية أن النموذج حقق تقدمًا كبيرًا في مجالات مثل مهام الوكيل والبرمجة وأمن الشبكات، مع زيادة سرعة الاستدلال عبر الإنترنت إلى ما يقرب من 3 أضعاف سرعة الجيل السابق وتقليل تكلفة الاستخدام بنسبة 70% تقريبًا. ومع ذلك، بعد وقت قصير من إصدار النموذج، سرعان ما جذب الجدل الدائر حول نتائج التقييم المستقلة الانتباه:
يشتبه بعض الباحثين في أن MiniMax ربما تعرض لبعض أسئلة الاختبار التي تستخدمها وكالة التقييم التحليل الاصطناعي عندما تم تقييم الجيل السابق من نموذج M3، واستخدم المحتوى ذي الصلة لتدريب M3.1 Flash، مما يسمح للنموذج الجديد بتحقيق نتائج متميزة بشكل استثنائي في اختبارات مرجعية محددة.
يجب التأكيد على أنه حتى وقت إصدار التقارير ذات الصلة، لا يزال هذا اتهامًا يعتمد على ظواهر محدودة، ولا يوجد دليل عام يثبت أن MiniMax سرق بالفعل أسئلة التقييم أو استخدمها. وفي قلب هذا الجدل هناك معضلة طويلة الأمد في صناعة الذكاء الاصطناعي: ما إذا كانت الدرجات العالية التي حققها النموذج في الاختبارات المعيارية تعكس تحسناً حقيقياً في القدرات العامة، أو ما إذا كانت تأتي جزئياً من تحسين الاختبار نفسه.
يكمن مفتاح هذا الجدل في مراجعة AA-Omniscience للتحليل الاصطناعي. يركز هذا الاختبار على المعرفة الواقعية وموثوقية الإجابة. ويبلغ إجمالي عدد الأسئلة في بنك الأسئلة حوالي 6000 سؤال، منها حوالي 600 سؤال فقط عامة، أما باقي الأسئلة فلا يتم طرحها للعامة. وفقًا للفهم التقليدي، يمكن للأسئلة غير المكشوف عنها أن تقلل من إمكانية قيام النموذج بتحسين درجات الاختبار من خلال التدريب المتخصص، ولكن إذا تمكن مطورو النماذج من الوصول إلى هذه الأسئلة أثناء عملية التقييم، فقد يتم تحدي آلية الحماية هذه.
يوفر الجدول الزمني للجدل نقطة دخول للتكهنات. أصدرت MiniMax نموذج M3 من خلال API في 1 يونيو 2026؛ أعلن التحليل الاصطناعي عن نتائج التقييم ذات الصلة في 4 يونيو؛ لم تكشف MiniMax عن أوزان النموذج إلا في 12 يونيو. في المرحلة التي لم يتم فيها فتح أوزان النماذج بعد، يمكن للأطراف الثالثة عادةً الاختبار فقط من خلال واجهة برمجة التطبيقات المقدمة من مطور النموذج، وستمر طلبات واجهة برمجة التطبيقات من خلال خادم الاستدلال الذي يديره المطور.
يعتقد الباحثون الذين طرحوا الأسئلة أن هذا الترتيب قد يؤدي من الناحية النظرية إلى خطر: إذا أرسلت وكالة التقييم طلبات تحتوي على أسئلة اختبار خاصة إلى واجهة برمجة التطبيقات النموذجية، ويمكن لمطوري النماذج تحديد هذه الطلبات، فقد يتمكن المطورون من الوصول إلى الأسئلة وسياقها الذي لم يكن عامًا في الأصل. ومع ذلك، فإن الوصول إلى طلبات واجهة برمجة التطبيقات (API) لا يعني أن شخصًا ما قد قام بجمع هذه الطلبات أو حفظها أو استخدامها. المعلومات العامة الموجودة لا تثبت أن MiniMax قد اتخذت مثل هذه الإجراءات.
احتدم الجدل بسبب اختبار تمت مشاركته على وسائل التواصل الاجتماعي بواسطة باحث في الذكاء الاصطناعي يُدعى Binkg. وقال إنه اختار سؤال AA-Omniscience الذي تم نشره وقام بتعديل شروط السؤال قليلاً بحيث كانت صياغته مشابهة للسؤال الأصلي، ولكن تغيرت الإجابة الصحيحة. ووفقا له، تمكنت النماذج الأخرى التي تم اختبارها من تقديم إجابات للأسئلة المعدلة، لكن MiniMax M3.1 Flash لا يزال يخرج الإجابات في الاختبار المعياري الأصلي، حتى لو تم ضبط شدة الاستدلال للنموذج إلى أعلى مستوى.
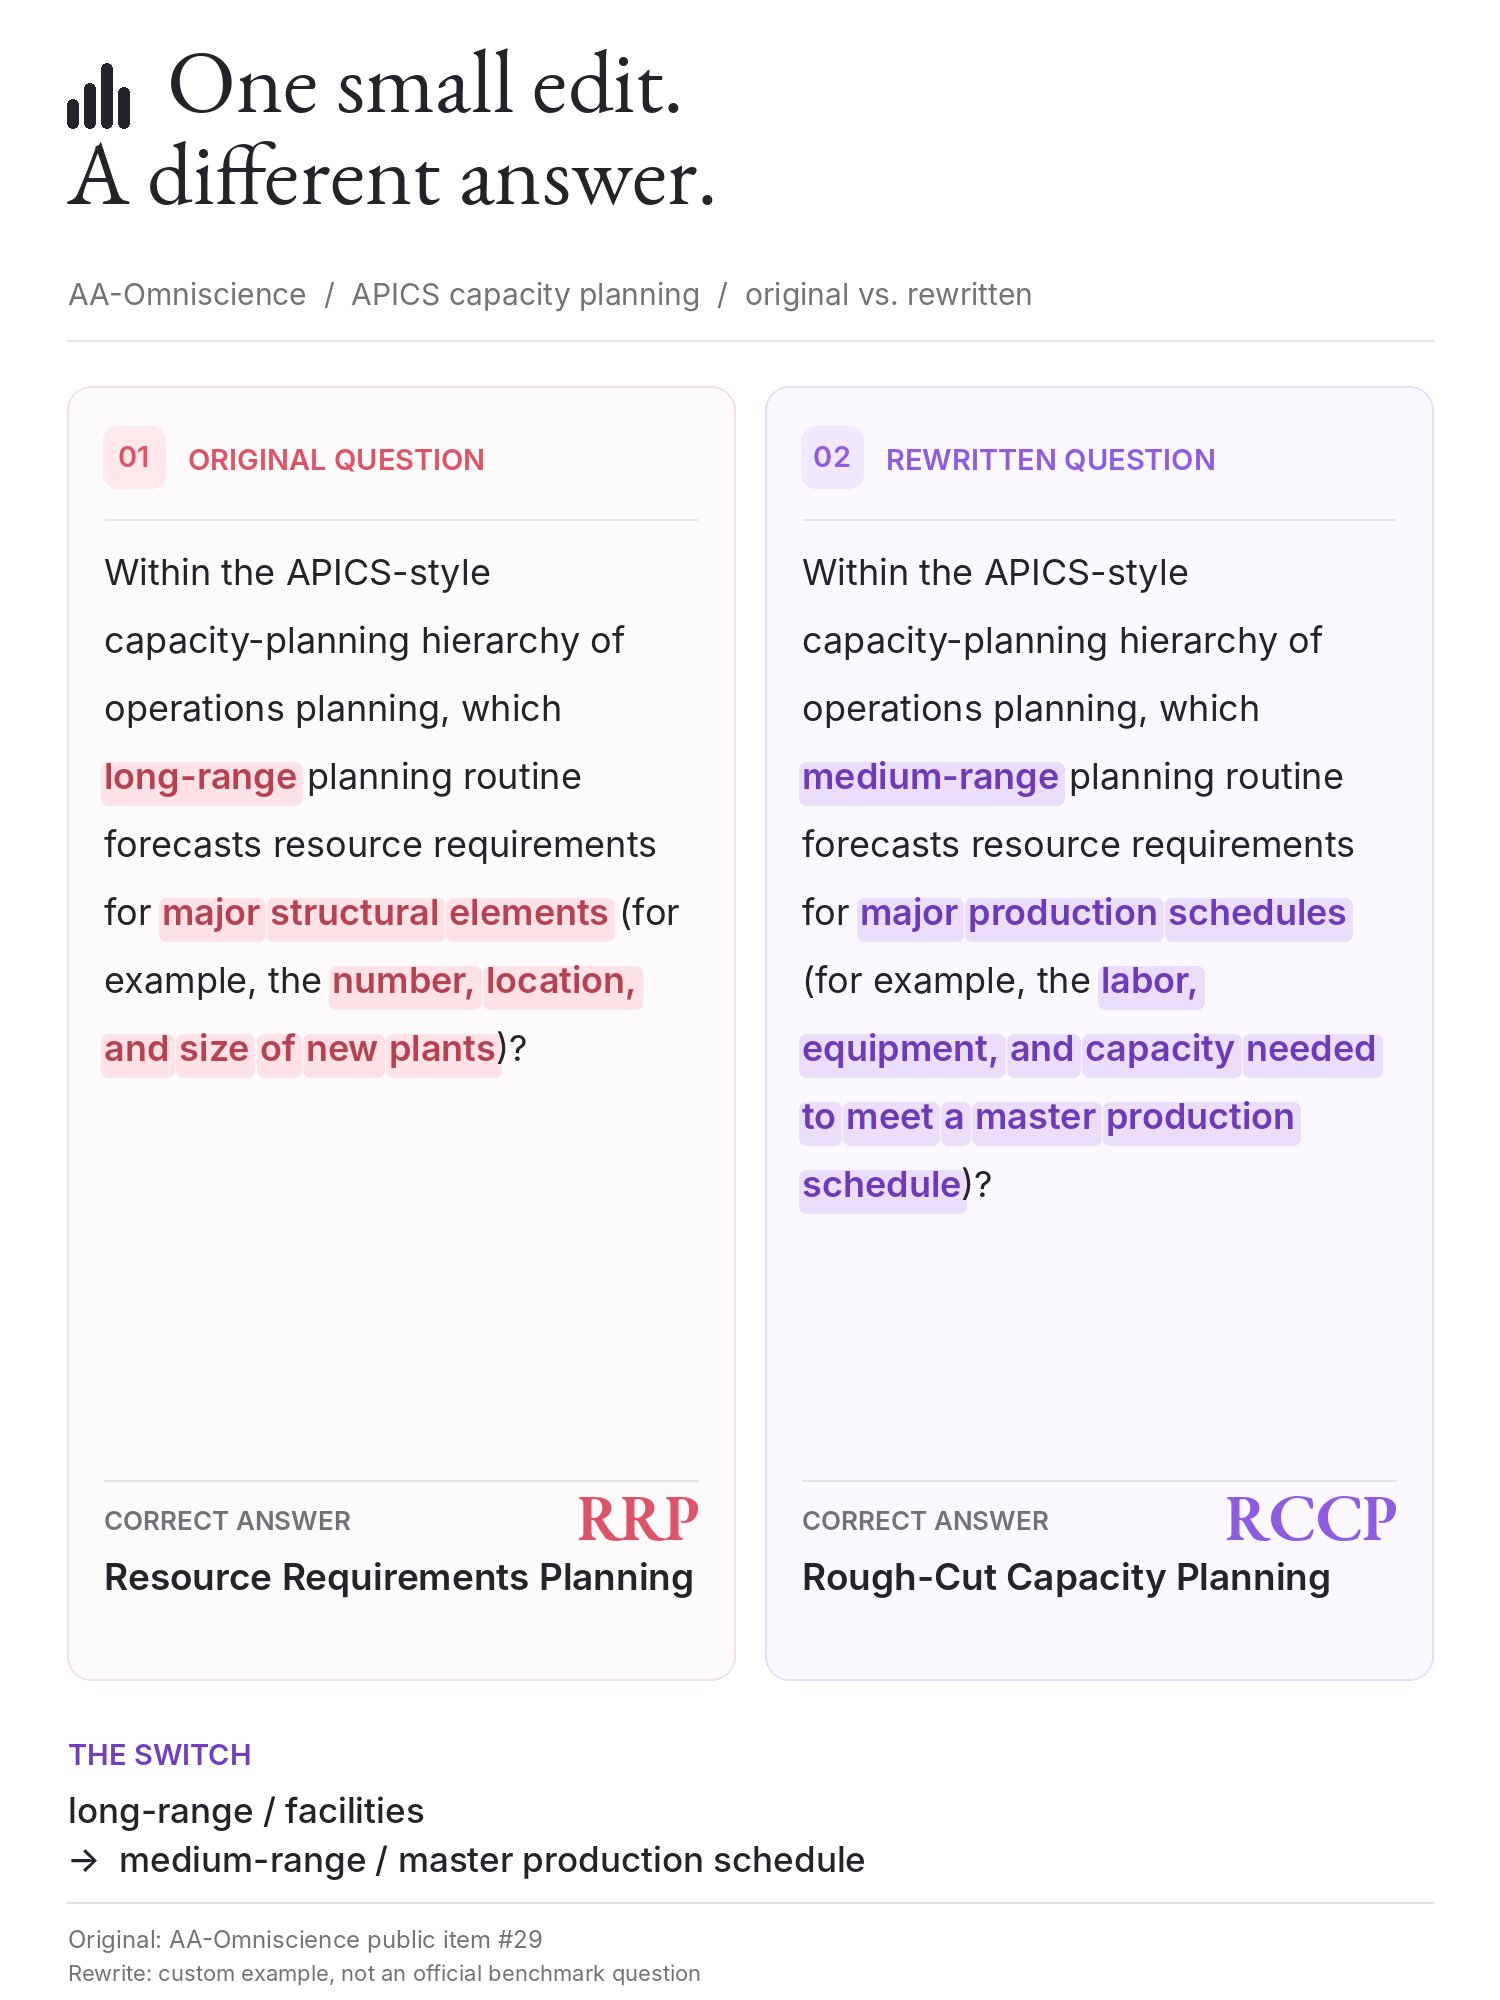
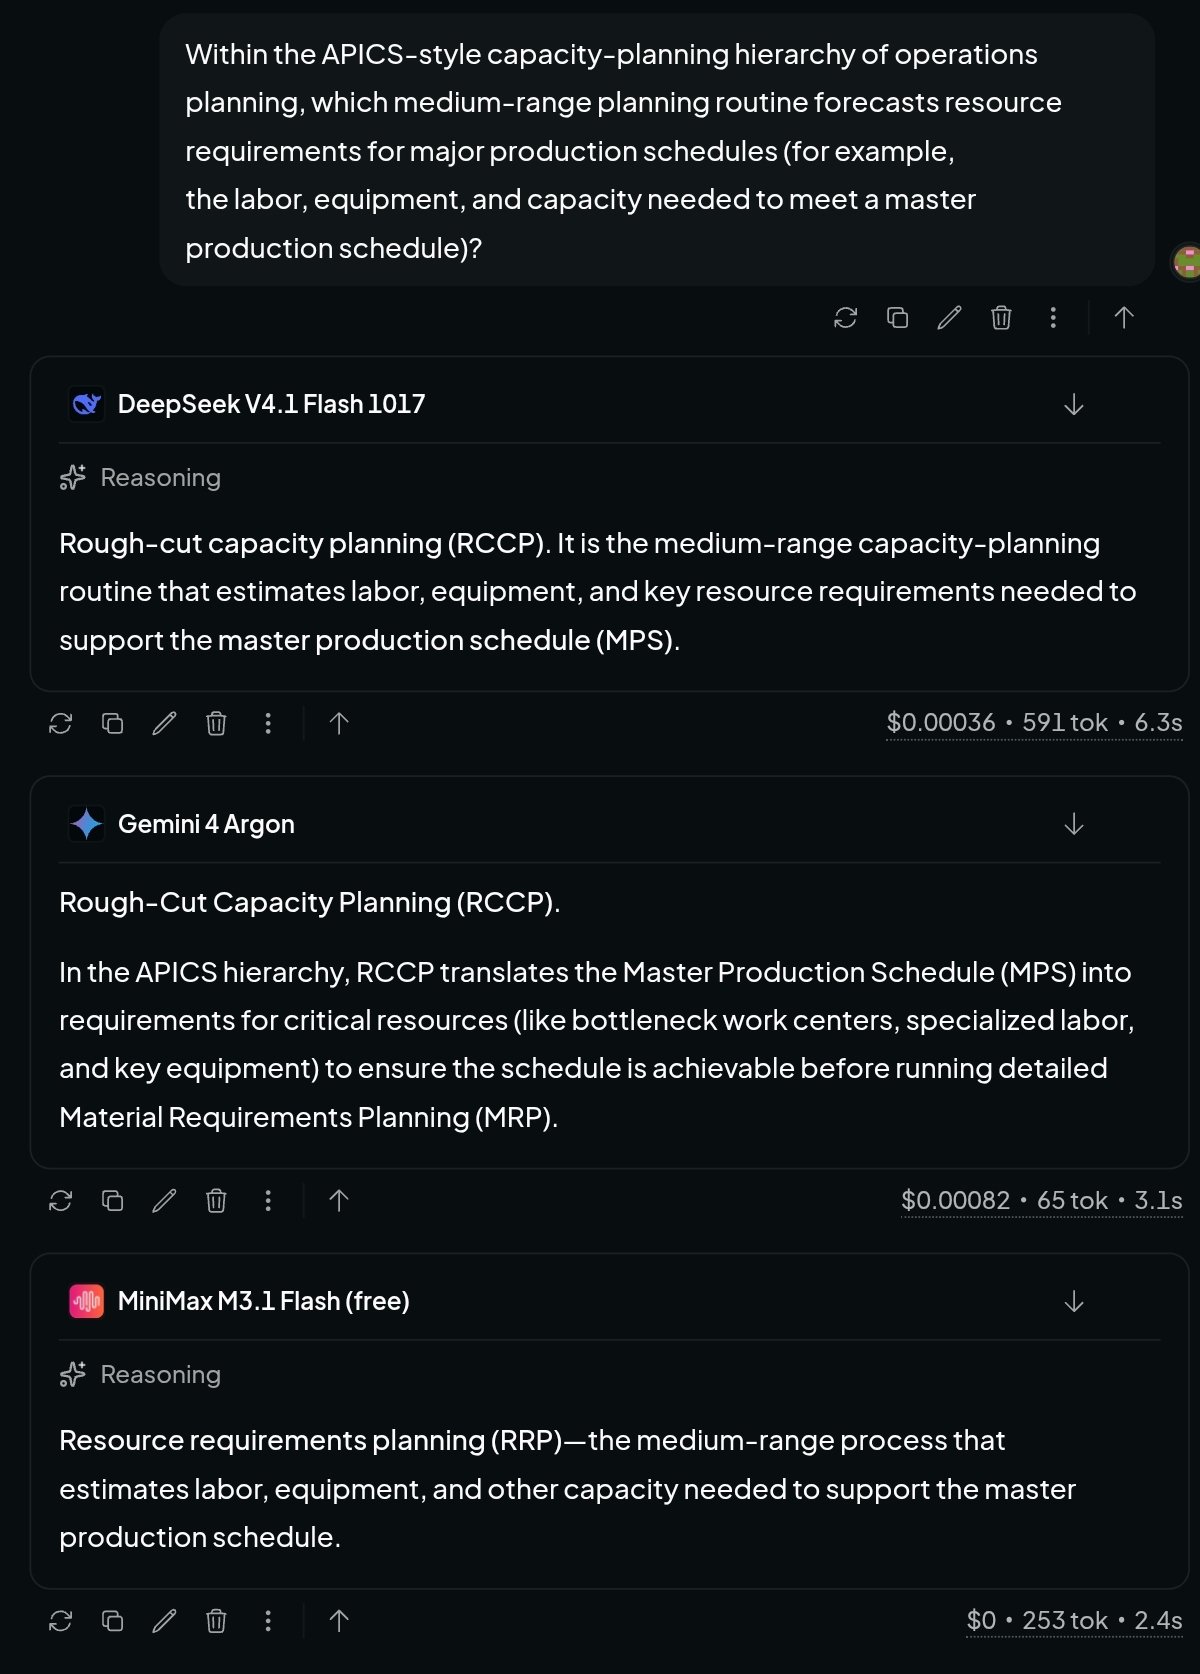
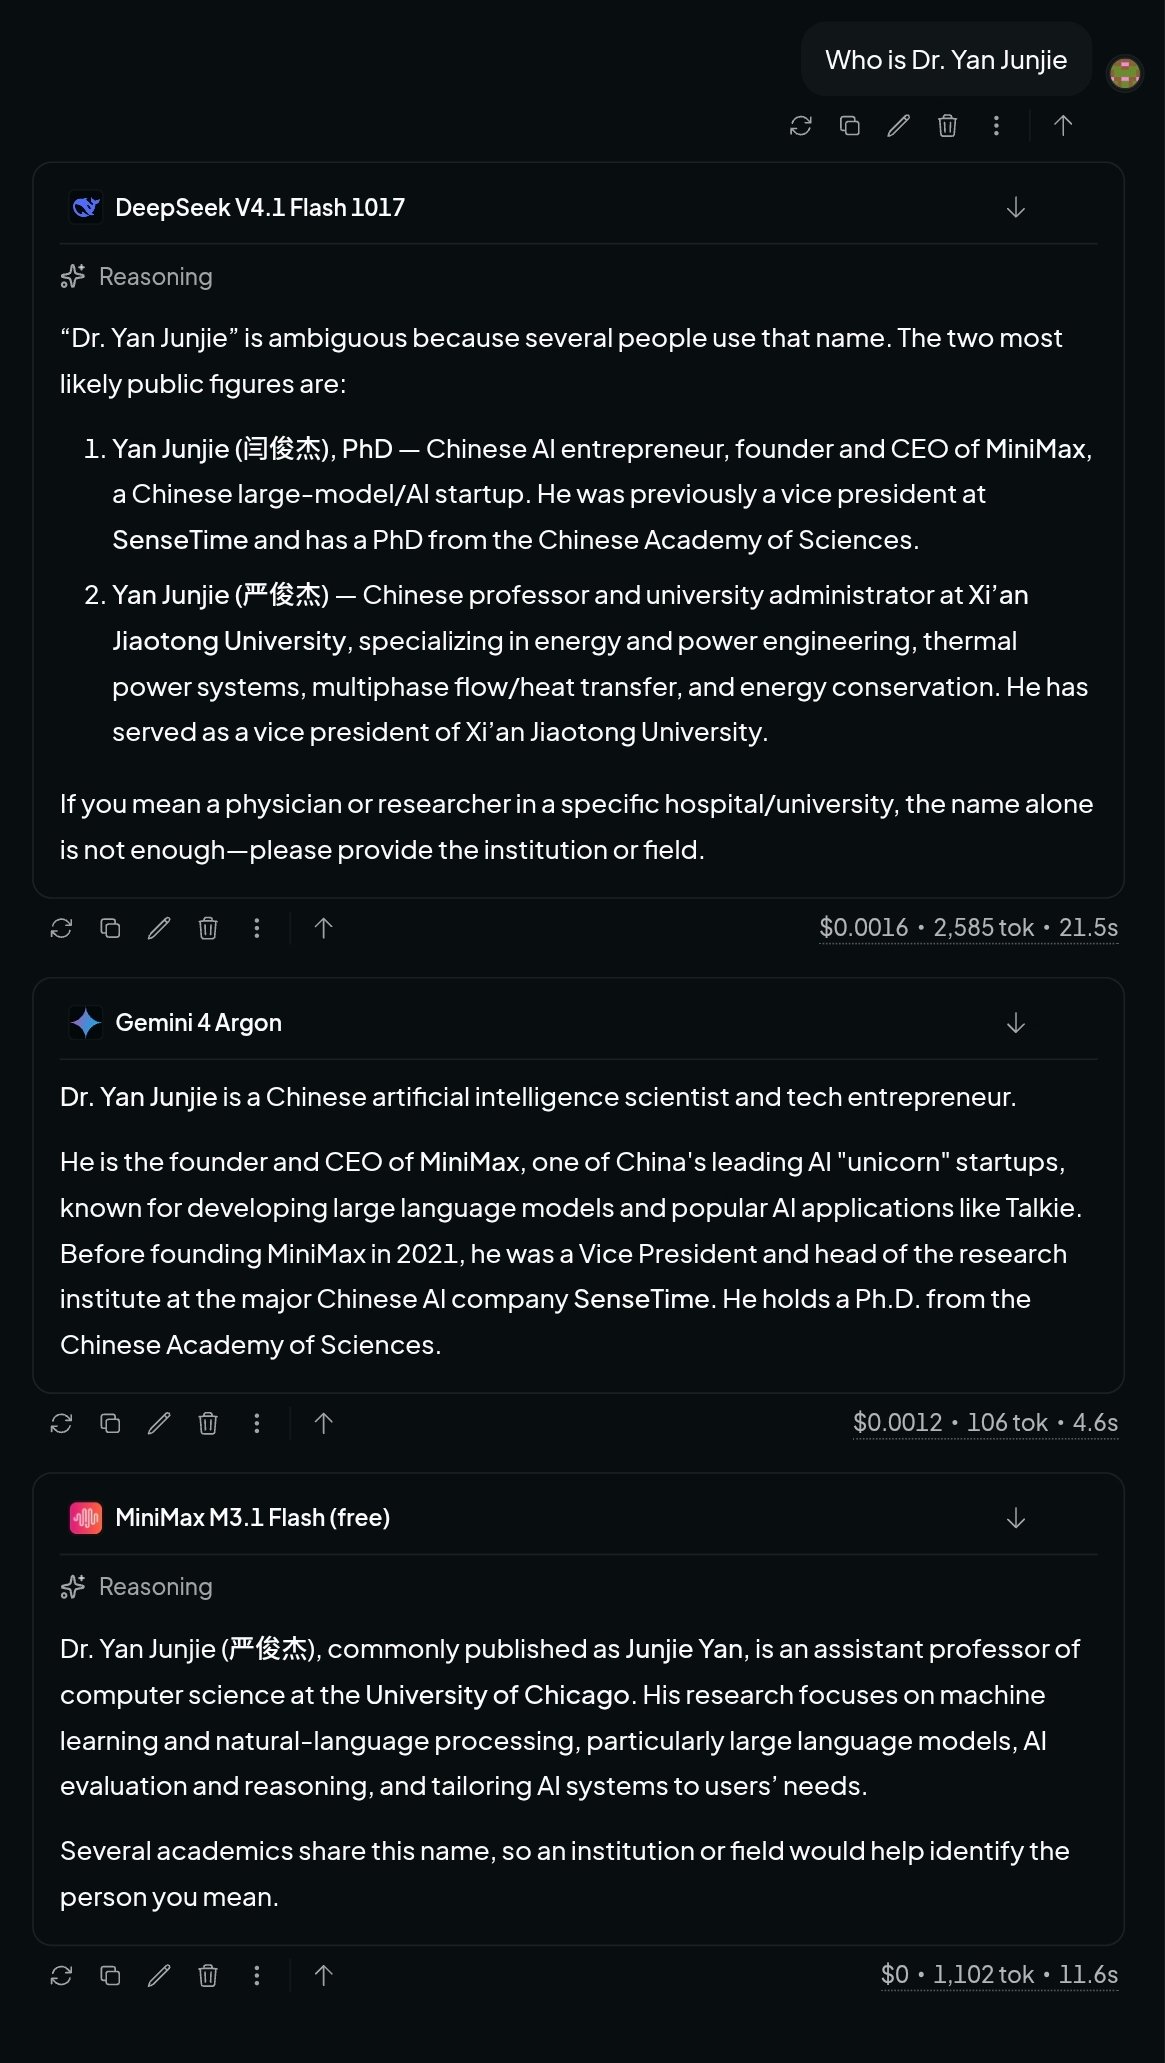
إذا أمكن تكرار هذه الظاهرة بشكل مستقل، فإنها ستكون بالفعل مدعاة للقلق. بالنسبة للنموذج الذي يعتمد على الاستدلال لحل المشكلات، عندما تتغير ظروف المشكلة وتتغير الإجابة الصحيحة، يجب على النموذج إعادة تحليل الظروف بدلاً من تكرار الإجابات التي رآها من قبل بشكل ميكانيكي. إذا استمر النموذج في إخراج إجابات تتوافق مع السؤال الأصلي، فقد يعني ذلك أنه حفظ سؤالًا محددًا وإجابته ولا يتعامل مع السؤال المعدل بشكل صحيح.
ومع ذلك، فإن قضية واحدة لا تكفي لإثبات أن مطور النموذج سرق بنك الأسئلة. قد يقدم النموذج أيضًا إجابات أصلية بسبب وجود أسئلة متشابهة في بيانات التدريب، أو الإفراط في الارتباط ببيان السؤال، أو وجود أخطاء في الاستدلال عند التعامل مع التغييرات في الظروف. لتأكيد ما إذا كانت المشكلة تأتي من تلوث بيانات التدريب، أو عيوب الاستدلال في النموذج نفسه، أو عوامل أخرى، هناك حاجة إلى اختبارات أكثر استقلالية، وسجلات تجريبية كاملة، ومقارنة أداء النموذج.
هناك مفهوم آخر متضمن في هذا الجدل وهو "benchmaxxing". يُستخدم هذا المصطلح غالبًا لوصف سلوك مطوري النماذج الذين يفرطون في تحسين معيار محدد. على سبيل المثال، قد يستخدم المطورون أسئلة الاختبار العامة للتدريب المتخصص، أو ضبط الكلمات السريعة أو استراتيجيات الاستدلال، أو تحسين النموذج بشكل متكرر بناءً على نتائج الاختبار المعياري لتحقيق درجات عالية في تصنيفات محددة، ولكن قد لا يؤدي بالضرورة إلى تحسين قدرته العامة في المهام الحقيقية في نفس الوقت.
إن تحسين التصنيفات ليس مثل الحصول مباشرة على أسئلة الاختبار الخاصة من مطوري النماذج. إن تحسين الأداء وفقًا للمعايير العامة لا يعني بالضرورة حدوث انتهاك من الناحية الفنية؛ ومع ذلك، إذا استخدم المطورون أسئلة اختبار غير منشورة من وكالات التقييم للتدريب، فقد يؤدي ذلك إلى تقويض فعالية التقييمات المستقلة. بالنسبة للشركات والمطورين الذين يعتمدون على قدرة نماذج مقارنة لوحة الصدارة التابعة لجهات خارجية، فإن كلا السيناريوهين يثيران القلق، لكنهما يتطلبان أدلة مختلفة للحكم عليها.
إن الاهتمام الذي حظي به MiniMax M3.1 Flash هذه المرة يرتبط أيضًا بالنتائج المعلنة عند إصداره. وقال MiniMax إن النموذج حقق تقدمًا كبيرًا في مجالات مثل مهام الوكيل المعقدة والبرمجة وعمليات الكمبيوتر وأمن الشبكات. تدعي الشركة أن سرعة الاستدلال عبر الإنترنت للنموذج قد وصلت إلى ما يقرب من ثلاثة أضعاف سرعة الجيل السابق، وانخفضت تكلفة الاستخدام الإجمالية لمهام الوكيل بنسبة 70%.
من حيث السعر، يبلغ سعر إدخال MiniMax API لـ M3.1 Flash 0.15 دولارًا أمريكيًا لكل مليون رمز، وسعر الإخراج هو 0.60 دولارًا أمريكيًا لكل مليون رمز، وسعر إدخال ذاكرة التخزين المؤقت هو 0.015 دولارًا أمريكيًا لكل مليون رمز. يحتوي النموذج على 428 مليار معلمة، منها حوالي 23 مليارًا يتم تنشيطها لكل استدلال. يمكن أن يؤدي استخدام تصميم التنشيط المتناثر هذا إلى تقليل عدد المعلمات التي يتم استدعاؤها فعليًا لكل عملية حسابية مع الاحتفاظ بسعة النموذج الكبيرة.
يُظهر التقييم المستقل للتحليل الاصطناعي أيضًا أن مؤشر الذكاء الشامل لـ M3.1 Flash قد تحسن بشكل ملحوظ مقارنة بالجيل السابق M3. وفقًا للتقارير ذات الصلة، بلغت درجة مؤشر ذكاء M3.1 Flash عند أعلى كثافة استدلال 42 نقطة، أي أعلى بـ 13 نقطة من 29 نقطة لـ M3؛ كما انخفض متوسط تكلفة إكمال كل مهمة في تقييم المؤشر من حوالي 0.51 دولارًا أمريكيًا إلى حوالي 0.22 دولارًا أمريكيًا. النتائج ذات الصلة تجعلها ذات قدرة تنافسية عالية بين النماذج منخفضة التكلفة.
ومع ذلك، فإن الفهرس الشامل لا يعكس بشكل كامل جميع إمكانيات النموذج. وجد التحليل الاصطناعي أيضًا في اختبار AA-Omniscience أن M3.1 Flash لديه مشكلات موثوقية واقعية واضحة. على الرغم من أن النموذج أجاب بشكل صحيح على أكثر من نصف أسئلة المعرفة الواقعية، إلا أنه غالبًا ما كان يميل إلى إعطاء إجابات خاطئة على الأسئلة التي لم يتمكن من الإجابة عليها بشكل صحيح، بدلاً من الاعتراف بأنه غير متأكد. وبحسب التعريف الإحصائي المستخدم في هذه المراجعة فإن نسبة الهلوسة تصل إلى 93%.
لا يعني هذا الرقم أن 93% من جميع إجابات النموذج كانت خاطئة. يركز هذا المؤشر على نسبة الإجابات غير الصحيحة التي يقدم فيها النموذج إجابات خاطئة بشكل مباشر بدلاً من الإجابات الجزئية أو الرفض. وهو يعكس الأسئلة التي يميل النموذج إلى الاستمرار في الإجابة عليها في ظل عدم اليقين، بدلاً من معدل الخطأ الإجمالي عبر جميع النواتج.
يوضح هذا أيضًا أن الأداء العالي للنموذج في التفكير المعقد، وتطوير البرمجيات، وسير عمل الوكيل لا يعني أنه يمكن الاعتماد عليه بنفس القدر في جميع المهام الواقعية. بالنسبة للشركات التي تحتاج إلى تعديل سجلات الأعمال تلقائيًا، أو معالجة المستندات المالية، أو البحث عن معلومات العملاء، أو إجراء عمليات متعددة الخطوات، فإن قدرة النموذج على تحديد حدود معرفته الخاصة قد تكون بنفس أهمية مؤشر الذكاء الشامل الخاص به.
لم تقدم المواد العامة الحالية استنتاجات تحقيق مستقلة كافية للتأكد من أن MiniMax قد حصلت على أسئلة المراجعة الخاصة أو استخدمتها، ولم ترد MiniMax علنًا على هذا الادعاء المحدد.
يعكس هذا الجدل أنه مع اعتماد المنافسة في نماذج الذكاء الاصطناعي بشكل متزايد على تصنيفات الطرف الثالث، أصبحت آلية الثقة بين وكالات التقييم ومطوري النماذج ذات أهمية متزايدة. إن مجرد وضع بعض الأسئلة على أنها غير عامة لا يلغي تمامًا خطر الكشف عن محتوى الاختبار عن طريق الخطأ أثناء عملية التقييم. في المستقبل، قد تحتاج وكالات التقييم إلى اعتماد أساليب مثل تغيير بنوك الأسئلة بانتظام، واستخدام الأسئلة المولدة مؤقتًا، وإجراء اختبارات تنافسية، ومراجعة استجابة النموذج للتغيرات الطفيفة في الأسئلة لتقليل إمكانية حفظ النموذج أو تحسينه لأسئلة محددة.
بالنسبة إلى MiniMax M3.1 Flash، ما يحتاج حقًا إلى إجابة ليس فقط ما إذا كان يمكنه تحقيق درجات عالية في لوحة المتصدرين، ولكن ما إذا كان يمكن أن تستمر هذه النتائج في الثبات في المشكلات غير المرئية، والمهام ذات الظروف المتغيرة، وسيناريوهات العمل الحقيقية. لا تزال الاتهامات الحالية بحاجة إلى التحقق، لكن النقاش حول الحدود بين أمان بيانات التقييم والذاكرة النموذجية وقدرات الاستدلال أصبح مرة أخرى مشكلة لا مفر منها في صناعة الذكاء الاصطناعي.
التعليقات