الملخص:
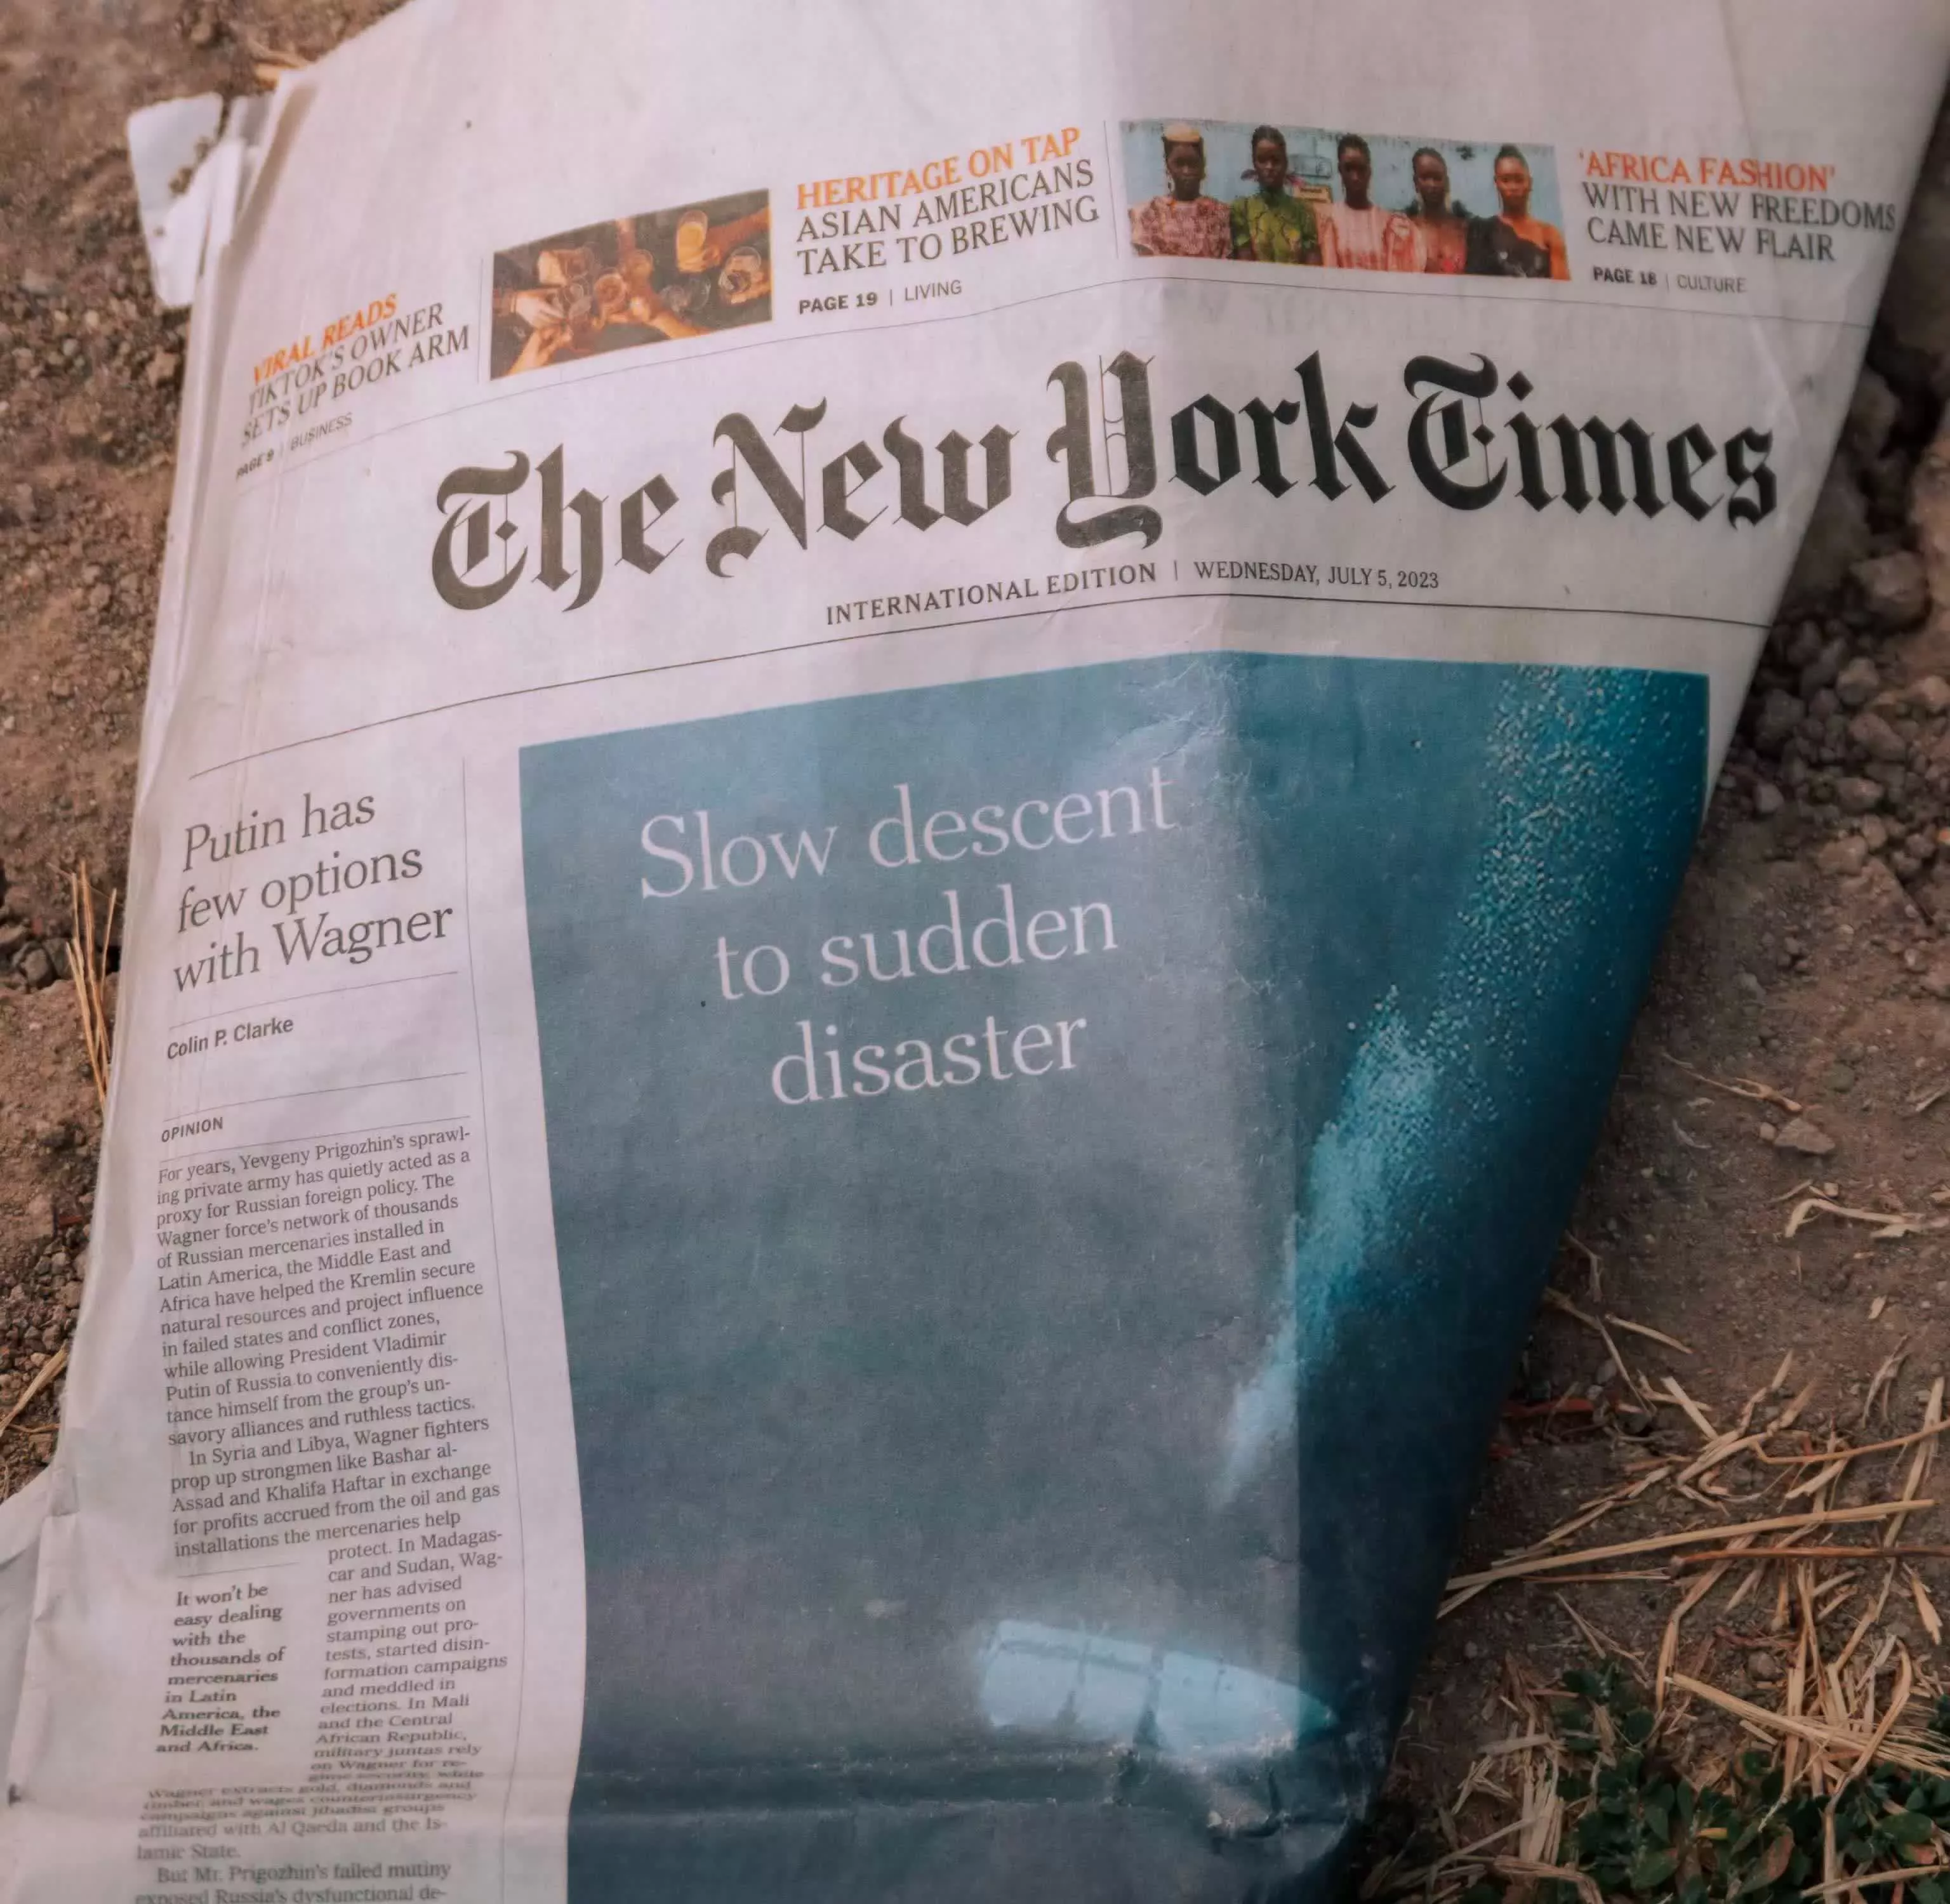
احتدم الجدل الدائر حول شرعية بيانات تدريب الذكاء الاصطناعي التوليدي مرة أخرى مؤخرًا. تُظهر وثيقة المحكمة التي تم الكشف عنها في دعوى حقوق الطبع والنشر المرفوعة في صحيفة نيويورك تايمز أن أحد كبار مديري الأبحاث في مايكروسوفت وصف ذات مرة في مناقشة داخلية أن طريقة التدريب الحالية لنماذج اللغات الكبيرة قد تكون "أكبر سرقة عمالة في تاريخ البشرية". وقد اجتذبت البيانات ذات الصلة اهتماما واسع النطاق في الصناعة.
التصريحات التي تم الكشف عنها هذه المرة جاءت من برنت هيشت، مدير العلوم التطبيقية في مايكروسوفت. وفقًا لأحدث الوثائق القانونية العامة، عند مناقشة استخدام Microsoft وOpenAI وشركات الذكاء الاصطناعي الأخرى لمحتوى الإنترنت الضخم لتدريب النماذج، وصف هيشت ذات مرة هذه العملية بأنها "سرقة مذهلة على نطاق غير مسبوق" وذكر أيضًا أن هذه قد تكون "أكبر سرقة عمالة في تاريخ البشرية".
يظهر هذا المحتوى في دعوى حقوق الطبع والنشر التي رفعتها صحيفة نيويورك تايمز ومنشورات إخبارية أخرى ضد Microsoft وOpenAI. ويعتقد المدعون أن الشركتين استخدمتا تقارير إخبارية ومحتويات أخرى محمية بحقوق الطبع والنشر لتدريب نماذج الذكاء الاصطناعي دون تصريح واستخدامها لتطوير منتجات تجارية.
تلتزم Microsoft وOpenAI دائمًا بموقف "الاستخدام العادل". وتعتقد الشركتان أن عملية التدريب النموذجية تشبه قيام الطلاب بقراءة الكتب لتعلم المعرفة وتقع ضمن نطاق الاستخدام العادل. ويجادلون أيضًا بأن المحتوى الذي تم إنشاؤه بواسطة الذكاء الاصطناعي قد حول المادة الأصلية بما يكفي بحيث لا يشكل نسخًا مباشرًا.
ومع ذلك، يبدو أن بعض سجلات الاتصالات الداخلية في الوثائق التي تم الكشف عنها حديثًا تتناقض بشكل واضح مع هذا الموقف العام.
تظهر الوثائق أن هيشت كان يعتقد ذات مرة أنه إذا فازت الدعوى القضائية، فقد تحتاج الشركات المعنية إلى "الاستهزاء التام بمفهوم الاستخدام العادل". يعتبر هذا البيان دليلاً مهمًا من قبل المدعي ويستخدم للتشكيك في منطق الدفاع عن حقوق الطبع والنشر الذي التزمت به شركات الذكاء الاصطناعي منذ فترة طويلة.
وفي الوقت نفسه، كشفت الوثيقة أيضًا عن بعض المناقشات الداخلية من OpenAI. يُظهر أحد السجلات أن المؤسس المشارك لـ OpenAI جريج بروكمان يعترف بأنه عندما تم عرض النموذج لمحتوى صحيفة نيويورك تايمز، كان ChatGPT قادرًا بالفعل على التنبؤ بالجمل ومواصلتها في المقالات ذات الصلة. يتم استخدام هذا النوع من المحتوى من قبل المدعين لإثبات أن النموذج لديه القدرة على إعادة إنتاج العمل الأصلي، بدلاً من مجرد تلخيص المعلومات المكتسبة.
وكشفت وثائق الدعوى أيضًا أن مخاوف هيشت بشأن التطور طويل المدى لصناعة الذكاء الاصطناعي لا تقتصر على قضية حقوق الطبع والنشر نفسها. لقد اقترح ذات مرة ما يسمى بمفهوم "حلقة يوم القيامة" في مستند عرض تقديمي داخلي آخر.
باتباع هذا المنطق، تعمل محركات الإجابة بالذكاء الاصطناعي على تقليل حاجة المستخدمين لزيارة المواقع الإخبارية تدريجيًا، مما يؤدي إلى انخفاض حركة الوسائط وإيرادات الأعمال. مع فقدان المزيد والمزيد من مؤسسات إنتاج المحتوى لاستمراريتها، ستنخفض أيضًا مصادر المعلومات عالية الجودة التي ستتعلمها أنظمة الذكاء الاصطناعي في المستقبل، مما سيؤدي في النهاية إلى الإضرار بالنموذج والنظام البيئي للإنترنت بأكمله.
وأشار في وثائق داخلية إلى أنه من النادر جدًا أن يهدد منتج ما الأساس الاقتصادي لمورديه الرئيسيين، لكن صناعة الذكاء الاصطناعي في هذا الوضع حاليًا. نظرًا لأن المؤسسات الإخبارية ومنشئي المحتوى يمثلون مصادر مهمة للمعلومات لنماذج الذكاء الاصطناعي، فعندما تتأثر هذه المجموعات، فإن سلسلة توريد المحتوى بأكملها معرضة للخطر.
استشهد المدعي أيضًا ببيانات Microsoft الداخلية وادعى أن أنظمة الرد بالذكاء الاصطناعي مثل Copilot كان لها تأثير كبير على حركة مرور بعض المواقع الإخبارية. وفي بعض الحالات، انخفضت نسبة المستخدمين الذين نقروا للدخول إلى صفحة نيويورك تايمز بأكثر من 90% مقارنة بنتائج البحث التقليدية.
في الواقع، أصبح الخلاف حول مصدر بيانات التدريب أحد أهم التحديات القانونية في صناعة الذكاء الاصطناعي الحالية.
صرحت شركة OpenAI سابقًا علنًا أنه يكاد يكون من المستحيل تدريب أنظمة الذكاء الاصطناعي المتقدمة دون أي اتصال بالمحتوى المحمي بحقوق الطبع والنشر. كما أدلى نيك كليج، المدير التنفيذي السابق لشركة ميتا، ببيان مماثل، معتقدًا أنه إذا تم اتباع قواعد حقوق الطبع والنشر التقليدية بدقة، فسيكون من الصعب الحفاظ على تطوير العديد من أنظمة الذكاء الاصطناعي الحالية.
في الوقت نفسه، لا تزال العديد من الشركات، بما في ذلك Microsoft وMeta وشركات التكنولوجيا الأخرى، تواجه انتقادات من العالم الخارجي بسبب مشكلات تتعلق بمصدر بيانات التدريب. تم اتهام بعض الشركات باستخدام محتوى المستخدم ومكتبات الأكواد والمقالات والصور وغيرها من الموارد عبر الإنترنت لتدريب النماذج، غالبًا دون الحصول على إذن صريح أو تعويض من المبدعين المعنيين.
مع استمرار الدعوى القضائية المرفوعة ضد صحيفة نيويورك تايمز، يتم نشر المزيد والمزيد من الوثائق الداخلية للعامة. يعتقد المطلعون على الصناعة أن هذه المواد لا تتعلق فقط بنتيجة التقاضي بشأن حقوق الطبع والنشر التي تواجهها Microsoft وOpenAI، ولكنها قد تؤثر أيضًا على الاتجاه التنظيمي العالمي المستقبلي بشأن تدريب الذكاء الاصطناعي، وحماية الملكية الفكرية، وتوزيع حقوق ومصالح منتجي المحتوى.
في الوقت الحالي، لا تزال الحالات ذات الصلة قيد المراجعة. وبغض النظر عن الحكم النهائي، فإن هذا النزاع القانوني المحيط بشرعية التدريب على الذكاء الاصطناعي أصبح علامة فارقة مهمة في تحديد قواعد التطوير المستقبلية لصناعة الذكاء الاصطناعي.
التعليقات