الملخص:
انضم DeepSeek أيضًا إلى مسابقة المعلمات. وفقًا للمعلومات، يقوم DeepSeek حاليًا بتدريب نموذج جديد يحتوي على ما يقرب من 2 تريليون معلمة؛ صرح Liang Wenfeng أيضًا في اجتماع عقد مؤخرًا للمستثمرين أن الخطوة التالية للشركة هي مواصلة دفع النموذج إلى 8 تريليون معلمة. قبل عام مضى، كان الرقم 8 تريليونات لا يزال رقمًا لا يمكن تصوره.
ولكن الآن، وصل Kimi K3 إلى 2.8 تريليون معلمة؛ تقوم بايت بتدريب نموذج جديد مسبقًا قد يصل إلى 10 تريليون معلمة؛ صرحت علي بابا أيضًا علنًا أن نموذج الجيل التالي سيدفع نحو 5 تريليون إلى 10 تريليون معلمة. لم تكشف Anthropic عن معلمات النموذج، لكن FT نقلت سابقًا عن تقديرات الصناعة قولها إن أحدث إصدار لها من Mythos 5 يحتوي على ما يقرب من 8 تريليون معلمة.
دارت العارضة الكبيرة في دائرة وبدأت المنافسة مرة أخرى لمعرفة من هو الأكبر.
هذه المرة فقط، لم تعد المعلمات التي يطرحها الجميع هي نفس المعلمات كما في الجولة السابقة من القياس.
عندما أصدرت DeepSeek V4-Pro في أبريل من هذا العام، كان المقياس الذي تم الكشف عنه رسميًا هو 1.6 تريليون معلمة إجمالية و49 مليار معلمة تنشيط.
تبلغ خطة المتابعة 8 تريليون يوان صيني، أي ما يعادل 5 أضعاف خطة V4-Pro.
هذا أمر غير معتاد في الواقع عندما يتعلق الأمر بـ DeepSeek. بعد كل شيء، ترك DeepSeek أعمق انطباع على صناعة الذكاء الاصطناعي بأكملها في العام الماضي، وليس من حيث المعلمات.
لقد تسبب هذا في إعادة مناقشة صناعة الذكاء الاصطناعي بشأن احتمال عدم حاجة النماذج المتطورة إلى حرق وحدة معالجة الرسومات إلى ما لا نهاية.
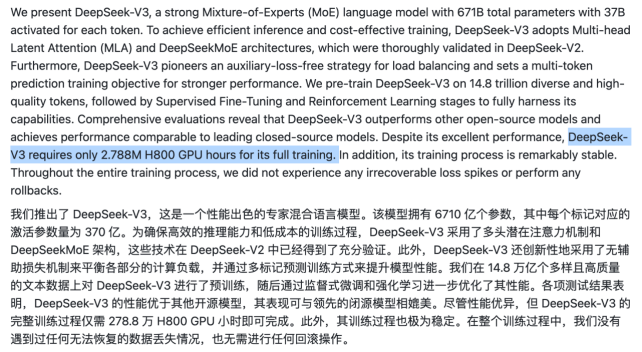
عندما يتم إصدار V3 في نهاية عام 2024، تضع DeepSeek فاتورة التدريب على الطاولة عمدًا: 671 مليار معلمة إجمالية، و37 مليار معلمة مفعلة لكل رمز مميز، ويستهلك التدريب الكامل 2.788 مليون ساعة من ساعات معالجة الرسومات H800. تم حساب تكلفة التدريب الرسمية بـ 2 دولارًا أمريكيًا لكل ساعة وحدة معالجة رسومات (GPU)، وتبلغ 5.576 مليون دولار أمريكي فقط.
أصبح هذا الرقم والكفاءة التي تقف وراءه أحد أهم التسميات الخاصة بـ DeepSeek لاحقًا.
ليس لدى DeepSeek إمدادات وفيرة من وحدات معالجة الرسوميات المتقدمة مثل OpenAI وAnthropic؛ لقد اعتمدت الشركة منذ فترة طويلة على شركة Huanfang التابعة لشركة Liang Wenfeng لتحديد حجم عمليات نقل الدم الذاتية ولا تقبل التمويل الخارجي. تحدد ظروفه مساره - نظرًا لأن المال والقدرة الحاسوبية محدودة، فيجب تعظيم الأداء من خلال الهندسة المعمارية والتدريب وكفاءة الاستدلال.
ولكن الآن تغيرت الظروف.
أكملت شركة DeepSeek للتو جولتها الأولى من التمويل الخارجي منذ إنشائها في يونيو من هذا العام، حيث جمعت ما يقرب من 7.4 مليار دولار أمريكي. وفي الوقت الحالي، دخلت الجولة الثانية من التمويل البالغة قيمتها حوالي 50 مليار يوان صيني (حوالي 7.5 مليار دولار أمريكي) مرحلة الانتهاء، وهو ما يتوافق مع تقييم يبلغ حوالي 500 مليار يوان صيني. إذا تم استكمال هذا التمويل بنجاح، فإن التمويل الخارجي التراكمي لـ DeepSeek سيقترب من 15 مليار دولار أمريكي وحوالي 100 مليار يوان في غضون بضعة أشهر.
في الوقت نفسه، قامت شركة DeepSeek بتعيين شركة CITIC Securities للتحضير للاكتتاب العام الأولي لمجلس الابتكار العلمي والتكنولوجي، وسيتم استخدام رأس المال الجديد بشكل واضح للبنية التحتية للحوسبة، وتطوير النماذج، واستثمار المواهب؛ في 21 سبتمبر، انضم يان وينتاو، الشريك السابق لشركة Hillhouse Venture Partners، رسميًا إلى DeepSeek وشغل منصب المدير المالي، منهيًا منصب المدير المالي الشاغر خلال السنوات الثلاث التي تلت تأسيس الشركة.
في الماضي، استخدم DeepSeek أموالًا محدودة وقدرة حاسوبية محدودة لجعل النموذج جيدًا قدر الإمكان؛ الآن يتم دفع التمويل والإدراج إلى الأمام. ومع وجود المزيد من الأموال في متناول اليد، يمكن أيضًا زيادة قوة الحوسبة.
بعد استيفاء الشروط، يبدأ DeepSeek أيضًا في طرح المعلمات بجرأة.
لا يتعارض هذا مع السعي لتحقيق الكفاءة. عندما تكون الكفاءة عالية، يمكن توسيع النطاق بنفس المال.
في الشهرين الماضيين، زاد مقياس المعلمات الإجمالي للنماذج المتطورة بشكل ملحوظ.
إن فيلم "الجانب المظلم من القمر" هو الذي يعيد هذه المنافسة إلى دائرة الضوء. في يوليو من هذا العام، حقق Kimi K3 2.8 تريليون معلمة إجمالية و104 مليار معلمة تنشيط. لا يزال K3 هو نموذج الوزن المفتوح مع أكبر مقياس معلمة تم إصداره رسميًا.
إنها ليست كبيرة فحسب. في التقييم الرسمي، وصل GPQA Diamond الخاص بـ K3 إلى 93.5، ووصل Terminal-Bench 2.1 إلى 88.3، وهو قريب جدًا من GPT-5.6 Sol وClaude Fable 5 في نفس الفترة. لقد وصل الحجم إلى تريليونات، ووصل الأداء إلى المستوى الأول.
في أغسطس، تم الكشف عن أن شركة Byte تخطط لتصبح أكبر.
في 6 أغسطس، كشفت "LatePost" لأول مرة أن بايت كانت تناقش تدريب نموذج جديد بأكثر من 5 تريليون معلمة، بقيادة شيانغ ليانغ، رئيس مؤسسة Seed. وفقًا للتقارير، يبدو أن بايت تعتقد داخليًا أنه بدلاً من الاستمرار في اللحاق بالحجم الحالي، من الأفضل دفع مقياس المعلمة عدة مرات أعلى من نظيراتها في وقت واحد.
بعد يوم واحد، في 7 أغسطس، ذكرت صحيفة فايننشال تايمز، نقلًا عن أشخاص مطلعين على الأمر، أن حجم النموذج الجديد الذي تم تدريبه مسبقًا بواسطة بايت قد يصل إلى 10 تريليون معلمة؛ وعندما تابعت رويترز ذلك، قارنته أيضًا مع ميثوس المتطور من Anthropic - على الرغم من أن الأخير لم يكشف أبدًا عن مقياس المعلمة، فقد وصلت تقديرات الصناعة إلى حوالي 8 تريليون. إذا وصل نموذج Byte الجديد إلى 10T، فسوف يتجاوز المقياس الذي يتم توزيعه حاليًا بواسطة Mythos.
الآن، بدأت كميات المعلمات الكبيرة للغاية التي تزيد عن 5T في الظهور بشكل متكرر في المناقشات حول النماذج المتطورة.
اليوم، أعلن وو يونغ مينغ، الرئيس التنفيذي لشركة علي بابا، علنًا أن نموذج الجيل التالي يخطط لتحقيق 5 تريليون إلى 10 تريليون معلمة؛ يقوم DeepSeek بتدريب نموذج 2T مع تحديد هدف المتابعة على 8T. يمكن أن نفهم أن المختبر الرئيسي قد اعتبر مرة أخرى مقياسًا إجماليًا أكبر للمعلمات بمثابة طريق مهم للتأثير على الحد الأعلى للقدرات.
وحتى النماذج الأمريكية المغلقة المصدر التي لا تكشف عن العوامل المتغيرة لا يمكنها الإفلات من التدقيق الخارجي. يقدر الغرباء أن أساطير الأنثروبيك بـ 8 تيرا بايت. لم تعد OpenAI تكشف عن مقياس النموذج منذ عصر GPT-4، ولكن هناك شائعة في المجتمع تفيد بأن Astra قد وصلت إلى 10T MoE.
لم يفقد عدد المعلمات جاذبيته أبدًا، تمامًا مثل قيمة القوة القتالية على لوحة اللعبة - يعرف الناس أنه لا يمكن أن يمثل كل شيء، ولكنه سيكون دائمًا الرقم الأكثر بديهية وقمعية.
في الواقع، لم تكن صناعة النماذج الكبيرة مغرمة جدًا بالحديث عن المعلمات لبعض الوقت.
في العامين الماضيين، تناوبت عمليات التقطير والنماذج الصغيرة ووزارة التعليم والتعلم المعزز وحسابات وقت الاستدلال. بدلاً من التباهي بأن لديهم مئات المليارات أو تريليونات من المعلمات، فإن مصنعي النماذج أكثر استعدادًا للحديث عن الأداء والتكلفة والكفاءة. إن مجرد جعل النموذج أكبر حجمًا سيجعله يبدو بسهولة وكأن لديك المال ولكن لا يوجد مكان لإنفاقه.
اليوم، تم رفع كميات المعلمات مرة أخرى وأصبحت مرة أخرى "واجهة" النماذج المتطورة.
ومع ذلك، لم تعد 5T و8T و10T اليوم هي نفس الشيء مثل "المزيد من المعلمات، كلما كان النموذج أكبر" في الجولة السابقة من القياس.
السبب الأكثر مباشرة وراء إمكانية وضع كميات المعلمات مرة أخرى على الطاولة هو أن البنية السائدة للنماذج الكبيرة جدًا قد تغيرت.
في الماضي، كان الاتجاه السائد في النماذج الكبيرة هو الهندسة المعمارية الكثيفة، حيث كان مقياس المعلمة ومبلغ الحساب مرتبطين معًا بشكل أساسي. ببساطة، هذا يعني عدد المعلمات الموجودة في النموذج، ويجب إدخالها معًا في كل عملية حسابية. كلما زاد عدد المعلمات، كلما ارتفع الحد الأعلى للقدرات، ولكن تكلفة التدريب والاستدلال تزداد أيضًا.
في الوقت الحاضر، تستخدم المزيد والمزيد من النماذج الكبيرة MoE، ومزيج الخبراء، والهندسة المعمارية المتخصصة المختلطة.
إنها أشبه بشركة تضم العديد من الخبراء. يمكن أن يضم النموذج مئات أو آلاف الخبراء، ولكن يتم اختيار جزء صغير منهم فقط للعمل في كل مهمة. على سبيل المثال، لدى Kimi K3 إجمالي 2.8T من المعلمات، لكن كل رمز ينشط 104B فقط، أي حوالي 3.7%؛ يحتوي DeepSeek V4-Pro على إجمالي 1.6T من المعلمات، وكل رمز ينشط 49B فقط، أي حوالي 3%.
لذلك، اليوم، إذا كان النموذج يحتوي على معلمات 5T أو 8T أو حتى 10T، فهذا لا يعني أنه يجب تشغيله من خلال معلمات 10T هذه في كل مرة يقوم فيها بإنشاء رمز مميز.
لقد أصبح المقدار الذي يمكن أن يتحمله النموذج والمقدار الذي يجب حسابه في كل مرة رقمين مختلفين.
يمكن فهم المعلمات على أنها المساحة التي يستخدمها النموذج لنقل المعرفة والأنماط والقدرات. كلما زاد إجمالي المعلمات، زادت المساحة التي يتعين على النموذج نظريًا تعلم المزيد والمزيد من التوزيعات المعقدة؛ وتسمح لها وزارة التربية بالاتصال ببعضهم فقط عند الحاجة.
ونتيجة لذلك، يمكن للنموذج الاستمرار في زيادة إجمالي سعة المعلمات دون زيادة وزن كل عملية حسابية على أساس سنوي.
مع أخذ K3 كمثال، فهو يحتوي على معلمة إجمالية تبلغ 2.8T، وهو ما يعادل حوالي ثلاثة أضعاف مقياس K2.5، ولكن من بين 896 خبيرًا، تم تنشيط 16 فقط من كل رمز. قال Dark Side of the Moon أنه بفضل MoE المتناثر وسلسلة من التحسينات المعمارية، تم تحسين كفاءة التوسع الإجمالية لـ K3 بنحو 2.5 مرة مقارنة بـ K2.
لقد أدى عصر الوكلاء إلى دفع هذه "القدرة" مرة أخرى إلى مركز المنافسة.
في الماضي، غالبًا ما كان يتم قياس قدرة Chatbot واحدًا تلو الآخر. الرياضيات تنظر إلى الرياضيات، والرمز ينظر إلى الكود، والأسئلة والأجوبة تنظر إلى المعرفة. إذا وصل النموذج إلى قمم أعلى في العديد من المعايير الرئيسية، فهذا يكفي لإثبات أنه قوي جدًا.
لكن الوكيل يجمع هذه الإمكانات في نفس سلسلة المهام. قد تبدأ مهمة طويلة حقيقية بالبحث عن المعلومات، ثم قراءة صفحات الويب، والنظر إلى الصور، وكتابة التعليمات البرمجية، والاتصال بالمحطة، ثم مواجهة الأخطاء، وتعديل الخطة، واستدعاء أدوات أخرى، وحتى تعيين مهام فرعية لوكلاء آخرين.
عندما أصدرت OpenAI واجهة Agents API في سبتمبر من هذا العام، أدرجت بشكل مباشر التشغيل طويل المدى وإدارة السياق واستخدام الأدوات وتنسيق الوكيل الفرعي باعتبارها البنية التحتية الأساسية للوكيل، وشددت على أن الوكيل يحتاج إلى التشغيل بشكل موثوق لساعات أو حتى أيام.
في الأسئلة والأجوبة، إذا فشلت قدرة معينة في بعض الأحيان، فقد يتم فقدان سؤال واحد فقط؛ في مهمة العميل التي تتضمن عشرات أو مئات الخطوات، قد يؤدي أي رابط ضعيف إلى مقاطعة الارتباط بأكمله. كلما طالت المهمة، زادت متطلبات تغطية القدرة والاستقرار. ونتيجة لهذا فإن المنافسة الحدودية بدأت تخلف تأثيراً واضحاً.
يستخدم METR الآن بشكل مباشر "الفترة الزمنية للمهمة" لقياس قدرات الوكيل، لأنه كلما طالت المهمة، زادت متطلبات النموذج لإكمال سلسلة من العمليات المختلفة بشكل مستمر.
في عصر Chatbot، من الأسهل رؤية ذروة القدرات، بينما في عصر الوكلاء، تزداد أهمية تغطية القدرات.
في هذا الوقت، تتمتع سعة المعلمة الأكبر بقيمة جديدة. كلما طالت المهمة، كلما كان النموذج أقل انحيازًا؛ كلما زاد عدد الأشياء التي يستطيع العميل القيام بها، زادت القدرات التي تحتاج القاعدة إلى تغطيتها.
تفتح وزارة التربية مجالًا لمواصلة التوسع في السعة، ويعمل الوكيل على تضخيم قيمة السعة بشكل أكبر. لذلك، يبذل مصنعو النماذج قصارى جهدهم لتحسين الكفاءة مع دفع المعلمات إلى 5T و8T و10T مرة أخرى.
لم تؤدي قوة الحوسبة المحفوظة إلى اختفاء القياس، ولكنها بدلاً من ذلك أتاحت مساحة جديدة للقياس.
التعليقات