
الملخص:
فريق أبحاث أبل يكشف عن تقدم في أبحاث "دماغ" الروبوت. في 4 نوفمبر بالتوقيت المحلي، قدم فريق أبحاث Apple ورقة بحثية بعنوان "حركة الإنسان الإدراكية من المحاكاة" على منصة ما قبل الطباعة arXiv، وكشف فيها عن نظام التحكم المستقل للروبوت البشري HALO. وقام فريق البحث بنشر النظام على الروبوت البشري G1 التابع لشركة Yushu Technology للتحقق، مما يسمح للروبوت باتخاذ الإجراءات التي تعلمها في بيئة المحاكاة وتنفيذها في غرفة واقعية غير مألوفة.
كشف فريق البحث أيضًا عن إنشاء البيانات والتدريب النموذجي وكود النشر، الذي يغطي إنشاء الإجراء وتتبع الإجراء وتنسيق المهام والمحاكاة وتشغيل الروبوت الحقيقي.
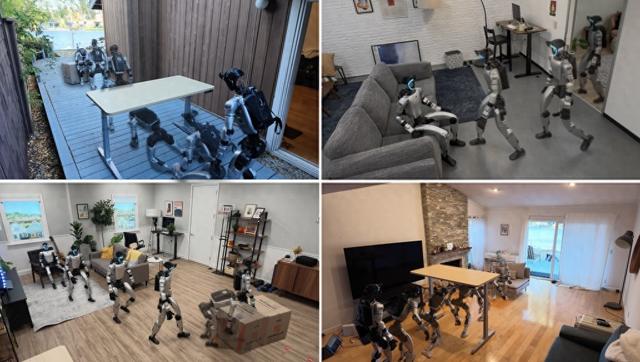
Yushu يوضح الروبوت G1 المجهز بنظام HALO مهام مثل الزحف تحت الطاولة والجلوس على الأريكة ودفع الصناديق في بيئات حقيقية مختلفة. مصدر الصورة: فريق بحث HALO
تعرض صفحة المشروع الروبوت وهو يتبع التعليمات لدفع الصناديق، ومتابعة الأشخاص، والجلوس على الكراسي، والانحناء من خلال باب نصف مفتوح، والانحناء أو الزحف تحت الطاولة، وما إلى ذلك. وتتطلب هذه المهام أن يفهم الروبوت البيئة المحيطة به وأن يضبط وضعية جسمه وفقًا للظروف المكانية.
عند تنفيذ المهام، يتم التحكم في HALO بشكل تعاوني من خلال ثلاثة مستويات. الطبقة العليا هي وحدة تنسيق المهام بناءً على نموذج اللغة المرئية (VLM). يستخدم Qianwen Qwen3.6-35B-A3B بشكل افتراضي. يتم تشغيله محليًا على جهاز Mac mini المجهز بالروبوت. إنه يشارك محرك الخدمة النموذجي مع منشئ الإجراءات ويمكنه العمل دون الحاجة إلى اتصال بالإنترنت. يمكن للنظام أيضًا اختيار استدعاء النموذج السحابي من خلال واجهة برمجة التطبيقات (API) للحصول على قدرات تفكير وتخطيط أقوى.
تحتاج هذه الطبقة إلى معالجة المعلومات الغامضة الموجودة في التعليمات وترتيب الإجراءات وفقًا للبيئة. على سبيل المثال، "الجلوس" ليس له هدف محدد بشكل واضح ويتطلب من الروبوت تحديد مكان الجلوس من المشهد أمامه؛ يمكن تنفيذ "الجلوس على كرسي" مباشرة عندما يكون المسار خاليًا، ولكن إذا كانت هناك طاولة تسد الطريق، فيجب تقسيمها إلى مهام فرعية مستمرة مثل الانحناء والاقتراب من الكرسي والجلوس. تقوم وحدة تنسيق المهام بمراقبة البيئة بشكل مستمر من خلال الفيديو من منظور الروبوت، وتحدد ما إذا كان الإجراء الحالي ناجحًا، وتقدم الخطة أو تعيد المحاولة وفقًا لذلك، وتصدر مهمة فرعية واضحة لمولد الإجراء في كل مرة.
تستخدم طبقة توليد الحركة في المنتصف نموذج Qianwen آخر Qwen3.5-2B. يستخدمه فريق البحث كجهاز تشفير لتجميد المعلمات ويتعاون مع جهاز فك تشفير DiT المسؤول عن توليد إجراءات لتخطيط حركات الجسم بالكامل لمدة 5 ثوانٍ تقريبًا في المستقبل بناءً على الصور التي شاهدها الروبوت والمهمة الفرعية الحالية. يتم إعادة تخطيط هذه الطبقة حوالي ثلاث مرات في الثانية، مما يسمح بتحديث خطة العمل بشكل مستمر مع تغير البيئة.
الطبقة السفلية عبارة عن أداة تتبع الإجراءات التي تم تدريبها من خلال التعلم المعزز وتقطير السياسات وخطوات أخرى. ويعمل بتردد 50 مرة في الثانية، ويجمع بين الصور العميقة وحالة الروبوت الخاصة، ويحول خطط العمل إلى تعليمات تحكم مشتركة.
المستويات الثلاثة مسؤولة على التوالي عن ترتيب المهام وتخطيط العمل والتحكم في الجسم، وتكمل العملية بشكل تعاوني بدءًا من فهم التعليمات وحتى تنفيذ الإجراءات.
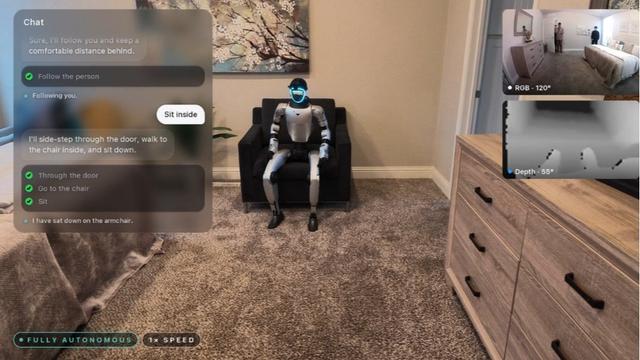
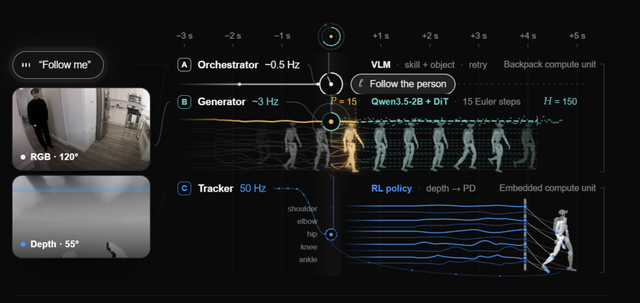
بنية التحكم ثلاثية الطبقات لـ HALO: نموذج اللغة المرئية مسؤول عن تنسيق المهام، ووحدة التوليد تخطط لحركات الجسم بالكامل، ويقوم متتبع الحركة المدرب من خلال التعلم المعزز بالتحكم المشترك. مصدر الصورة: فسيفساء من لقطات الشاشة من صفحة مشروع HALO
وفقًا للورقة البحثية، أجرى فريق البحث 360 اختبارًا بمهمة واحدة في 6 بيئات حقيقية دون إجراء مسح مسبق أو رسم خرائط، بمعدل نجاح متوسط قدره 91%. وفي بيئة حقيقية أخرى، تم إجراء 10 اختبارات على ثلاث مهام مجتمعة، وكان متوسط نسبة النجاح 70%. ومن بينها نسبة نجاح الجمع بين "الانحناء فوق العائق - المشي نحو الهدف - دفع الصندوق" هي 50٪.
كيفية حصول الروبوتات على البيانات اللازمة لإكمال هذه المهام هو محور هذا البحث. قام فريق البحث بتجميع حوالي 300 ساعة من بيانات التدريب الأولية في 1000 بيئة منزلية محاكاة تم إنشاؤها بواسطة برنامج لمطابقة "ما رآه الروبوت" و"التعليمات التي تلقاها" و"كيفية التحرك".
على وجه التحديد، يقوم النظام أولاً بإنشاء الإجراءات، ثم يضع الإجراءات في الغرفة الافتراضية، وفي النهاية يقوم بإنشاء صور من منظور الروبوت. تأخذ صفحة المشروع "الجلوس على كرسي بذراعين" كمثال، وتقسمه إلى أجزاء مثل المشي للأمام، والالتفاف، والجلوس. يقوم نموذج توليد الإجراء بإنشاء تسلسلات إجراءات بناءً على المطالبات النصية ونقاط الطريق والمواقف الرئيسية. يتم بعد ذلك فحص الإجراءات من خلال فحوصات هندسية لتقليل المشكلات مثل انزلاق القدم واختراق الجسم للأرض.
بعد ذلك، يقوم النظام بترتيب الإجراءات في الغرفة التي أنشأها البرنامج، والتحقق من العلاقة الموضعية بين الروبوت والأثاث، والبحث عن خطة وضع خالية من الاصطدام، ثم يستخدم أدوات المحاكاة لعرض ما يراه الروبوت عندما ينفذ الإجراء. أثناء التدريب، سيتم أيضًا تغيير الظروف مثل الإضاءة ودرجة اللون وضبابية الصورة لجعل المدخلات المرئية أكثر تنوعًا. وبهذه الطريقة، يمكن لنفس العملية إنشاء بيانات داعمة بما في ذلك التعليمات والصور المرئية وحركات الجسم بالكامل.
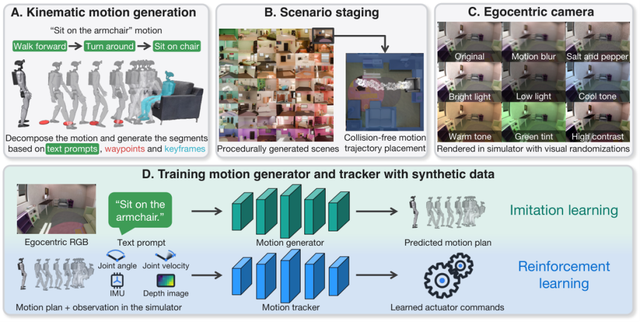
عملية توليد البيانات الاصطناعية والتدريب الخاصة بـ HALO: قم أولاً بإنشاء مسار عمل، ووضعه في المشهد الافتراضي، ثم عرض الصورة من منظور الروبوت لتشكيل بيانات تدريب داعمة لتدريب مولد الإجراء ومتتبع الإجراء. مصدر الصورة: ورق HALO
وفقًا للتقارير، استخدم فريق البحث 250 وحدة معالجة رسوميات NVIDIA H100 واستغرق تجميع بيانات التدريب الرئيسية حوالي 48 ساعة. يتم تدريب مولد الحركة من خلال التعلم بالتقليد، باستخدام 64 B200s؛ يتم تدريب متتبع الإجراء من خلال التعلم المعزز وتقطير السياسات وخطوات أخرى باستخدام 4 H100s.
تجدر الإشارة إلى أن البيانات الناتجة عن المحاكاة لا تتخلص تمامًا من المشاركة البشرية. وذكر الفريق أن المهام المادية الجديدة لا تزال تتطلب الكتابة اليدوية للكلمات السريعة وتصميم الإطارات الرئيسية للعمل، كما تستخدم بعض الإجراءات أيضًا الفيديو البشري أو مواد التقاط الحركة.
وأشار فريق البحث أيضًا إلى أن الروبوتات حاليًا تعتمد بشكل أساسي على الإدراك البصري ومن الصعب إدراك حالات الاتصال بشكل مباشر؛ عندما تخرج الكائنات من مجال رؤية الكاميرا أو يتم حجبها، فإن أداء المهام التي تتضمن المزيد من جهات الاتصال سوف ينخفض. تعد إضافة الإدراك اللمسي أحد اتجاهات التحسينات اللاحقة.
التعليقات